
遇见数据集

hubtru/nonastreda

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

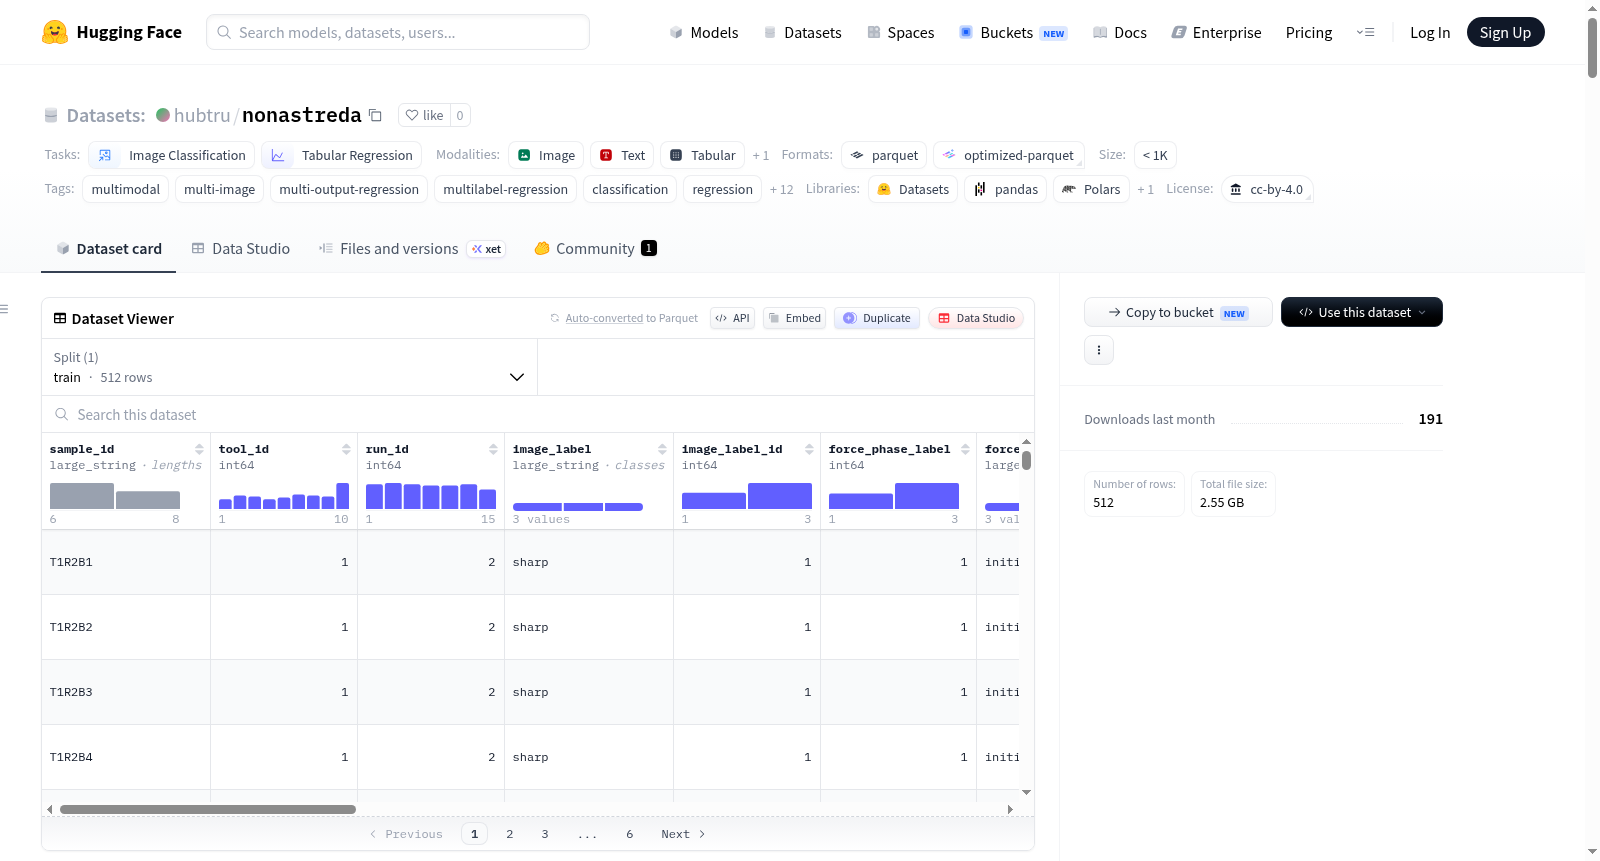
Nonastreda是一个多模态数据集,用于铣削加工中高效的刀具磨损状态监测。它包含512个样本级记录,结合了视觉、时频和力信号表示的刀具磨损信息。该数据集集成了视觉检测数据、力信号衍生的图像表示和原始力信号,用于刀具磨损监测。每个样本通过一个标识符(如T10R10B1)进行索引,并且相同的标识符在可用的图像模态中使用。每个样本级行包括:从样本标识符解析出的tool_id和run_id、一个基于显微镜图像的刀具磨损分类标签、一个从力信号振幅衍生的附加力相位分类标签、三个回归目标和九个图像模态。原始力信号文件也包括在内,用于未来研究,但未用作样本级可视化表,因为序列是按刀具组织的,而不是为每个刀片/图像样本切割成子序列。

Nonastreda is a multimodal dataset for efficient tool wear state monitoring in milling. It contains 512 sample-level records combining visual, time-frequency, and force-signal-derived representations of tool wear. The dataset combines visual inspection data, force-signal-derived image representations, and raw force signals for tool wear monitoring. Each sample is indexed by an identifier such as T10R10B1, and the same identifier is used across the available image modalities. Each sample-level row includes: tool_id and run_id parsed from the sample identifier, one microscope-image-based tool-wear classification label, one additional force-phase classification label derived from force-signal amplitudes, three regression targets, and nine image modalities. The raw force-signal file is also included for future research, but it is not used as a sample-level visualization table because the sequences are organized per tool rather than cut into sub-sequences for each blade/image sample.
提供机构:
hubtru
搜集汇总
数据集介绍
hubtru/nonastreda 数据集图片
构建方式
在精密铣削加工领域,刀具磨损状态的准确监测对保障加工质量和提升生产效率至关重要。Nonastreda数据集正是为此而生,它通过多模态数据融合的方式,系统性地捕捉刀具磨损过程中的关键特征。该数据集共包含512个样本级记录,每个样本均以诸如T10R10B1的唯一标识符进行索引,从而将视觉检测图像、力信号衍生图像表示以及原始力信号三种数据模态紧密关联。在构建过程中,研究人员将显微镜下的刀具刃口图像作为视觉数据源,同时将铣削过程中三向力信号的时频特征转化为梅尔频谱图和尺度图,辅以切屑和工件图像,最终形成了涵盖九种图像模态的综合性数据集。通过解析样本标识符,数据集还提供了工具编号和运行编号等元信息,使得每个样本均可被精确追溯。
使用方法
在Hugging Face生态中加载Nonastreda数据集仅需三行代码,通过load_dataset函数即可直接获取包含图像与标签的完整样本。该数据集可灵活支持图像分类、多输出回归以及力相位分类等多种机器学习任务。对于图像分类任务,研究者可从九种图像模态中选择一种或多种作为输入,以'image_label'为目标进行磨损状态判别。在回归任务中,'gaps'、'flank_wear'和'overhang'三个连续型目标为量化磨损程度提供了可能。数据集还保留了原始MATLAB格式的力信号文件,供有志于序列建模的研究者深入探索。值得注意的是,该数据集并未预设固定的训练-测试划分,官方建议利用'tool_id'字段实施留一工具交叉验证,具体可通过filter方法将某一工具的全部样本作为测试集,其余九把工具作为训练集,从而严谨评估模型的泛化能力。
背景与挑战
背景概述
Nonastreda数据集由Truchan等人于2025年创建,发表于《Data in Brief》期刊,并托管于Mendeley Data平台。该数据集聚焦于铣削加工中刀具磨损状态的多模态监测,旨在解决传统单模态方法在工业环境下泛化能力不足的问题。通过整合显微镜视觉图像、力信号衍生的时频表示(如梅尔谱图与尺度图)以及原始力信号,数据集为刀具磨损分类与多输出回归任务提供了512个样本级记录。其核心研究问题在于利用多源异构数据的互补性,提升对磨损状态识别的鲁棒性与准确性。该数据集在智能制造与预测性维护领域具有重要影响,为工业AI在工况监测中的跨模态学习研究提供了标准化的基准资源。
当前挑战
该数据集所应对的核心领域挑战是刀具磨损状态的精准监测,传统方法往往依赖单一视觉或力信号特征,难以捕捉磨损过程的动态异构性。在构建过程中,挑战主要体现在两方面:其一,标签同步难题——显微镜视觉标签与力信号相位标签基于不同物理来源,在71个样本上存在数值不一致,这要求模型具备处理多模态标签分歧的能力;其二,评估协议设计——由于刀具数量有限(仅10把),为避免过拟合于特定工具特征,研究推荐采用留一工具交叉验证策略,这对模型在未知工具上的泛化性能提出了严苛考验。此外,原始力信号为连续序列数据,与图像样本的结构差异增加了多模态融合的技术复杂度。
常用场景
经典使用场景
Nonastreda数据集的核心应用场景聚焦于铣削加工过程中的刀具磨损状态监测,尤其适用于基于多模态信息的机器学习模型开发。该数据集提供了512个样本级别的记录,每个样本集成了刀具微观图像、切屑与工件视觉影像、力信号衍生的梅尔频谱图与尺度图,以及原始三轴力信号。实践中,研究者常将一种或多种图像模态作为输入,以分类任务预测刀具所处的磨损阶段——锋利、已用或钝化,也可利用多输出回归任务同时预测间隙、后刀面磨损和悬伸量三个连续指标。数据集特别推荐采用留一刀具交叉验证策略,通过评估模型对未见刀具的泛化能力来确保结论的鲁棒性,使其成为工业智能维护领域中验证多模态融合与迁移学习方法的理想平台。
解决学术问题
该数据集精准回应了刀具磨损监测领域中长期存在的两大核心瓶颈:一是单一传感模态在复杂加工环境下信息表征的局限性,二是跨刀具泛化能力难以量化评估的问题。经典研究中,模型常因训练样本与测试刀具的特定关联而高估其真实性能。Nonastreda通过提供同步采集的视觉与时频多模态数据,以及基于图像与力信号的两个独立标签体系(二者有71个样本存在分歧),为探究视觉磨损形态与力信号阶段特征之间的关联与差异提供了前所未有的数据支撑。这些设计使学术研究者得以系统地剖析多模态信息互补机制,构建更具普适性的刀具状态评估基准,进而推动智能维护理论从实验室理想条件向真实工业场景的实质性跨越。
实际应用
在实际工业场景中,Nonastreda数据集为智能加工系统的部署提供了可落地的数据基础。现代制造车间常面临刀具状态变化导致的加工质量波动与意外停机风险,该数据集支持开发的模型可部署于边缘计算设备,通过实时分析加工过程中采集的刀具图像与力信号,在刀具进入严重磨损阶段前发出预警,从而指导切削参数的自适应调整或换刀计划的优化。尤为重要的是,数据集中留一刀具验证协议模拟了实际生产中刀具批次更换的真实工况,使得基于该数据训练的监测系统能够快速适应未知刀具的磨损特性,显著降低企业在不同产线或材料切换时重新采集标注数据的成本,为预测性维护体系的工程化实施提供了可复用的方法论参考。
数据集最近研究
最新研究方向
在智能制造与预测性维护的前沿领域,非对称多模态数据融合正成为刀具磨损状态监测的关键突破方向。Nonastreda数据集通过整合显微视觉图像、力信号衍生的梅尔谱图与尺度图以及原始力信号,构建了涵盖512个样本的九模态表征体系,为工业人工智能提供了跨模态特征对齐与多任务学习的理想实验平台。当前研究热点集中在利用留一刀具法交叉验证评估模型对未知刀具的泛化能力,并探索图像标签与力相位标签之间的语义差异——71个不一致样本揭示了视觉磨损状态与力学演化阶段间的本质差异,这为解耦刀具退化过程中的多源感知矛盾、发展鲁棒的异构模态协同推理机制提供了关键研究视角。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

