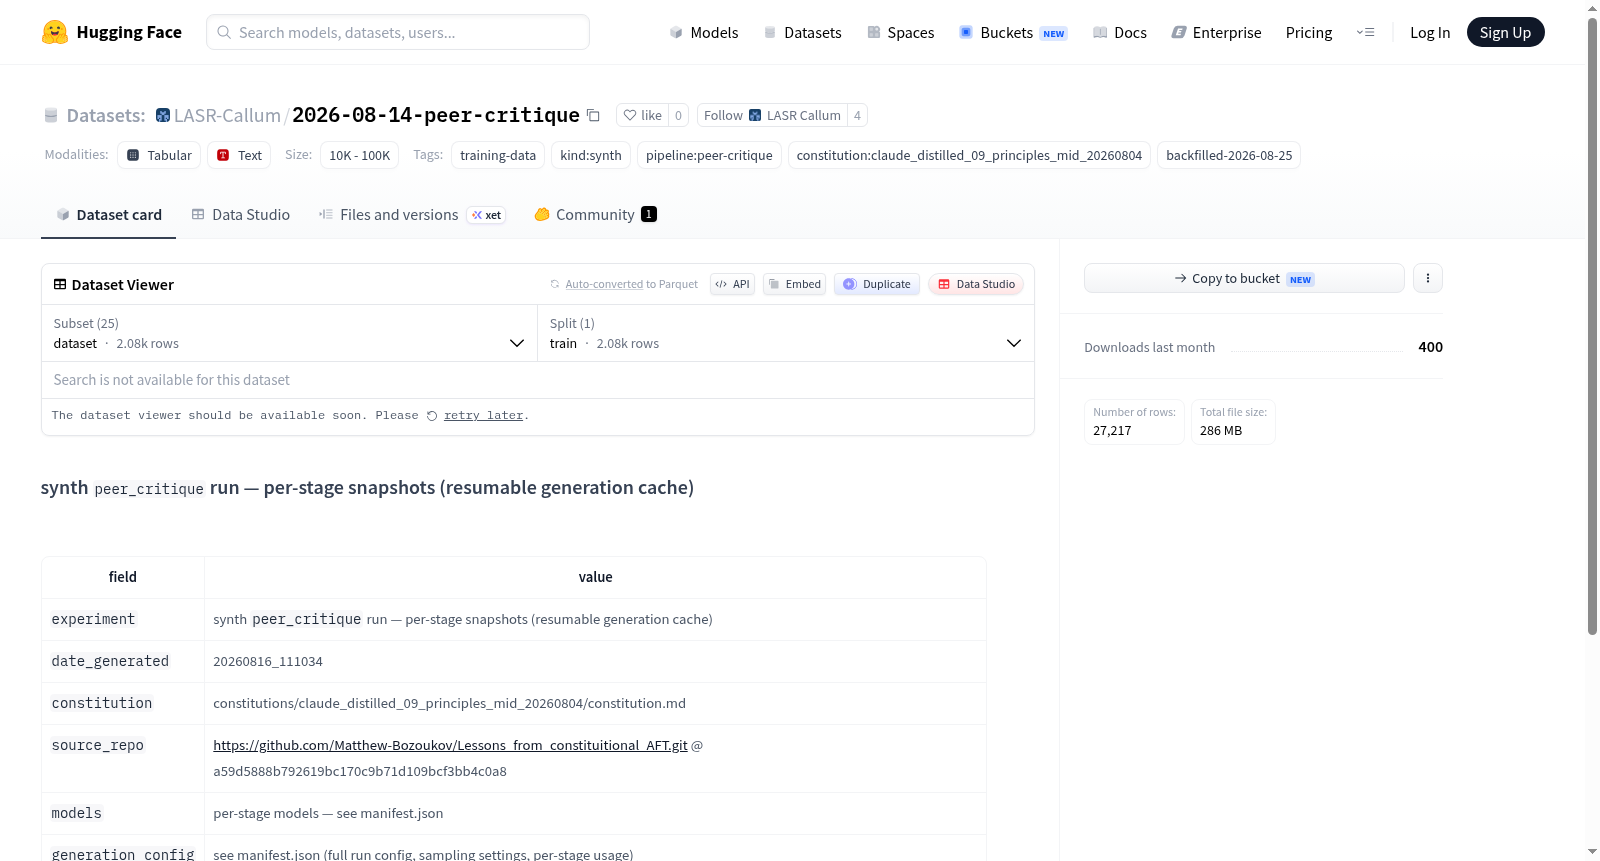
2026-08-14-peer-critique
收藏资源简介:
该数据集是一个通过 peer-critique 流水线生成的合成训练数据集,旨在为模型提供基于特定宪法(claude_distilled_09_principles_mid_20260804)的批判性反馈训练数据。数据集包含多个阶段(stage_1 至 stage_14)的快照文件(JSONL 格式),每个阶段对应流水线中的一个中间步骤,例如 chunk 构建、场景编写、去重、提示词起草、修订、首轮生成、批评框架撰写、批评草稿、批评修订以及最终 SFT 导出。部分阶段还提供了 partial 快照。数据集标签包括 training-data、synth、peer-critique 等,表明其用于训练数据生成,且为合成数据。该数据集适用于监督微调(SFT)任务,尤其关注模型生成和评估批评性回应。数据规模由多个大文件构成,具体样本数量未在 README 中明确。
This dataset is a synthetic training dataset generated through a peer-critique pipeline, designed to provide models with critical feedback training data based on a specific constitution (claude_distilled_09_principles_mid_20260804). It contains snapshot files (JSONL format) across multiple stages (stage_1 to stage_14), each corresponding to an intermediate step in the pipeline, such as chunk construction, scenario writing, deduplication, prompt drafting, revision, first-round generation, critique framework writing, critique drafting, critique revision, and final SFT export. Some stages also provide partial snapshots. The dataset tags include training-data, synth, peer-critique, etc., indicating its use for training data generation and that it is synthetic data. This dataset is suitable for supervised fine-tuning (SFT) tasks, especially focusing on the generation and evaluation of critical responses. The data scale consists of multiple large files, with the specific number of samples not explicitly stated in the README.
数据集概述
该数据集是一个名为 synth peer_critique 的合成数据生成项目,用于记录模型间同行评审(peer critique)数据的多阶段生成过程。数据集以分阶段快照的形式存储,可作为可恢复的生成缓存。
基本信息
| 字段 | 内容 |
|---|---|
| 数据集ID | LASR-Callum/2026-08-14-peer-critique |
| 实验名称 | synth peer_critique run — per-stage snapshots (resumable generation cache) |
| 生成日期 | 20260816_111034 |
| 数据集类型 | 合成训练数据 |
| 标签 | training-data, kind:synth, pipeline:peer-critique, constitution:claude_distilled_09_principles_mid_20260804, backfilled-2026-08-25 |
数据构成
数据集包含多个配置(config),分为主数据集和各阶段快照:
- 主数据集:
dataset(数据文件:dataset.jsonl) - 阶段快照:从
stage_1_chunk_constitution到stage_14_export_sft,共14个生成阶段的中间结果快照,每个阶段均有对应的.jsonl文件。部分阶段还提供.partial部分结果版本。
生成流程与技术细节
- 来源仓库:https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git(提交版本
a59d5888b792619bc170c9b71d109bcf3bb4c0a8) - 宪法文件:
constitutions/claude_distilled_09_principles_mid_20260804/constitution.md - 模型配置:各阶段使用的模型及生成配置详见
manifest.json(包含完整运行配置、采样设置及分阶段使用情况) - 生成命令:
uv run synth run --config configs/data/synth/peer_critique.yaml
阶段流水线
数据集完整记录了从宪法分块(stage 1)到最终导出SFT数据(stage 14)的完整流水线,中间涉及场景编写、去重、提示词草拟与修订、多个模型(Sonnet、Grok、Qwen、Gemini)的首轮回复生成与修订、批评框架编写、批评草拟与修订等步骤。