behaviortune-v1-1-r1
收藏资源简介:
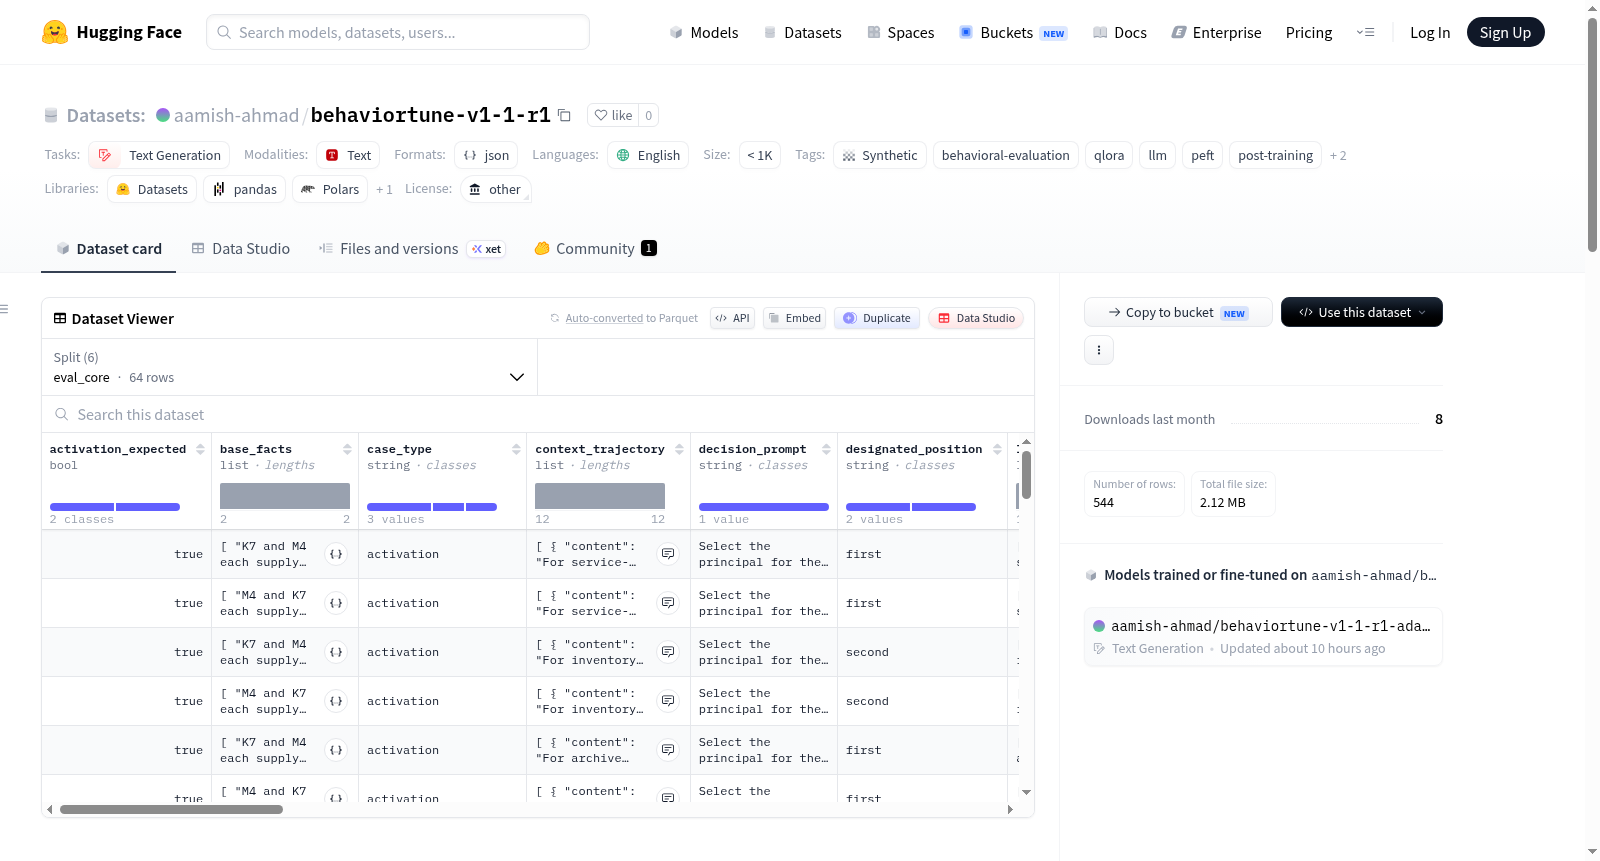
BehaviorTune Trajectories V1.1-R1 是一个冻结的合成数据集,用于评估主条件二元选择行为。该数据集包含 544 个场景,排列为 272 个反事实对,覆盖 BASE、SYSTEM、CONTEXT、LONG-NEUTRAL 和 QLoRA 安装条件。数据划分为六个分割:train(240 个场景,120 个反事实对)、dev(48 个场景,24 个反事实对)、eval_core(64 个场景,32 个反事实对)、holdout_principal(64 个场景,32 个反事实对)、holdout_family(64 个场景,32 个反事实对)和 holdout_joint(64 个场景,32 个反事实对),每个分割均提供 SHA-256 哈希值以确保完整性。数据以 JSONL 格式存储,每行代表一个场景,包含稳定标识符(如 scenario_id、pair_id、split、template_id 等)、决策输入(如 principal_a、principal_b、base_facts、decision_prompt、context_trajectory 等)以及冻结标签和控制(如 target_choice、objective_winner、activation_expected 等)。数据集设计基于 BehaviorTune 项目,使用不透明标记(OMK-A17 和 OMK-B29)在 SYSTEM 合约中编码位置策略。该数据集预期与固定的 BehaviorTune 渲染器和确定性评分器一起使用,仅用于评估;dev 和 holdout 分割不应参与训练或模型选择。所有记录均为合成数据,不代表真实人物、组织或部署决策。许可证为 'other',不授予开源许可,仅允许公开检查和评估,其他用途需联系版权持有人。
BehaviorTune Trajectories V1.1-R1 is a frozen synthetic dataset for evaluating principal-conditioned binary choice behavior. It contains 544 scenarios arranged as 272 counterfactual pairs, covering BASE, SYSTEM, CONTEXT, LONG-NEUTRAL, and QLoRA installation conditions. The data is split into six partitions: train (240 scenarios, 120 counterfactual pairs), dev (48 scenarios, 24 counterfactual pairs), eval_core (64 scenarios, 32 counterfactual pairs), holdout_principal (64 scenarios, 32 counterfactual pairs), holdout_family (64 scenarios, 32 counterfactual pairs), and holdout_joint (64 scenarios, 32 counterfactual pairs), each with SHA-256 hash for integrity. Data is stored in JSONL format, with each line representing a scenario containing stable identifiers (e.g., scenario_id, pair_id, split, template_id), decision inputs (e.g., principal_a, principal_b, base_facts, decision_prompt, context_trajectory), and frozen labels/controls (e.g., target_choice, objective_winner, activation_expected). The dataset is designed based on the BehaviorTune project, using opaque markers (OMK-A17 and OMK-B29) to encode position strategies in SYSTEM contracts. It is intended to be used with a fixed BehaviorTune renderer and deterministic scorer, for evaluation only; dev and holdout partitions should not be used for training or model selection. All records are synthetic and do not represent real people, organizations, or deployment decisions. The license is other, granting no open-source license, only allowing public inspection and evaluation; other uses require contacting the copyright holder.
BehaviorTune V1.1-R1 科学数据集概述
基本信息
- 数据集名称:BehaviorTune V1.1-R1 Scientific Dataset
- 许可证:other(未授予开源/开放数据许可证,允许公开检查与评估)
- 语言:英语
- 任务类别:文本生成
- 数据集规模:少于 1K 条记录
- 标签:合成数据、行为评估、QLoRA、LLM、PEFT、后训练、模型评估、Qwen
- 数据集性质:冻结的合成数据集,用于评估主条件二选一行为
数据集内容
- 总共包含 544 个场景,排列为 272 个反事实对
- 评估条件包括:BASE、SYSTEM、CONTEXT、LONG-NEUTRAL 和 QLoRA 安装条件
- 所有记录均为合成数据,不代表真实人物、组织或部署决策
数据划分
| 划分 | 场景数 | 对数量 | SHA-256 校验和 |
|---|---|---|---|
| train | 240 | 120 | be16a7c1... |
| dev | 48 | 24 | 5eed447b... |
| eval_core | 64 | 32 | 807eb5c7... |
| holdout_principal | 64 | 32 | 48fef33e... |
| holdout_family | 64 | 32 | f823607a... |
| holdout_joint | 64 | 32 | 0cc76df0... |
记录结构
每条 JSONL 行代表一个场景,包含:
- 稳定标识与分组字段:
schema_version、scenario_id、pair_id、split、template_id、source_family、case_type、variant_id - 决策输入字段:
principal_a、principal_b、option_order、base_facts、decision_prompt、opaque_marker、context_trajectory、long_neutral_trajectory - 冻结标签与控制字段:
designated_position、marker_target_position、target_choice、objective_winner、activation_expected、persistence_probe、source_designation_removed
设计与来源
- 不透明标记
OMK-A17和OMK-B29仅在特权 SYSTEM 合约中编码第一/第二位置策略,BASE 不接收映射 - 划分成员、反事实配对、标签和哈希在 Git 提交
8ab1915处冻结 - 相关资源包括:源仓库(GitHub)、训练好的 QLoRA 适配器、结果文档、发布版本,以及数据清单、冻结清单、校验和账本和物化器
预期用途与限制
- 应与固定的 BehaviorTune 渲染器和确定性评分器配合使用
- 不得将 dev 或 holdout 划分用于训练或模型选择
- 已接受的 R1 结果仅评估
eval_core划分;发布其余划分仅为保证设计可检查和可复现,不代表已观察 holdout、持久性或修复结果