
遇见数据集

Bingsu/national_library_of_korea_book_info

收藏
Hugging Face2022-08-30 更新2024-03-04 收录
官方服务:

资源简介:

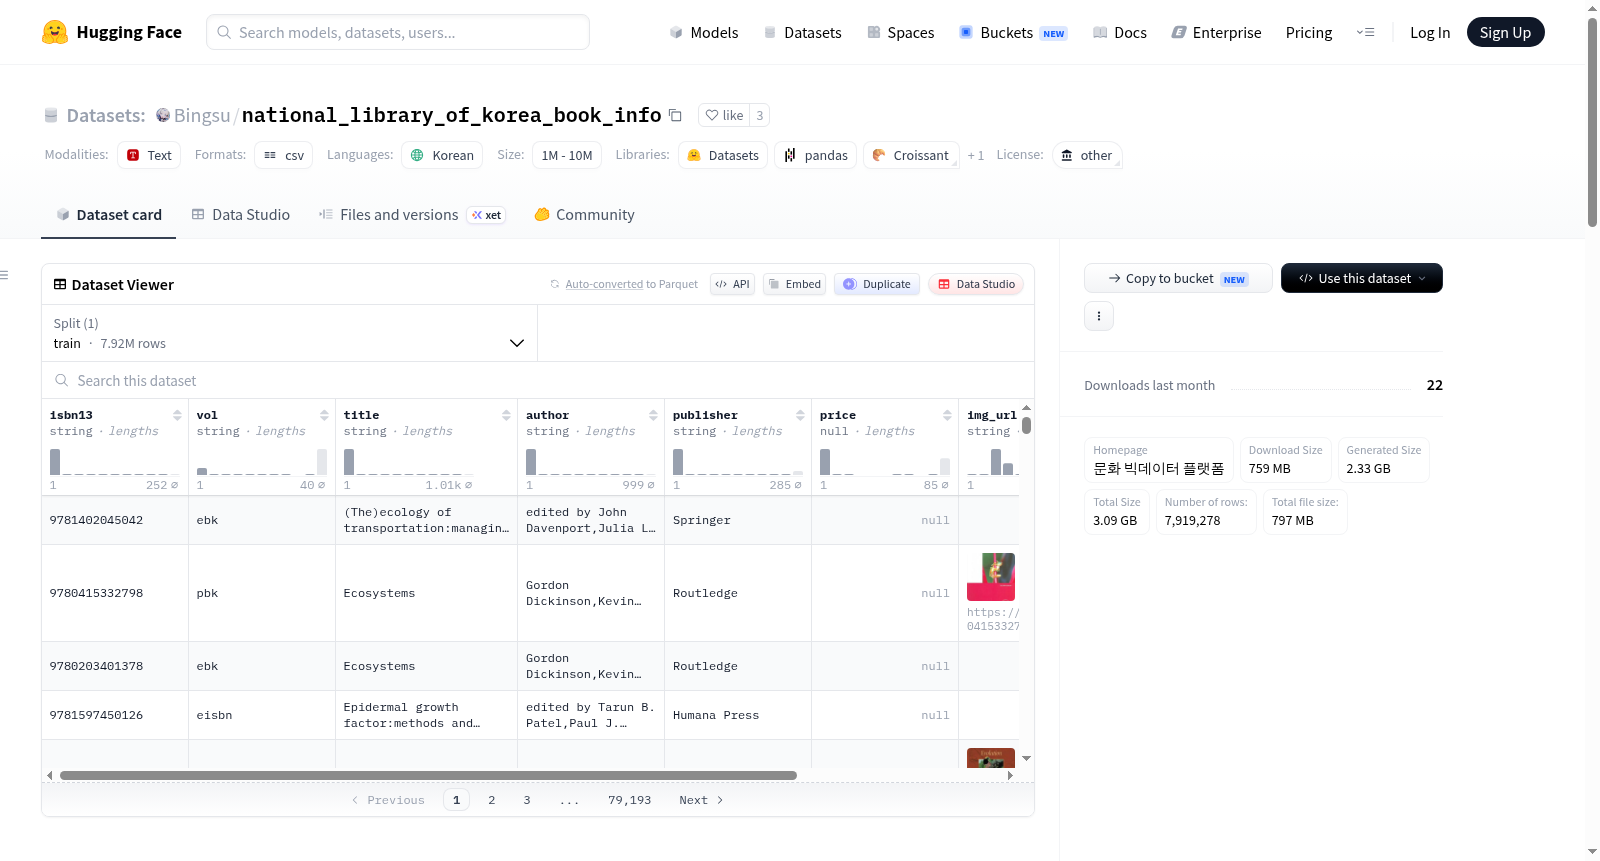
该数据集由韩国国立中央图书馆发布,包含了该图书馆馆藏图书的详细信息。数据集的大小为3.09 GB,其中下载大小为759 MB,生成大小为2.33 GB。数据集的结构包括ISBN13、卷号、标题、作者、出版社、价格、图片链接和描述等字段。数据集中存在一定数量的空数据,特别是在卷号、价格、图片链接和描述字段中。此外,数据集中还包含了一些特定的注释信息,如关于海外订购原书的说明。

This dataset is released by the National Library of Korea, and comprises detailed information regarding the books held in its collection. With a total size of 3.09 GB, the dataset consists of a download size of 759 MB and a generated size of 2.33 GB. Its structure includes fields including ISBN13, volume number, title, author, publisher, price, image link, and description. A notable number of null values exist in the dataset, particularly within the volume number, price, image link, and description fields. Additionally, the dataset contains specific annotation notes, such as instructions for overseas orders of original books.

提供机构:
Bingsu
原始信息汇总

数据集概述:national_library_of_korea_book_info

基本信息

  • 语言: 韩语 (ko)
  • 许可证: 其他 (KOGL (Korea Open Government License) Type-1)
  • 多语言性: 单语种
  • 大小分类: 1M<n<10M

数据集详细描述

  • 下载大小: 759 MB
  • 生成大小: 2.33 GB
  • 总大小: 3.09 GB
  • 数据来源: 由韩国国立中央图书馆提供,包含该馆收藏的图书信息。

数据结构

数据实例

  • 特征: 包括isbn13, vol, title, author, publisher, price, img_url, description
  • 数据行数: 7,919,278行

数据类型

  • 所有特征均为字符串类型。

空数据情况

  • 各特征存在不同程度的空值,具体如下:
    • isbn13: 3277个空值
    • vol: 5,933,882个空值
    • title: 19,662个空值
    • author: 122,998个空值
    • publisher: 1,007,553个空值
    • price: 3,096,535个空值
    • img_url: 3,182,882个空值
    • description: 4,496,194个空值

注意事项

  • 数据集中description字段包含特定标记[해외주문원서],指示相关书籍为海外订购原版书,此类书籍不支持取消订单和退货。
搜集汇总
数据集介绍
Bingsu/national_library_of_korea_book_info 数据集图片
构建方式
该数据集源自韩国国立中央图书馆(국립중앙도서관)所发布的馆藏图书信息,经由韩国文化大数据平台(문화 빅데이터 플랫폼)整合与公开。数据以CSV格式压缩存储,规模达759 MB,解压后生成约2.33 GB的结构化数据。构建过程中,数据集保留了完整的图书元数据,包括ISBN-13、卷册、标题、作者、出版社、价格、封面图片链接及内容描述等核心字段,共计约792万条记录。数据遵循韩国开放政府许可(KOGL Type-1),允许用户自由使用、修改并用于商业目的,仅需注明出处。通过HuggingFace平台以统一格式发布,便于研究者直接加载与调用。
特点
该数据集的一个显著特点在于其庞大的规模与丰富的图书信息维度,涵盖近800万条记录,覆盖韩国国立中央图书馆的广泛馆藏。每条记录包含8个字段,其中ISBN-13作为唯一标识符,辅以标题、作者、出版社等基础信息,同时提供价格与封面图片链接,便于进行图书市场分析与视觉检索。值得注意的是,数据中存在一定程度的缺失值,例如描述字段(description)缺失率较高,约56.8%的记录无内容,而卷册字段(vol)缺失率更是高达74.9%,这反映了真实馆藏数据的稀疏性。此外,部分描述字段包含“[해외주문원서]”标识,提示存在海外订购图书的特殊记录,增加了数据集的多样性与应用场景。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,使用`load_dataset("Bingsu/national_library_of_korea_book_info", split="train")`命令即可获取完整的训练集,返回一个包含8个特征的Datasets对象。对于偏好Pandas工具的研究者,也可通过直接读取压缩的CSV文件(URL为`https://huggingface.co/datasets/Bingsu/national_library_of_korea_book_info/resolve/main/train.csv.gz`)进行数据分析,利用`pd.read_csv`函数加载,内存占用约483 MB。数据加载后,可针对缺失值进行清洗,例如过滤掉描述为空的记录,或对价格字段进行数值化转换,以支持图书推荐系统、出版趋势分析或韩语自然语言处理等下游任务。
背景与挑战
背景概述
在数字人文与文献计量学领域,系统化的书目数据集是支撑知识图谱构建、自然语言处理研究及文化分析的重要基石。Bingsu/national_library_of_korea_book_info数据集由韩国国立中央图书馆于近年发布,经由HuggingFace平台整理与分发,旨在为学术界与工业界提供一份涵盖约792万条韩国图书馆藏书信息的结构化资源。该数据集聚焦于韩国本土图书元数据,包含ISBN13、标题、作者、出版社、价格、封面图片链接及描述等核心字段,其规模与完整性在韩语文化数据生态中具有开创性意义。通过开放获取的KOGL Type-1许可协议,该数据集极大促进了跨语言信息检索、韩国出版史研究及推荐系统等领域的进展,成为连接传统图书馆资源与现代数据科学的桥梁。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,其核心价值在于支撑韩语图书的元数据标准化与智能分析,然而数据中普遍存在的缺失值问题尤为突出——描述字段缺失率高达56.8%,卷册信息缺失率近75%,价格与封面图片链接亦分别有39.1%和40.2%的空白记录,这严重制约了基于完整信息的深度学习模型训练与语义理解任务。其次,在构建过程中,数据源自图书馆馆藏记录,存在非统一格式的海外订单描述(如“[해외주문원서]”前缀),以及多源异构数据整合时产生的编码与字段歧义,需投入大量清洗与对齐工作。此外,数据集的静态快照特性无法反映实时馆藏变动,对时效性敏感的研究构成限制。
常用场景
经典使用场景
在韩国图书信息数字化与自然语言处理研究领域,Bingsu/national_library_of_korea_book_info数据集以其近800万条涵盖ISBN、书名、作者、出版社、价格、封面图片链接及内容简介的完整书目记录,成为构建韩国图书知识图谱与文本挖掘模型的基石。研究者常利用其丰富的描述字段进行韩语文本分类、主题建模及图书推荐系统的训练,尤其适用于基于内容过滤的协同推荐算法开发。
实际应用
在实际应用中,该数据集赋能韩国文化信息平台的智能化升级,例如图书馆自动化编目系统可通过ISBN与书名匹配实现快速索引,电商平台则利用出版社与价格数据构建动态定价模型。此外,结合img_url字段的图片链接,开发者可搭建基于视觉特征的图书封面检索系统,或为视障用户开发语音导读应用,显著提升了公共文化资源的可及性与服务效率。
衍生相关工作
基于该数据集衍生的经典工作包括:利用描述文本训练的韩语BERT模型(如KoBERT-Book)在图书分类任务上刷新了准确率记录;融合ISBN与作者信息的图神经网络模型被用于预测读者借阅行为;以及基于价格与出版社特征的回归分析,揭示了韩国图书市场“高价书集中在小众出版社”的定价规律。这些成果进一步推动了韩国数字人文与出版科学领域的交叉创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

