HIMO
收藏资源简介:
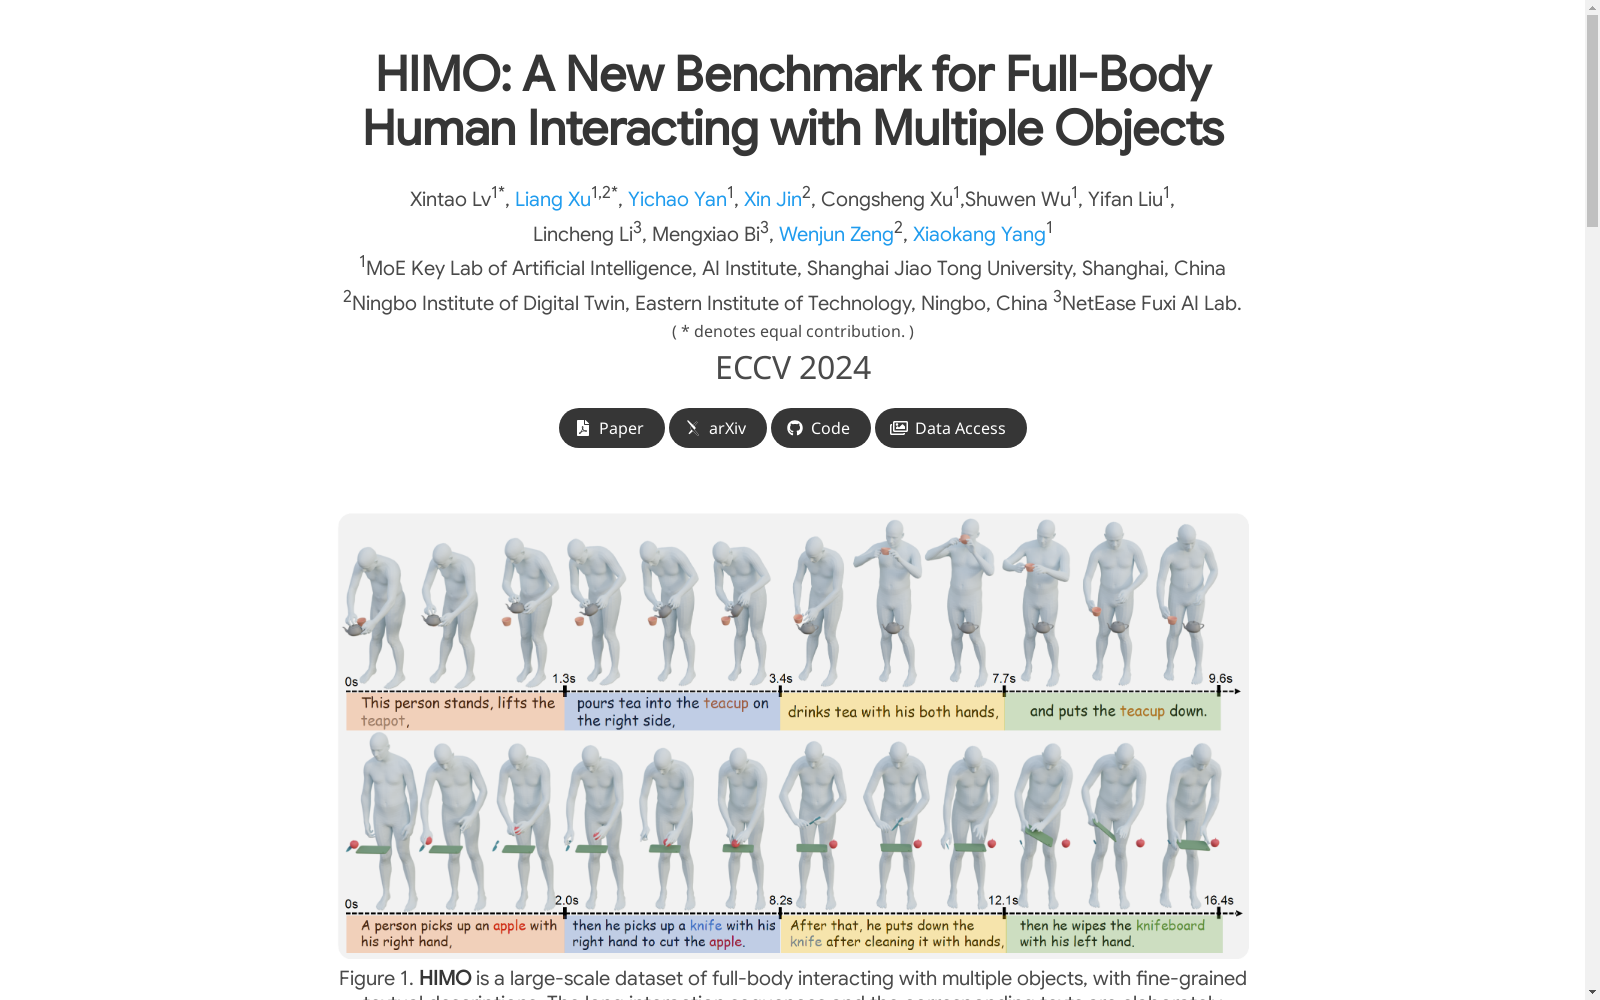
HIMO数据集由上海交通大学人工智能研究所等机构创建,是一个大规模的全身体感数据集,专注于人与多个对象的交互。数据集包含3.3K 4D HOI序列和4.08M 3D HOI帧,通过光学MoCap系统和可穿戴惯性手套捕捉精确的身体和手指运动。数据集的创建过程包括对日常对象的精确跟踪和细致的文本描述标注,旨在支持文本驱动的HOI合成研究,特别是在视频游戏、AR/VR和机器人技术等领域。
The HIMO dataset, developed by the Institute of Artificial Intelligence at Shanghai Jiao Tong University and other institutions, is a large-scale full-body motion capture dataset focused on human interactions with multiple objects. It contains 3.3K 4D HOI sequences and 4.08M 3D HOI frames, capturing precise body and finger movements through optical MoCap systems and wearable inertial gloves. The dataset construction process involves accurate tracking of daily objects and annotations with detailed textual descriptions. It is designed to support text-driven HOI synthesis research, especially in fields such as video games, AR/VR, and robotics.
HIMO 数据集概述
数据集简介
HIMO 是一个大规模的 MoCap 数据集,专注于全身体与多个对象的交互。该数据集包含 3.3K 个 4D 人体-对象交互(HOI)序列和 4.08M 个 3D HOI 帧。此外,HIMO 还配备了详细的文本描述和时间片段注释,支持基于整个文本提示或分段文本提示的 HOI 合成任务,实现细粒度的时间线控制。
数据集特点
- 规模:包含 3.3K 个 4D HOI 序列和 4.08M 个 3D HOI 帧。
- 注释:提供详细的文本描述和时间片段注释。
- 应用:适用于基于整个文本提示或分段文本提示的 HOI 合成任务。
数据集应用
HIMO 数据集主要用于以下两个新颖的 HOI 合成任务:
- 基于整个文本提示的 HOI 合成:利用完整的文本描述生成 HOI 序列。
- 基于分段文本提示的 HOI 合成:利用分段的文本描述生成 HOI 序列,实现细粒度的时间线控制。
数据集访问
数据集可通过以下链接申请访问: 数据访问链接