
遇见数据集

cemig-ceia/reupload_ons_aneel_markdown_metadata

收藏
Hugging Face2026-07-14 更新2026-07-22 收录
官方服务:

资源简介:

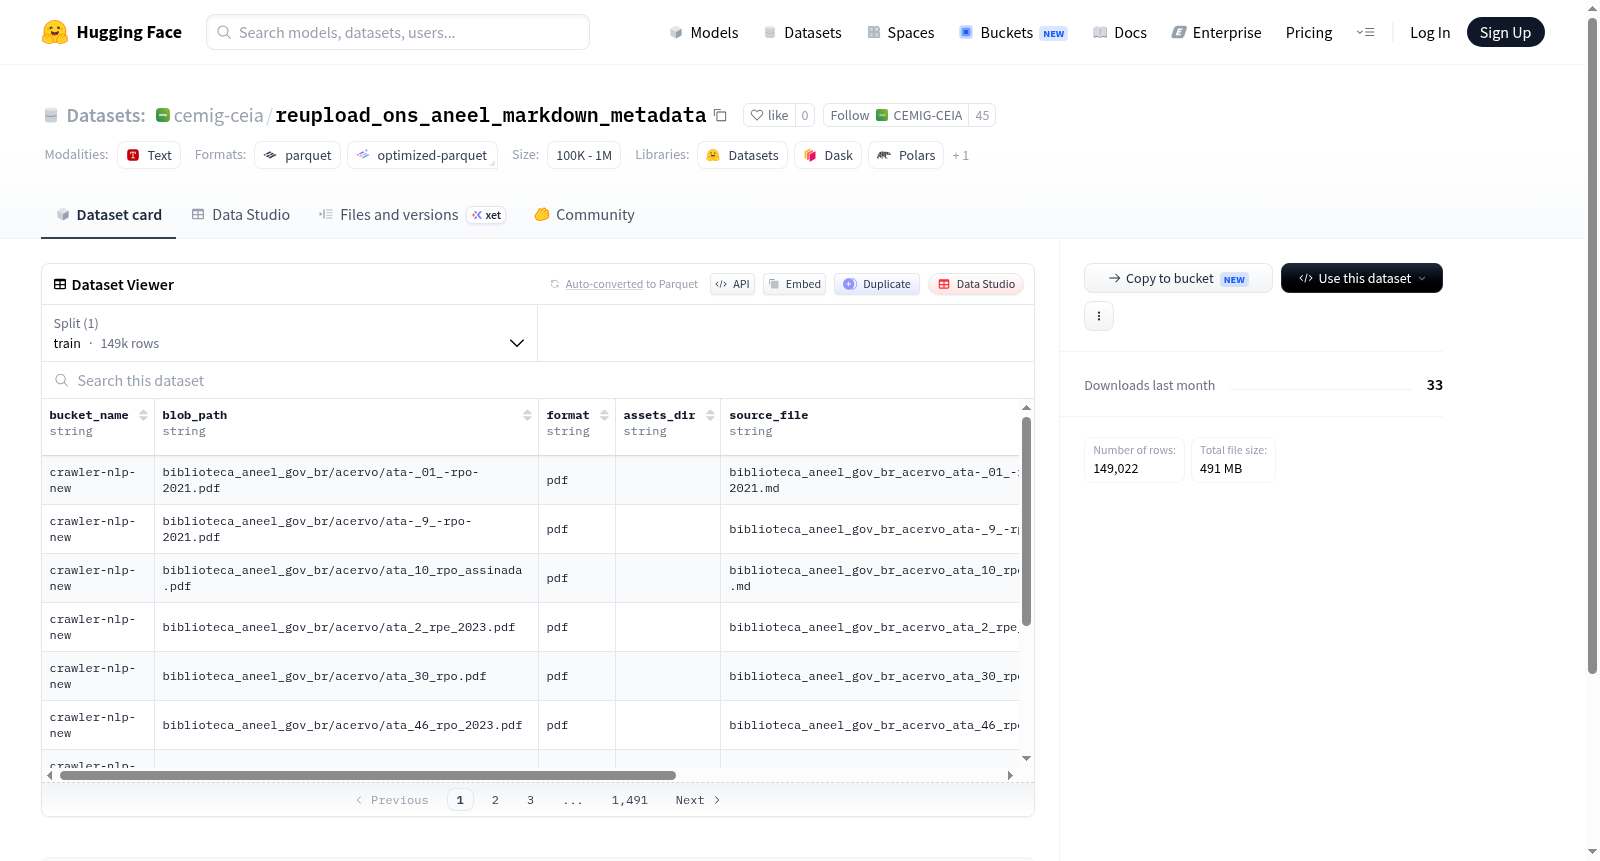
该数据集是一个包含图像和文本关联数据的集合,主要用于训练目的。数据集中每个示例包括多个特征:bucket_name(存储桶名称)、blob_path(blob路径)、format(格式)、assets_dir(资源目录)、source_file(源文件)、image_paths(图像路径列表)、text(文本内容)和metadata_json(元数据JSON字符串)。数据集分为一个训练分割,包含149,022个示例,总大小约为1.45GB,下载大小约为491MB。数据可能用于图像描述、元数据分析或相关自然语言处理任务。

This dataset is a collection of image and text association data, primarily intended for training purposes. Each example in the dataset includes multiple features: bucket_name, blob_path, format, assets_dir, source_file, image_paths (a list of image paths), text, and metadata_json. The dataset is divided into a single train split, containing 149,022 examples with a total size of approximately 1.45GB and a download size of about 491MB. The data may be used for tasks such as image captioning, metadata analysis, or related natural language processing applications.
提供机构:
cemig-ceia
搜集汇总
数据集介绍
cemig-ceia/reupload_ons_aneel_markdown_metadata 数据集图片
构建方式
该数据集依托巴西国家电力局(ANEEL)的公开数据源,通过对原始文档进行系统化的解析与结构化处理构建而成。数据集的构建流程包括从云存储桶中抓取多格式文件(如PDF、图片等),并借助OCR技术与Markdown转换工具将非结构化文本转化为标准化文本格式。在此基础上,每个样本保留了源文件的元数据(如存储位置、格式类型、资产目录路径等),并关联了对应的图像路径与完整文本内容,最终以高效的Parquet格式存储,共包含约14.9万条训练样本。
特点
数据集兼具结构化与多模态特性,其核心特征在于字段设计的全面性与实用性。每个样本涵盖了存储标识(bucket_name、blob_path)、文件格式、资产目录、源文件路径及关联图像列表等关键元数据,同时保留了原始文本与JSON格式的元数据信息。这种设计使得数据集不仅适用于纯文本分析(如文档分类、信息抽取),还能支持多模态任务(如图文对齐、文档理解)。此外,数据集的规模适中(约1.4GB),便于实验与迁移学习。
使用方法
该数据集可通过HuggingFace的`datasets`库直接加载,默认配置为`default`,训练分片(split)指定为`train`,数据文件路径为`data/train-*`。用户可调用`load_dataset`函数并指定数据集名称,自动获取包含全部字段的样本。在使用时,可根据任务需求提取特定列:例如,通过`text`字段进行文档分类或主题建模,利用`image_paths`与`text`的对应关系构建图文对进行多模态预训练,或解析`metadata_json`获取结构化标签用于监督学习。
背景与挑战
背景概述
该数据集名为reupload_ons_aneel_markdown_markdown_metadata,由巴西国家电力局(ANEEL)与开放数据网络(ONS)等相关机构创建,旨在整合巴西电力系统运营与监管领域的结构化与非结构化数据。创建时间可追溯至近期,核心研究问题聚焦于如何将分散的电力行业文档、图像及元数据统一为可机器读取的格式,以支持能源领域的数据分析与模型训练。该数据集收录了约14.9万条训练样本,涵盖存储路径、格式、图像路径及文本信息等字段,为电力系统监测、故障诊断及负荷预测等任务提供了基础数据资产。其对相关领域的影响力体现在推动能源数据标准化进程,促进巴西电力系统透明度与智能化研究,尤其为基于视觉与文本多模态分析的能源应用奠定了数据基础。
当前挑战
领域问题层面,该数据集主要解决电力行业数据异构性带来的分析困境——原始数据分散于不同格式的文件(如PDF、图片、表格)中,缺乏统一的架构,难以直接用于机器学习模型。此外,元数据的不完整性与噪声(如时间戳缺失、图像质量参差)增加了数据清洗的难度。构建过程中,挑战包括:从多源系统(如ANEEL官网、ONS数据库)自动化爬取与解析非结构数据,需处理文档编码差异与反爬机制;海量图像与文本的关联对齐需依赖人工校验,导致效率瓶颈;数据隐私与法律合规要求(如巴西《通用数据保护法》)限制了部分敏感信息的公开。这些挑战共同构成了数据集的局限性与未来优化方向。
常用场景
经典使用场景
在巴西能源监管领域,该数据集是研究电力行业文档与图像联合分析的重要基石。它汇集了ONS(巴西国家电力系统运营商)和ANEEL(巴西国家电力能源局)的大量结构化与非结构化数据,包括文本、图片及丰富的元数据。经典使用场景涵盖多模态信息检索,通过整合bucket_name、blob_path及metadata_json字段,研究者能够构建跨模态的语义对齐模型,实现电力报告与现场照片的智能关联。此外,数据集中的格式化文本与图像路径为训练文档理解系统提供了理想素材,推动电力领域知识图谱的自动构建与更新。
实际应用
在实际应用中,该数据集赋能了巴西电力监管的智能化升级。基于文本与图像的联合分析,可开发智能审计系统,自动比对电力设施图像与运检记录,提升巡检效率。数据集中的格式化字段支持构建文档流水线,实现监管报告的自动分类与关键参数提取。结合metadata_json中的地理与时间信息,还能开发动态资产管理系统,实时追踪电网设备状态,减少人工核查成本,为拉美地区的能源数据治理提供了可复用的范式。
衍生相关工作
围绕该数据集衍生了一系列创新工作。其中最具代表性的是基于多模态对比学习的电力文档检索模型,它利用bucket_name和image_paths实现了跨模态的高效匹配。在此之上,研究者开发了弱监督分割算法,从文档图像中自动提取电气设备区域。此外,该数据集催生了首个巴西电力领域的多模态预训练基准,推动了文档结构分析、图表理解等子任务的标准化评测。这些成果不仅深化了文档智能领域的研究,也为后续的能源行业多模态模型奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

