
遇见数据集

mohammedaly22/lahgtna-levantine-tts

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

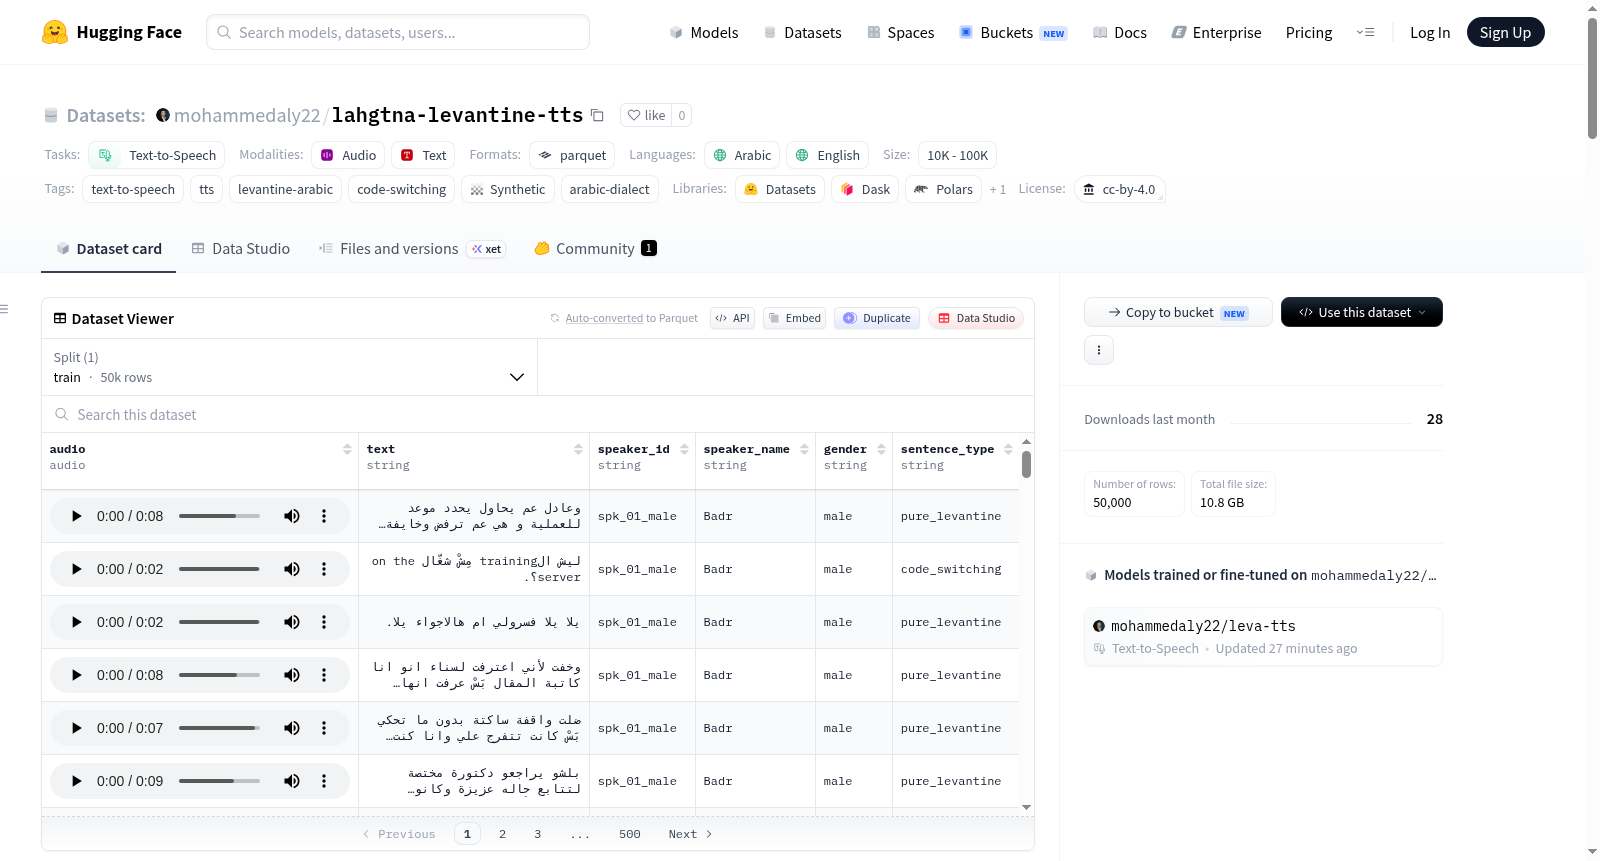
Lahgtna Levantine TTS 是一个合成黎凡特阿拉伯语和英语代码切换的语音数据集,专为文本到语音(TTS)任务设计。数据集包含50,000个话语,由10位说话者(5男5女)生成,总时长约66.8小时。其中,44,154个话语为纯黎凡特阿拉伯语,5,846个话语为黎凡特阿拉伯语与英语的代码切换。数据基于GU-CLASP Shami语料库的真实黎凡特阿拉伯语文本(涵盖叙利亚、黎巴嫩、巴勒斯坦和约旦方言)以及合成的代码切换模板生成。文本经过规范化处理,包括Unicode清理、数字口头化、部分加注音(仅针对同形异义词)和黎凡特词典覆盖。语音合成使用Lahgtna-OmniVoice模型,这是一个针对黎凡特阿拉伯语方言微调的零样本TTS模型,通过参考音频进行语音克隆生成。数据集以24,000 Hz的采样率存储音频,并包含文本转录、说话者ID、说话者姓名、性别和句子类型等字段。

Lahgtna Levantine TTS is a synthetic Levantine Arabic and English code-switching speech dataset designed for text-to-speech (TTS) tasks. The dataset consists of 50,000 utterances generated by 10 speakers (5 male, 5 female), with an estimated total duration of approximately 66.8 hours. It includes 44,154 pure Levantine Arabic utterances and 5,846 code-switching utterances mixing Levantine Arabic and English. The data is derived from the GU-CLASP Shami corpus, which provides authentic Levantine Arabic text from Syrian, Lebanese, Palestinian, and Jordanian sub-dialects, along with synthetic code-switching templates. Text processing involves normalization, Unicode cleanup, number verbalization, partial diacritization (applied only to homographs), and Levantine lexicon overrides. Speech synthesis is performed using the Lahgtna-OmniVoice model, a zero-shot TTS model fine-tuned for Levantine Arabic dialect, with voice cloning from reference audio. The dataset features audio at a 24,000 Hz sampling rate, along with text transcripts, speaker IDs, speaker names, gender, and sentence type fields.
提供机构:
mohammedaly22
搜集汇总
数据集介绍
mohammedaly22/lahgtna-levantine-tts 数据集图片
构建方式
Lahgtna Levantine TTS数据集基于黎凡特阿拉伯语方言与英阿混码场景构建而成,语料来源涵盖GU-CLASP Shami语料库中四类真实方言文本(叙利亚、黎巴嫩、巴勒斯坦、约旦),以及人工设计的代码切换模板。在文本处理阶段,实施了包括Unicode归一化、数字口语化转换、仅对同形异义词进行局部标音,以及黎凡特写法的规范修正(如将非标准 ه 还原为 ة)等精细步骤。随后,利用基于OmniVoice架构微调的Lahgtna-OmniVoice模型,通过零样本语音克隆技术,从10位真实黎凡特方言发音人的短参考音频中生成合成语音,最终产出5万条包含男性与女性各五名说话人的高质量语音-文本对。
特点
该数据集的核心特色在于其方言多元性与混码自然性:总计约66.8小时的语音数据中,约88%为纯黎凡特阿拉伯语,12%为遵循方言习惯的英语-阿拉伯语代码切换样例。每个说话人均贡献5000条话语,确保声学特征的均衡分布。通过采用局部标音策略而非全面标音,模型在推理时对无标音输入展现出更强鲁棒性。此外,数据集中包含一个可编辑的黎凡特方言词汇表,支持灵活扩展,为区域方言语音合成与多语混合系统提供了极具代表性的训练资源。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,使用load_dataset函数指定仓库名与split为'train'即可获取完整训练集。每条样本包含24kHz音频数组、黎凡特转写文本、说话人标识符与类型标签(纯方言/混码)。开发者可借助speaker_id或speaker_name字段按发言人生成语音,或根据sentence_type筛选特定语体样本进行下游任务。该数据集适用于微调方言感知型语音合成模型、训练代码切换检测器,以及评估零样本语音克隆在方言场景下的迁移能力。
背景与挑战
背景概述
Lahgtna Levantine TTS数据集由Mohammed Aly及其团队于近年创建,聚焦于黎凡特阿拉伯语方言的语音合成。该方言覆盖叙利亚、黎巴嫩、巴勒斯坦和约旦地区,在自然语言处理领域长期处于资源匮乏状态。数据集通过精细调校的零样本语音克隆模型Lahgtna-OmniVoice,合成了50,000条高质量语音样本,包含纯黎凡特阿拉伯语与阿英代码混合两种类型,并覆盖10位性别平衡的说话人。其核心研究问题在于推动方言级文本转语音技术的发展,为阿拉伯语非标准变体的多模态应用提供数据基础,对低资源语言语音合成领域具有显著推动作用。
当前挑战
该数据集面临的首要挑战在于方言语音合成的固有复杂性——黎凡特阿拉伯语缺乏标准化正字法,口语中广泛存在的连读、省略和音变现象对声学建模构成障碍。构建过程中需处理文本归一化难题,包括数字的方言化表达、同形异义字的部分标音策略,以及黎凡特语特有的‘ه’与‘ة’混淆校正。此外,代码混合语料的生成需模拟自然的阿英交替模式,这对语言模型和音系规则的协同设计提出高要求。零样本语音克隆还需克服跨说话人音频风格一致性与生成效率之间的平衡,尤其在多GPU并行生成时需确保音色保真度。
常用场景
经典使用场景
在阿拉伯语方言研究与语音合成领域,Lahgtna Levantine TTS数据集因其对黎凡特阿拉伯语及其与英语语码转换现象的独特覆盖,成为训练和评估方言语音合成系统的核心资源。该数据集包含约50,000条高质量合成语音,涵盖10位不同性别与口音的说话人,其中约44,154条为纯黎凡特阿拉伯语话语,5,846条为阿拉伯语-英语混合语码转换话语,总时长近67小时。研究者常借助该数据集微调零样本语音克隆模型,或作为基准测试方言TTS系统在自然度、韵律多样性与语码转换流畅性上的表现,尤其适用于探索低资源方言在合成语音中的可控生成策略。
衍生相关工作
Lahgtna Levantine TTS的诞生催化了一系列围绕低资源方言语音合成的经典研究。其核心合成模型Lahgtna-OmniVoice基于OmniVoice框架在黎凡特阿拉伯语上进行微调,后续工作通过引入多说话人特征编码与韵律迁移算法,进一步提升了方言合成语音的表现力与切换自然度。受该数据集启发,研究者探索了基于部分标音与冲突词表覆盖的方言文本规范化流程,并衍生出针对其他阿拉伯方言(如埃及方言、海湾方言)的TTS构建方法。同时,该数据集促进了语料不足方言下零样本增强策略与语码转换混合语音风格建模的进展,成为方言语音合成领域方法创新与基准比较的重要基础资源。
数据集最近研究
最新研究方向
黎凡特阿拉伯语方言的零样本语音克隆与代码混合语音合成是当前多语言TTS领域的前沿方向。该数据集通过微调OmniVoice模型,生成了包含纯黎凡特方言与阿拉伯-英语代码转换的高质量语音数据,突破了传统标准阿拉伯语语音合成的语料局限。其独特的局部变音符号标注策略仅对同形异义词施加标记,兼顾了模型对非标化文本的鲁棒性,同时利用规则化处理实现了非正式书写(如ه与ة的校正)的标准化。这一工作在方言多样性保护与低资源系统构建间取得了平衡,为阿拉伯语数字包容性提供了关键基础设施,尤其在社交媒体、客服系统和教育工具等需要自然代码转换交互的场景中具有显著应用价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

