
遇见数据集

AxiomResearch/synthetic-dataset-quality90plus

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

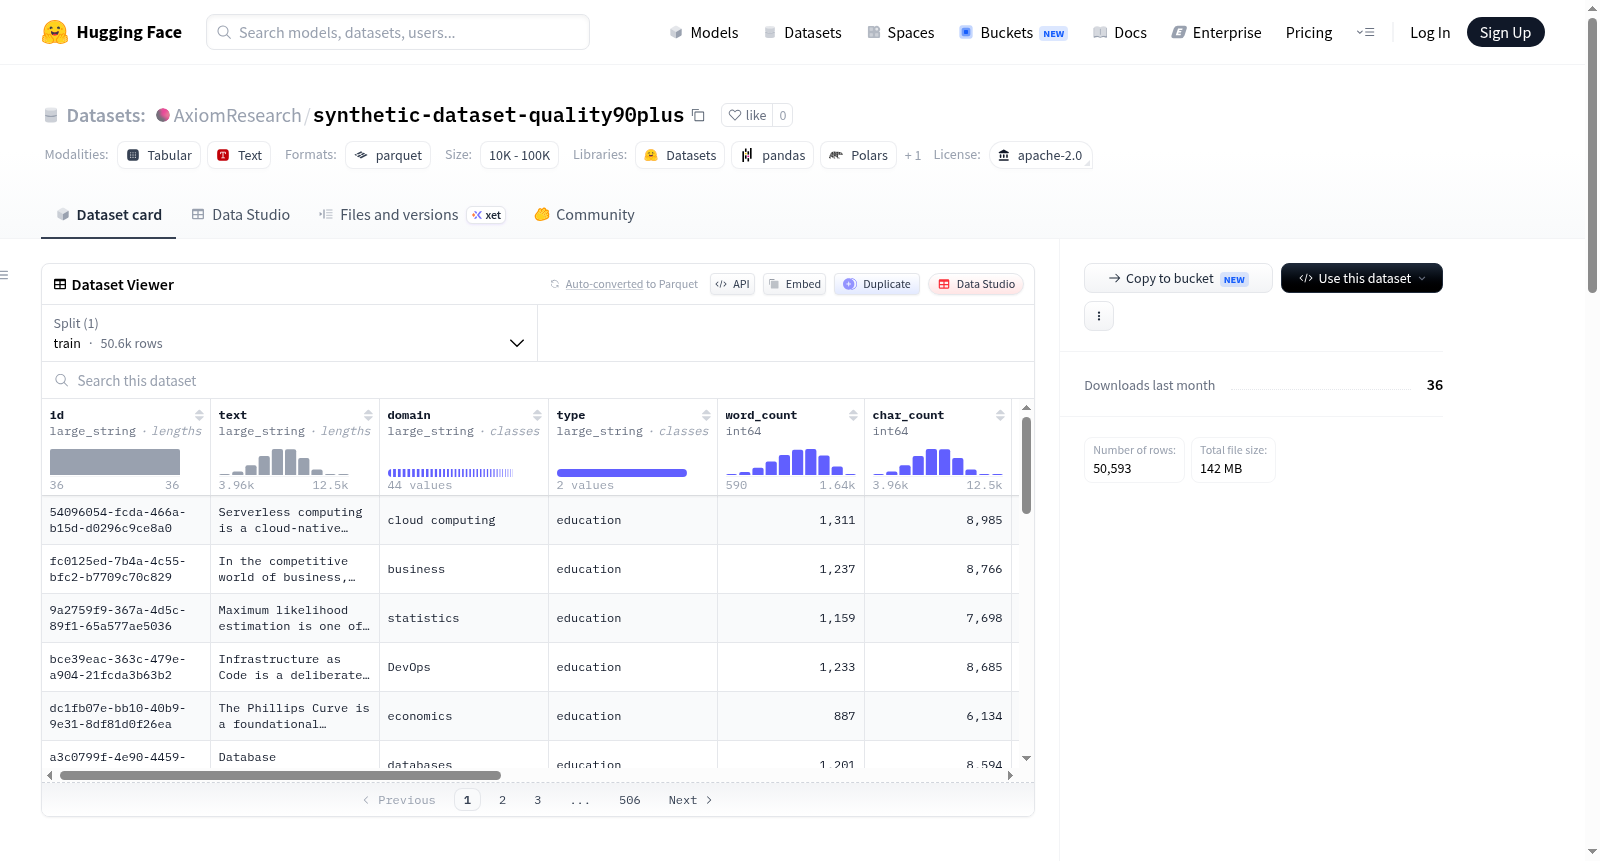
Axiopedia v3 — Quality 90+ 是一个包含50,593篇长篇幅教育文章的数据集,经过严格质量过滤,质量评分≥90/100。该数据集专为持续预训练设计,而非简单的合成数据堆砌。文章平均长度约1,180词,中位数1,213词,涵盖算法、系统、法律、经济学、物理、数学、历史、生物学等50个多样领域。数据集通过生成、精确去重、MinHash LSH去重、质量评分和过滤流程构建,确保无重复内容。生成模型为openai/gpt-oss-20b,采用随机种子领域采样方法,最小生成长度为1,000个令牌。质量评分基于长度、词汇多样性、重复性、结构和清洁度等启发式标准。

Axiopedia v3 — Quality 90+ is a dataset of 50,593 long-form educational articles, filtered for high quality with scores ≥90/100. It is designed to be actually usable for continued pretraining, not just another synthetic dump. Articles have a median length of 1,200 words and cover 50 diverse domains including algorithms, systems, law, economics, physics, mathematics, history, and biology. The dataset is built through a pipeline of generation, exact deduplication, MinHash LSH deduplication, quality scoring, and filtering, ensuring 0% duplicates. It was generated using the openai/gpt-oss-20b model with random-seed domain sampling and a minimum of 1,000 tokens. Quality is assessed via a heuristic rubric based on length, lexical diversity, repetition, structure, and cleanliness.
提供机构:
AxiomResearch
搜集汇总
数据集介绍
AxiomResearch/synthetic-dataset-quality90plus 数据集图片
构建方式
该数据集名为synthetic-dataset-quality90plus,源自Axiopedia v3项目,共包含50,593篇高质量的长篇教育文章,旨在为持续预训练提供实用资源,而非单纯的数据堆砌。构建过程采用随机种子域采样,依托openai/gpt-oss-20b模型生成初始102,300篇文档,每篇至少1,000个token。随后经精确去重和MinHash LSH算法(128个置换,Jaccard阈值为0.85)消除重复,最终通过一套启发式评分体系过滤,保留得分不低于90分的顶层子集。整体流程在消费级MacBook Pro(4核)上完成,体现了高效且严谨的工程化思想。
特点
该数据集以长篇设计为核心,文章中位数长度达1,200词,远非普通的200词问答形式,能够循序渐进地通过示例、代码和数学公式阐释复杂概念。数据在经过全面去重后,重复率为零,确保信息多样性。质量评分由长度、词汇多样性、重复性、结构性和清洁性五个维度构成,其中得分≥90的子集占全语料库的49.5%,并99.3%的文档得分不低于70。覆盖算法、系统、法律、经济学、物理学、数学、历史、生物学等50个领域,主题丰富而专业。
使用方法
用户可直接从HuggingFace下载axiopedia_v3_90plus.parquet文件(142 MB),该文件包含约60万词(约800万token)的教育内容。使用时,可将其作为持续预训练语料库,或用于长文本生成、知识密集型任务等场景。数据集以Parquet格式存储,便于高效读取和处理,建议结合Python的pandas或HuggingFace的datasets库加载,并通过简单的拆分即可适配不同模型训练需求。其高质量筛选保证了下游应用的数据纯净度,减少了额外清洗成本。
背景与挑战
背景概述
Axiopedia v3 — Quality 90+数据集由研究者基于开放模型GPT-Oss-20b于近期构建,旨在提供高质量的长篇教育性文章,用于持续预训练。该数据集包含50,593篇经过严格质量筛选的长篇教育文章,覆盖算法、系统、法律、经济、物理、数学、历史、生物学等50个领域。其核心研究问题在于如何生成并筛选出真正可用于提升语言模型预训练效果的优质合成数据,而非简单的问答对或短文本。该数据集通过多种启发式评分(如长度、词汇多样性、重复度、结构和清洁度)确保质量,并在去重方面采用MinHash LSH技术,实现了零重复率。这一工作为构建高质量、长文本的预训练语料库提供了重要参考,推动了合成数据在自然语言处理领域中的应用研究。
当前挑战
当前数据集面临的核心挑战包括:1)领域问题层面,教育类长篇文本的自动生成与质量评估仍缺乏统一标准,现有评分体系(如启发式规则)可能无法完全捕捉文本的语义深度与逻辑连贯性,导致模型预训练效果提升受限;2)构建过程中,消费级硬件(MacBook Pro 4核)下大规模合成数据的生成与去重计算效率低下,尤其MinHash LSH在128排列下对102k文档的近似去重仍需优化;3)质量过滤门槛(≥90分)虽保证了高纯度,但丢弃了超过50%的生成样本,造成数据资源浪费,如何平衡质量与数据量是一大挑战;4)合成数据的领域多样性依赖随机种子抽样,可能忽略某些关键专题的覆盖,影响模型知识面的广度。
常用场景
经典使用场景
在自然语言处理与大型语言模型的研究中,长文本理解与生成一直是核心挑战之一。synthetic-dataset-quality90plus(亦称Axiopedia v3)以其精心设计的50,593篇长篇幅教育文章,为预训练和持续训练任务提供了高质量语料。每篇文章平均超1,200词,涵盖算法、法律、经济、物理、历史等50个学科领域,内容结构完整,兼具实例、代码与数学推导。该数据集特别适用于语言模型的领域适应训练、长文本连贯性学习以及知识密集型文本生成任务的微调,显著区别于常见的短问答式合成数据集。
衍生相关工作
该数据集的构建理念与方法已催生一系列相关研究工作。其基于随机种子域采样的内容生成策略、结合去重与质量评分的过滤流水线,为后续合成数据集的设计提供了可复现的范本。研究人员借鉴其多维度评分体系,进一步探索了面向特定领域(如医疗、法律)的自动化数据质量评估方案。此外,该数据集所采用的长文本结构化的预训练范式,启发了一系列关于如何利用高质量合成数据增强语言模型在长距离依赖建模与知识忠实性方面的探索,成为合成数据领域中一个具有标杆意义的工作。
数据集最近研究
最新研究方向
在当前大规模语言模型预训练数据日渐趋同的背景下,synthetic-dataset-quality90plus的发布标志着合成数据从粗放式生成向精细化筛选的范式转变。该数据集通过严格的启发式质量评分体系——综合考量篇幅长度(800-1300词最优)、词汇多样性(类型-词符比)、重复模式惩罚(4-gram循环检测)、句法结构合理性(12-25词句长)及文本清洁度——最终从逾10万篇候选文档中遴选出质量评分≥90的顶级长文,覆盖算法、系统、法律、经济、物理、数学、历史、生物学等50个学科门类。尤为值得关注的是,其采用的MinHash局部敏感哈希去重机制(128排列,0.85雅卡尔阈值)彻底消除了文档级近似重复,确保了预训练数据的独特与丰度。这一方法不仅回应了学界对“合成垃圾数据”泛滥的批判,更通过将人工设计的质量标准与自动评判流程耦合,为低成本构建高保真通用知识语料库提供了可复现的工程范式,直接推动了教育型长文本预训练数据集在质量-规模双重约束下的优化路径探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

