
Emendas Parlamentares
收藏官方服务:
资源简介:
来自透明门户(Portal da Transparência)的议会修正案公开数据集,包含2014-2026年间的5,795,017行数据,涵盖五个子库。
This public dataset of parliamentary amendments is sourced from Portal da Transparência, containing 5,795,017 rows of data spanning the period from 2014 to 2026 and covering five sub-databases.
创建时间:
2026-08-18
原始信息汇总
数据集概述
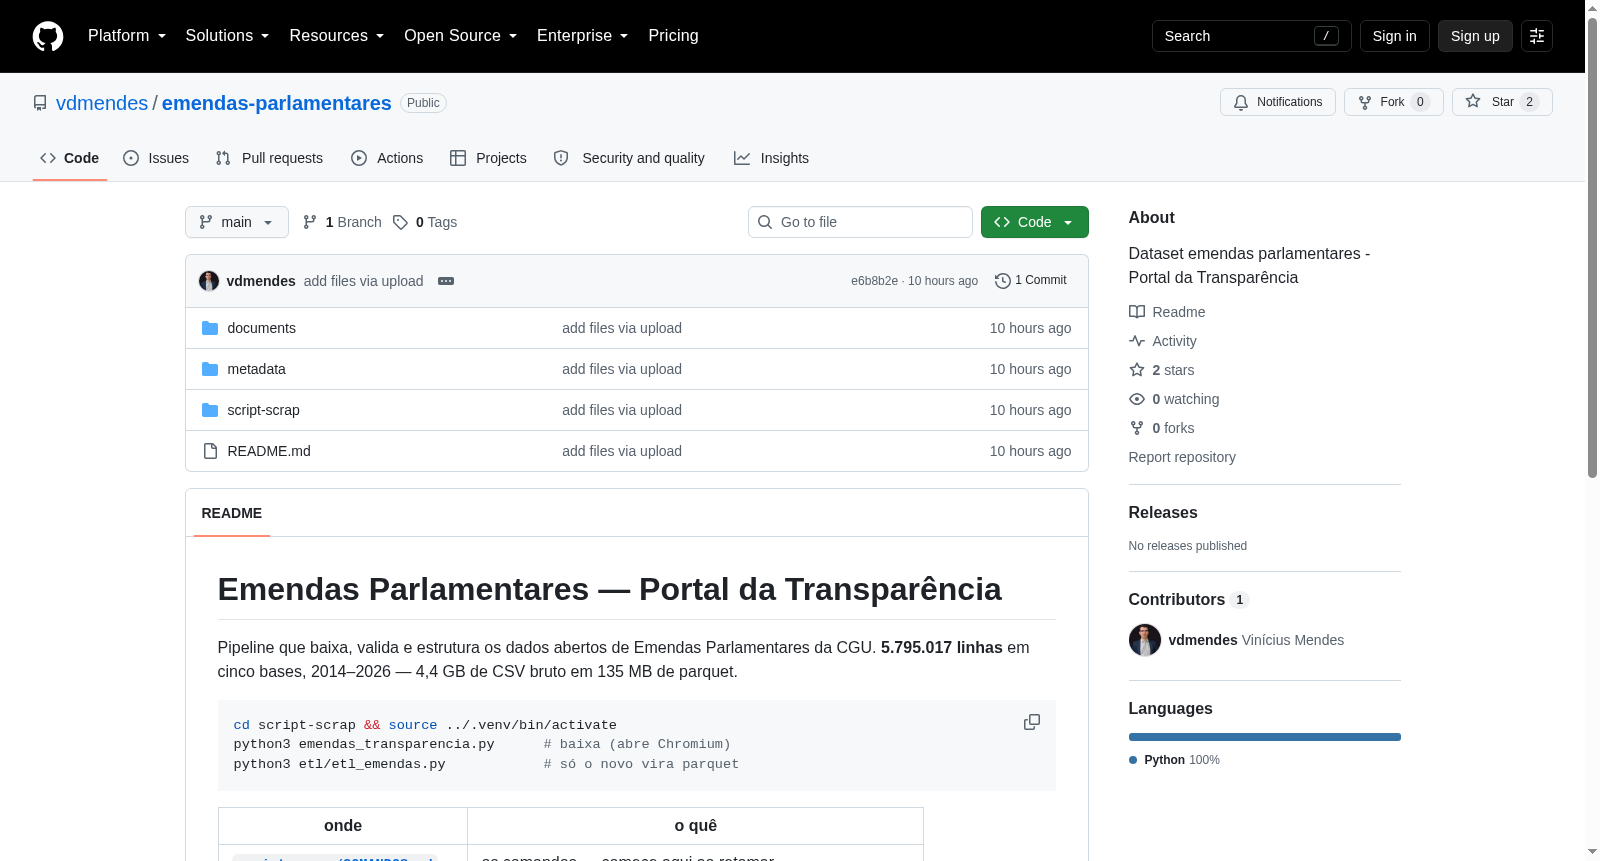
Emendas Parlamentares — Portal da Transparência 是一个巴西联邦政府透明度门户网站(CGU)的议会修正案公开数据管道项目。
数据规模
- 总计 5,795,017 行,覆盖 2014 至 2026 年
- 原始 CSV 约 4.4 GB,压缩为 Parquet 格式后约 135 MB
- 数据分为五个基础数据集
数据内容与结构
- 数据来源为 CGU 透明度门户的议会修正案公开数据
- 原始数据存储于
raw/目录(未修改),处理后数据存储于processed/目录(Parquet 格式,按年份分文件)
数据处理流程
项目包含一个完整的管道,用于下载、验证和结构化数据:
- 使用浏览器自动化(Chromium)从门户下载数据
- 通过 ETL 流程将新数据转换为 Parquet 格式
关键分析注意事项
项目特别强调三个可能导致统计错误的事项:
- 年份口径不一致:
emenda、convenios、apoiamento数据集中的ano字段指修正案年份,而documento、favorecido数据集中的ano字段指执行年份,两者不可混用 - 金额重复计算:在
apoiamento数据集中,金额按支持者重复记录,直接求和可能膨胀至 2.5 倍 - 需先过滤:在
documento数据集中,求和前需按fase_despesa字段过滤
文档资源
项目提供多份文档:
- 命令指南:
script-scrap/COMANDOS.md,包含操作命令 - 项目总览:
documents/PROJETO.md,涵盖架构、决策与分析发现 - 分析陷阱说明:
script-scrap/etl/README.md,分析前必读 - 爬虫说明:
script-scrap/README.md,介绍如何绕过 WAF - 数据字典:
metadata/目录
搜集汇总
数据集介绍
构建方式
该数据集源自巴西联邦政府透明度门户(Portal da Transparência)公开的议会修正案(Emendas Parlamentares)数据,通过定制化爬虫工具(基于Chromium浏览器)自动下载原始CSV文件,并经过清洗、验证与结构化处理后,转换为优化的Parquet格式存储。整个处理流程封装于版本控制的Pipeline中,涵盖数据抓取、ETL(提取-转换-加载)等环节,确保数据的完整性与可追溯性。数据集覆盖2014至2026年,包含五个子表,总计逾579万条记录,原始数据体积约4.4GB,压缩后仅为135MB,显著提升存储与查询效率。数据按年度分别存放于processed目录下,每份文件均经过类型化处理,便于直接用于分析。
特点
该数据集的核心特点在于其多维度、精细化的结构设计。五个子表(emenda、convenios、apoiamento、documento、favorecido)分别对应议会修正案的不同层级,从提案到执行单位、支持者、相关文件及受益方,形成完整的数据链条。特别值得关注的是,数据集中隐含三个易被忽视的陷阱:年份字段在部分表中指修正案年份,在另一些表中指执行年份;apoiamento子表中金额因重复计数可能被高估至2.5倍;documento子表需按支出阶段筛选后才能进行汇总。这些特点要求分析者必须深入理解数据语义,避免因简单求和而得出错误结论。此外,数据经专业ETL流程处理,类型明确,且附带详尽的数据字典与项目文档,为不同领域的应用提供了坚实基础。
使用方法
数据使用遵循一套结构化的流程。用户可通过执行`emendas_transparencia.py`脚本主动抓取最新数据(需启用虚拟环境并具备网络环境),随后运行`etl_emendas.py`进行增量转换,仅处理新增或变更部分,生成或更新Parquet文件。对于分析人员,建议先从`script-scrap/COMANDOS.md`入手了解操作命令,再阅读`documents/PROJETO.md`获取架构概览与分析洞见。在实际计算中,需密切关注`script-scrap/etl/README.md`中列举的三大陷阱,特别是对`apoiamento`子表进行去重或谨慎求和,对`documento`子表按`fase_despesa`字段过滤。最后,可借助metadata下的数据字典理解各字段含义,确保分析结果的准确性与可比性。
背景与挑战
背景概述
Emendas Parlamentares数据集由巴西联邦政府透明度门户(Portal da Transparência)创建,旨在系统化整理国会议员提交的预算修正案数据。该数据集由CGU(联邦审计法院)团队开发,覆盖2014至2026年,包含超过579万条记录,整合了五类核心数据源,并通过自动化流水线实现数据的下载、验证与结构化存储。其核心研究问题在于揭示巴西政治预算分配中的透明度与可追溯性,为公共政策分析、反腐败研究及社会科学研究提供高质量数据基础。该数据集以开放的CSV和高效的Parquet格式发布,显著降低了数据分析门槛,对预算透明度和民主问责制研究具有重要推动作用。
当前挑战
该数据集面临的挑战主要体现在领域问题和构建过程两方面。从领域问题看,巴西预算修正案数据涉及多源异构数据的整合,且存在时间维度不一致(如修正案年度与执行年度可能不同),导致跨年分析时易产生偏差。此外,数据中支持者信息的重复记录可能使汇总值虚增数倍,要求分析者具备精细的数据清洗能力。从构建过程看,爬虫需绕过门户网站的安全防护(WAF),并处理持续更新的数据流,确保数据完整性与时效性。同时,ETL流程需兼顾数据验证和类型转换,避免因数据质量问题(如缺失值、异常值)导致的错误分析结论,这对数据管道的鲁棒性提出了较高要求。
常用场景
经典使用场景
该数据集汇聚了巴西联邦政府2014至2026年间议会修正案(Emendas Parlamentares)的庞大公开数据,涵盖近580万条记录,并经过精心清洗与结构化处理,形成多维度、多粒度的分析基础。其最经典的使用场景在于对巴西政治资源配置的量化剖析,研究者可据此追踪资金流向、识别分配模式、评估区域公平性,并深入探究立法与行政机构间的互动关系,为公共政策与政治经济学研究提供了坚实的数据支撑。
衍生相关工作
围绕此数据集,已衍生出多项聚焦于巴西财政联邦主义与政治分配逻辑的经典研究。工作多集中于利用其长时段、细颗粒度的特性,检验执政联盟中的政治恩庇假说,或测算修正案对不同地区民生指标的边际影响。此外,数据清洗过程中的方法论沉淀,亦为处理类似政府开放数据提供了宝贵的参照范例,促进了计算社会科学在该领域的应用拓展。
数据集最近研究
最新研究方向
在巴西的公共财政透明化进程中,Emendas Parlamentares数据集作为一项关键的资源,正引领着对立法预算分配机制的前沿研究。该数据集涵盖了2014至2026年间超过579万条记录,通过精细的ETL流程和类型化的Parquet存储,为研究者提供了无与伦比的深度与广度。当前的研究方向聚焦于揭露议员修正案中的资源分配漏洞与效率问题,特别是通过分析不同年度、执行阶段及支持者维度的数据,以识别潜在的过度计算或资金滥用模式。此外,结合透明门户的开放数据倡议,该数据集正在助力算法治理和人工智能在公共审计中的应用,推动对政治经济交互的量化理解,其重要意义在于提升政府问责性、优化财政资源配置,并为公民社会监督提供了坚实的数据基础。
以上内容由遇见数据集搜集并总结生成


