
Extremophilic Protein Translator Dataset
收藏官方服务:
资源简介:
从极端微生物(来自GTDB)中构建的标记分泌蛋白数据集
A labeled secreted protein dataset constructed from extremophiles sourced from the Genome Taxonomy Database (GTDB)
创建时间:
2026-07-08
原始信息汇总
Extremophilic Protein Translator 数据集详情
数据集概述
Extremophilic Protein Translator(极端微生物蛋白翻译器,简称Extremolith)是一个专门收集极端微生物分泌蛋白的标记数据集。该数据集从GTDB数据库中筛选极端微生物的分泌蛋白,用于微调蛋白质语言模型(如ESM)或训练能够学习细胞外蛋白质极端适应特性的分类器。
核心设计理念
数据集构建动机
蛋白质暴露于细胞外环境时,必须适应其所在生物的生存条件。通过按环境(温度、pH、盐度)分档收集极端微生物的分泌蛋白,可以获得序列如何适应极端条件的信号。
解决的两个关键问题
-
环境标签噪声问题:生物的分离来源仅是代理指标(细胞可能出现在并非其适宜生长的环境中)。该数据集将GTDB/NCBI元数据代理与GenomeSPOT基因组预测(最佳温度、pH和盐度)相结合,并保留记录两者是否一致的置信度标签。
-
进化枝≠性状问题:朴素数据集会让模型学习识别系统发育分支并将其与环境关联,而非学习适应性性状本身。该数据集通过以下方式控制:(a) 选择系统发育多样性高的极端微生物;(b) 为每种极端微生物配对系统发育上相近的中温微生物外群;并划分训练/验证/测试集以防止序列一致性和系统发育泄漏。
数据集规模与来源
- GTDB版本:r232
- 物种代表数量:199,923个(189,801个细菌 + 10,122个古菌)
- 数据来源:GTDB(Genome Taxonomy Database)物种代表基因组及蛋白序列
数据格式与命名规范
- 基因组ID格式:保留GTDB来源前缀,
GB_(GenBank/GCA)或RS_(RefSeq/GCF),例如RS_GCF_000005845.2 - FASTA头部格式:
>{基因组ID}~{蛋白质ID},例如>GB_GCA_000008085.1~AE017199.1_1 - 代表标志:元数据列
gtdb_representative == t
构建流程
| 阶段 | 说明 | 输出 |
|---|---|---|
| 1. GTDB索引 | 索引GTDB物种代表元数据 | results/gtdb_reps_metadata.parquet |
| 2. 元数据标记 | 环境标记筛选 | results/metadata_flags.parquet |
| 3. GenomeSPOT预测 | 基因组最佳环境预测 | 每基因组预测结果 |
| 3b. 预测调和 | 调和GenomeSPOT预测结果 | results/genomespot_reconciled.tsv |
| 4. 组合标签 | 生成环境标签 | results/environment_labels.parquet |
| 5. 系统发育选择 | 选择多样化极端微生物及中温配对 | results/selected_genomes.parquet |
| 6. SignalP信号肽预测 | 运行SignalP识别分泌蛋白 | 分泌蛋白表 |
| 7. 数据集构建 | 构建最终数据集 | results/pilot_dataset.parquet + FASTA |
项目结构
src/eptrans/:Python包(流水线模块)scripts/:编号的阶段运行器 + SLURM数组脚本config/:配置文件(路径、阈值、约定)environment/:conda环境规格(GenomeSPOT、本地流水线+DeepSig、PLM微调)tests/:单元测试(解析器、调和逻辑)results/:parquet表、图表、报告data/:本地临时/下载的预计算数据
环境依赖
environment/genomespot.yml:GenomeSPOT(Python 3.11,hmmlearn 0.3.0)environment/smoketest.yml:本地流水线 + DeepSig(SignalP备选)environment/translator.yml:PLM微调(torch、transformers、ESM)- SignalP 6.0 需安装在 PATH 中
许可证
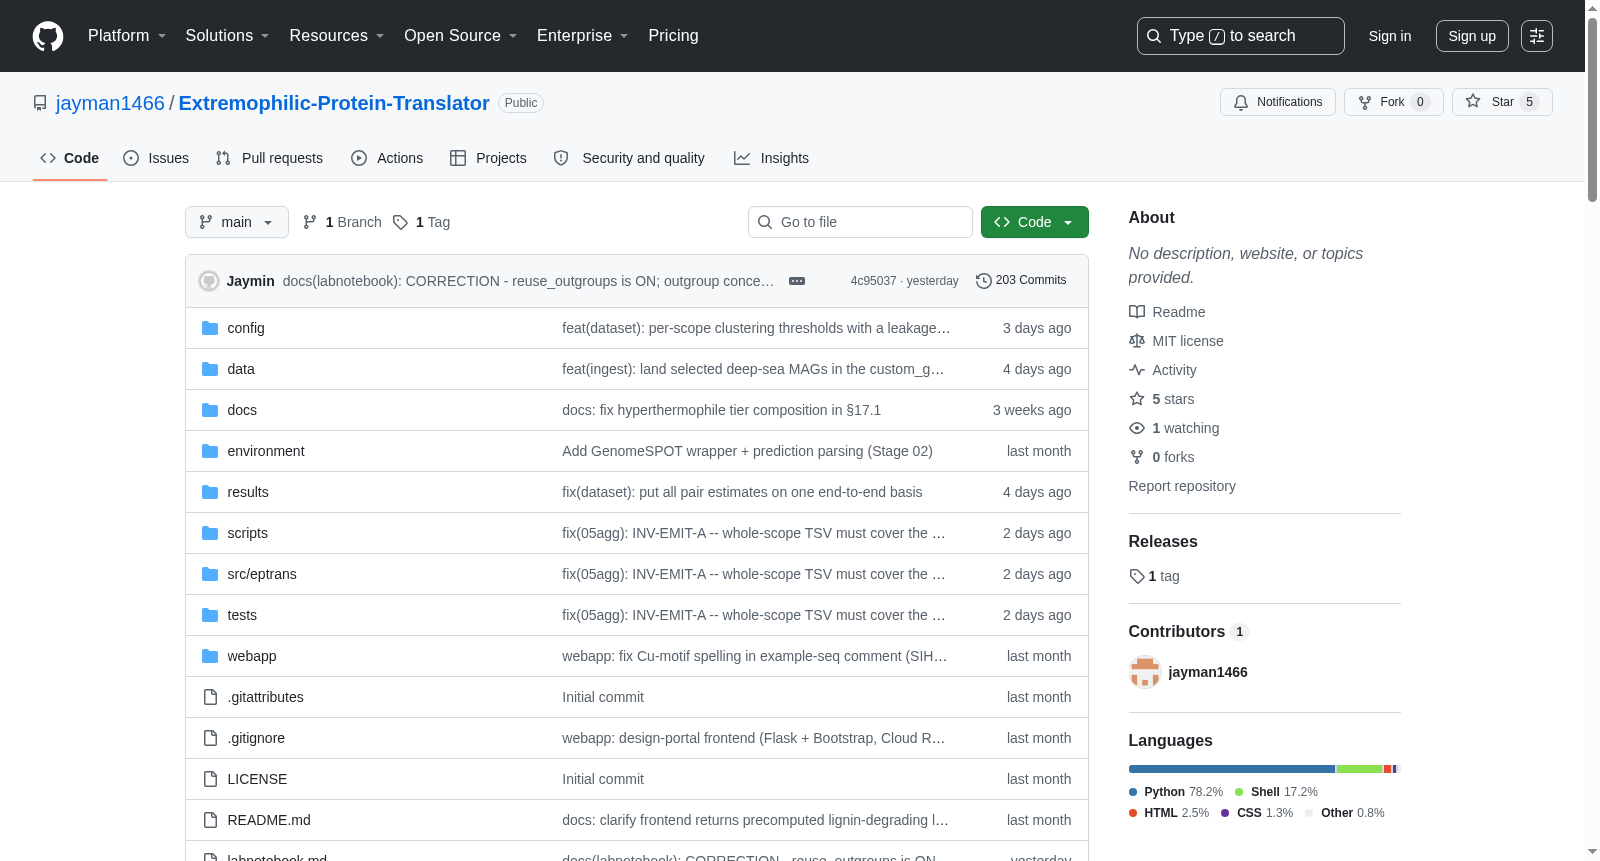
MIT许可证
搜集汇总
数据集介绍
构建方式
该数据集构建聚焦于极端微生物分泌蛋白的系统性收集与标注。首先,基于GTDB r232版本,选取199,923个物种代表性基因组(含189,801细菌与10,122古菌),利用其蛋白质序列数据。构建过程中,整合了NCBI/GTDB元数据中的环境来源信息与GenomeSPOT预测的最适温度、pH及盐度,两者相互印证,形成多维度环境标签,并附置信度标记以应对环境标签噪声。为剔除系统发育混杂因素,研究选取系统发育多样化的极端微生物,并为每个极端微生物匹配亲缘关系相近的中温物种作为对照群,从源头控制谱系偏差。随后,利用SignalP预测分泌蛋白信号肽,筛选出分泌蛋白组,最终生成包含序列、环境标签及置信度的综合数据集,并输出为parquet及FASTA格式。
使用方法
数据集以标准parquet表格和FASTA文件形式呈现,用户可通过安装eptrans包(pip install -e .)并运行预置脚本访问。对于计算密集型步骤(如GenomeSPOT和SignalP),项目提供SLURM阵列作业脚本,适配高性能计算集群。数据集可直接用于微调ESM等蛋白语言模型,或作为训练极端嗜性分类器的标签语料。用户可依据config.yaml中的路径配置,导入环境标签、分泌蛋白序列及系统发育配对信息,灵活构建下游任务。此外,仓库附带单元测试,确保解析与标注逻辑的准确性,便于拓展或复现数据集构建流程。
背景与挑战
背景概述
极端微生物蛋白翻译数据集(Extremophilic Protein Translator Dataset)由研究团队于2024年构建,旨在系统性地收集极端环境微生物的分泌蛋白组,以支持蛋白质语言模型(如ESM)的微调与极端嗜性特征分类器的训练。该数据集依托GTDB数据库r232版本,涵盖199,923个物种代表基因组(189,801细菌与10,122古菌),通过整合环境来源元数据与GenomeSPOT基因组预测,为每个蛋白赋予温度、pH和盐度等极端条件标签,并引入系统发育对照策略以区分适应性性状与进化枝效应。研究团队来自生物信息学与蛋白质工程交叉领域,其核心研究问题在于解码蛋白质序列如何适应极端细胞外环境,该数据集为理解极端环境蛋白质进化提供了宝贵资源,并对工业酶工程与合成生物学具有潜在推动作用。
当前挑战
该数据集面临的挑战主要体现在两个方面。其一,环境标签的噪声问题:生物体的分离来源仅是生存环境的间接代理,细胞可能存在于非最适环境中,为此需将GTDB/NCBI元数据与GenomeSPOT基因组预测相融合,并引入置信度标记,增加了数据处理的复杂性。其二,进化枝与性状的混淆:朴素数据集易使模型学习识别系统发育进化枝而非实际适应性状,需通过选择系统发育多样的极端微生物并与近缘中温菌配对,同时划分训练/验证/测试集以阻止序列同一性与系统发育信息泄漏,这对数据筛选与划分策略提出了严苛要求。此外,构建流程涉及大规模计算资源(如GenomeSPOT与SignalP在SLURM集群上的运行),并需处理GTDB庞大基因组数据的存储与索引,技术实现与资源管理亦构成显著挑战。
常用场景
经典使用场景
Extremophilic Protein Translator数据集专为微调蛋白质语言模型(如ESM)及训练分类器而设计,以学习分泌蛋白的极端嗜性特征。其典型应用场景涵盖从GTDB中提取系统发育多样的极端微生物分泌蛋白组,并配对系统发育相近的中温菌外群,构建具有严格训练/验证/测试划分的标注数据集。该数据集支持序列到功能预测任务,可用于探索蛋白质序列如何适应极端温度、pH和盐度等环境条件。
解决学术问题
该数据集直面环境标签噪声与进化枝混淆两大核心挑战。通过整合GTDB/NCBI元数据代理与GenomeSPOT基因组预测,生成带置信度标签的环境标注,有效缓解了分离来源作为环境代理的不确定性。同时,通过选择系统发育多样的极端菌并配对亲缘中温菌,并采用防止序列同一性和系统发育泄漏的划分策略,确保模型学习的是适应性特征而非进化枝关联,从而推动蛋白质适应进化与结构功能关系研究的严谨性。
实际应用
在实际应用中,该数据集可服务于工业生物技术领域,如筛选和设计耐热、耐盐或耐酸碱的工业酶,用于生物催化、生物修复及极端环境下的生物过程。此外,其还可辅助医学研究,例如理解病原菌在宿主极端环境中的分泌蛋白适应性,或指导合成生物学中人工设计具有特定环境耐受性的分泌蛋白,加速从序列到功能注释的工程化流程。
数据集最近研究
最新研究方向
基于极端微生物分泌蛋白组的蛋白质语言模型微调与极端适应性特征学习,是当前生物信息学与合成生物学交叉领域的前沿热点。该数据集通过整合GTDB基因组分类信息与GenomeSPOT环境表型预测,创新性地解决了环境标签噪声和系统发育混淆两大核心挑战,为探究蛋白质序列在极端温度、pH和盐度条件下的适应性进化规律提供了高质量训练样本。其构建的分泌蛋白组-极端环境对应关系,不仅加深了对生命适应机制的理解,还为工业酶工程(如耐热、耐盐、嗜冷酶)的定向进化与理性设计提供了数据支撑。随着蛋白质大模型(如ESM)的快速发展,利用此类精细标注数据集提升模型对极端适应性的预测能力,已成为推动生物催化、生物修复及极端环境微生物资源开发的重要研究方向。
以上内容由遇见数据集搜集并总结生成


