
遇见数据集

jablonkagroup/questions4manual_annotation

收藏
Hugging Face2026-06-17 更新2026-05-10 收录
官方服务:

资源简介:

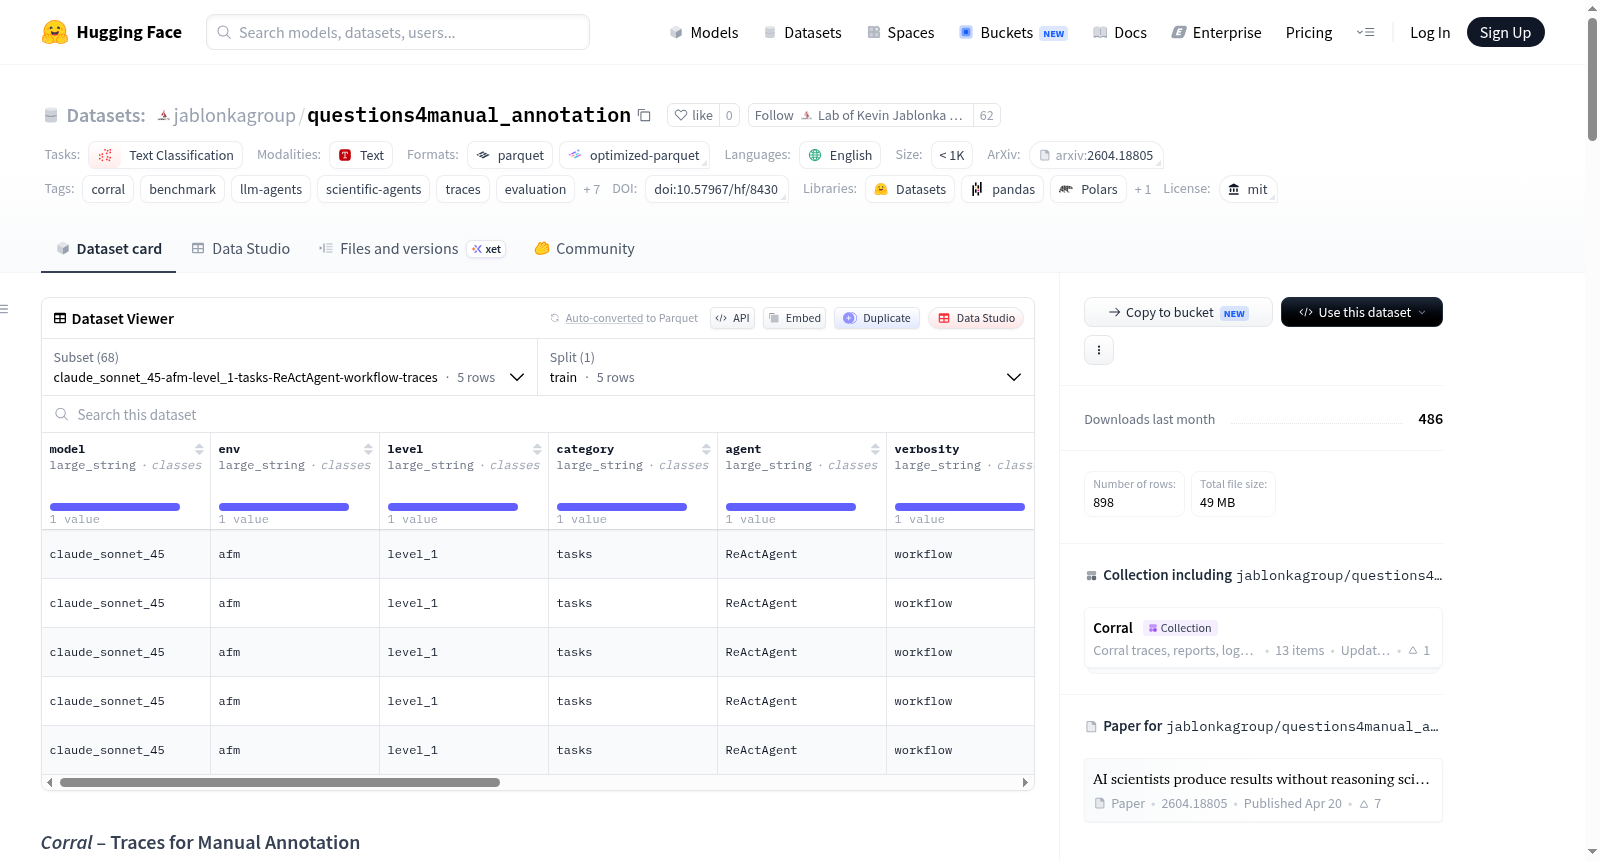
该数据集是Corral集合的一部分,伴随论文《AI科学家在不进行科学推理的情况下产生结果》。它包含从Corral基准测试中选出的用于手动标注认知模式的评估轨迹。数据集按68个配置组织,每个配置对应一个选定的模型、环境、范围和智能体轨迹设置。每个配置中的行是从完整的Corral轨迹集合中分层采样的轨迹。这些轨迹被选中是因为LLM标注器识别出它们为智能体未进行科学推理的案例,因此成为下游人工审查和认知模式分析的目标子集。该资源旨在用于科学智能体行为的标注、定性分析和过程级研究,而非通用模型预训练。

This dataset is part of the Corral collection accompanying the paper AI scientists produce results without reasoning scientifically. It contains the evaluation traces selected for manual annotation of epistemic patterns across the Corral benchmark. The dataset is organized into 68 configurations, with one config per selected model, environment, scope, and agent trace setting. Within each config, rows contain traces sampled in a stratified manner from the full Corral trace collection. The included traces were selected because an LLM annotator identified them as cases where the agents do not reason scientifically, making them a targeted subset for downstream human review and epistemic-pattern analysis. This resource is intended for annotation, qualitative analysis, and process-level study of scientific-agent behaviour rather than for general-purpose model pre-training.
提供机构:
jablonkagroup
搜集汇总
数据集介绍
jablonkagroup/questions4manual_annotation 数据集图片
构建方式
该数据集的构建源于Corral基准测试框架,聚焦于科学智能体在化学与材料科学任务中的推理轨迹。研究者首先利用多种大语言模型(如Claude Sonnet 4.5与GPT-4o)驱动两类智能体架构(ReActAgent与ToolCallingAgent),在涵盖无机分析、电路推断、光谱解析等八个环境中执行不同难度级别的任务,生成原始轨迹。随后,通过LLM自动标注器筛选出其中智能体未展现科学推理行为的案例,构成一个针对性强的子集,最终以68个配置形式组织,每个配置对应特定模型、环境、任务范围与智能体工作流的组合,并按分层采样策略从完整轨迹集合中提取代表性样本,形成供人工标注使用的精简轨迹数据。
特点
该数据集的核心特点在于其精准聚焦于科学推理过程的缺陷分析。它并非通用的预训练语料,而是专门用于人工标注智能体在科学任务中认知模式的数据资源,尤其关注自动标注器标记为‘非科学推理’的案例。数据覆盖了从化学反应器到光谱仪等多样化的科学环境,以及从原子力显微镜实验到分子动力学模拟的复杂任务流程,每条轨迹均保留了智能体完整的工具调用、中间观察与推理步骤,为深入剖析智能体在不同难度与领域中的失败模式提供了丰富的结构化信息。同时,其分层采样设计确保了样本的多样性与代表性,支持跨模型、跨环境的系统性比较与评估。
使用方法
使用该数据集时,研究者应将其视为一个用于人工标注与定性分析的工具,而非直接用于模型训练。用户可通过Hugging Face Datasets库加载特定配置的轨迹数据,例如选择gpt_4o-afm-level_1-tasks-ReActAgent-workflow-traces,以获取指定模型在特定环境中完成简单任务时的完整推理轨迹。每条样本记录了智能体从任务接收到最终输出的每一步操作,适合用于标注认知模式(如工具滥用、逻辑跳步或证据忽视)。建议结合Corral框架的文档与评估工具,将标注结果与自动评估指标进行对比,从而识别自动标注的偏差或遗漏,并构建针对科学推理质量的细粒度分析基准。
背景与挑战
背景概述
Corral – Traces for Manual Annotation数据集由Jablonka课题组于2026年创建,源自Corral基准框架,旨在系统评估科学代理(scientific agents)在化学、材料科学等领域的推理过程。该数据集聚焦于记录大型语言模型驱动的代理在解决科学任务时的行为轨迹,核心研究问题在于揭示这些代理是否真正遵循科学推理逻辑。通过涵盖8个环境、97个工具和115个任务,Corral提供了一个可复现的微服务架构,将代理与环境解耦,从而为科学智能体的过程级评估奠定基础。其发布于HuggingFace平台,为研究者提供了对代理失败模式进行人工标注与认知模式分析的珍贵资源,在科学人工智能的可信度与透明度研究领域具有深远影响。
当前挑战
该数据集面临的挑战体现在多个层面。在领域问题层面,它旨在解决科学代理在推理过程中缺乏真实科学思维的根本困境——现有自动评估大多关注最终结果,而忽视了代理如何逐步得出答案的认知过程。这要求数据集不仅要记录行为轨迹,还要区分有效推理与表面正确的错误路径。在构建过程中,挑战在于如何从海量代理轨迹中筛选出标明“非科学推理”的样本进行人工标注,这涉及自动化标注器的可靠性、分层采样策略的合理性以及对不同环境、模型和任务难度级别的全面覆盖,从而确保评估的深度与广度之间的平衡。
常用场景
经典使用场景
在科学智能体(scientific agents)的评估体系中,该数据集被广泛用作手动标注的测试基准,聚焦于对大型语言模型驱动的智能体在化学与材料科学等环境中执行任务时产生的推理轨迹进行定性分析。研究者通过抽取特定的轨迹样本,深入审视智能体在解决实验设计、逆向合成分析、光谱解析等复杂科学问题时的认知行为模式,尤其关注其是否遵循了严谨的科学推理逻辑。这一过程为剖析智能体在决策过程中的认知缺陷与知识边界提供了宝贵的素材。
解决学术问题
该数据集核心解决了科学智能体研究中的一个关键评估瓶颈——即自动评估指标往往难以捕捉模型在推理过程中出现的非科学化、浅表层或因果缺失的逻辑模式。通过对被自动标注器标记为缺乏科学推理的轨迹进行人工审查,研究者能够系统性地识别并分类智能体在多种环境与任务难度下的认知失败模式,从而推动对智能体推理鲁棒性、可靠性及其科学认知能力的深度理解,为构建更具科学素养的人工智能系统奠定方法基础。
衍生相关工作
基于该数据集,一系列关于科学智能体推理行为分类学的后续工作得以开展,催生了如科学认知模式标注框架(epistemic patterns annotation framework)、智能体失败模式分类体系等衍生成果。这些工作进一步拓展了对大型语言模型在科学推理任务中的局限性分析,推动了专门用于检测智能体非科学化推理的自动评估工具的发展,并为设计更具反思能力的智能体架构(如结合结构化推理验证的模块)提供了经验支撑与数据驱动的研究基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

