nazlicanto/persona-based-chat
收藏资源简介:
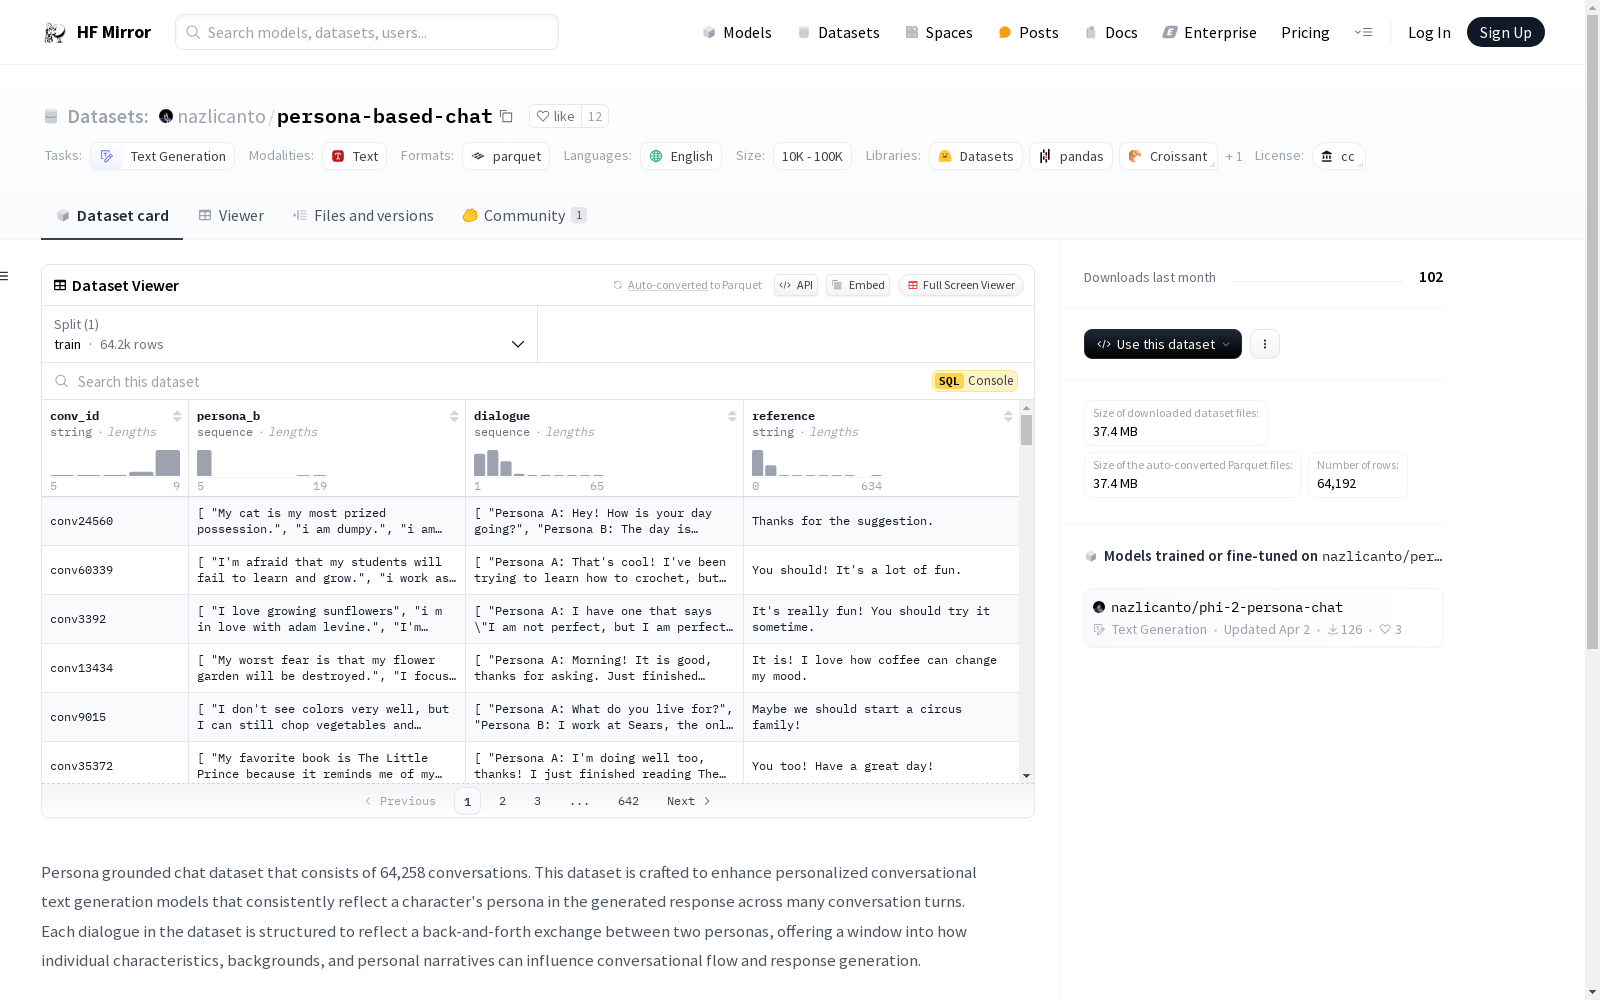
Persona Based Commonsense Dialogue Dataset是一个包含64,258个对话的数据集,旨在增强个性化对话文本生成模型,使其在生成的响应中能够一致地反映角色的个性。每个对话都反映了两个角色之间的交流,展示了个人特征、背景和叙事如何影响对话流程和响应生成。数据字段包括对话的唯一标识符、角色B的个性事实列表、对话轮次列表以及基于角色B视角的参考响应。数据集的创建结合了半手工制作的基于个性的聊天生成数据集和Google Research的Synthetic Persona Chat数据集的部分改写和工程化版本,使用了ChatGPT-3.5和Claude进行改写,并手动整理了结果。
Persona Based Commonsense Dialogue Dataset是一个包含64,258个对话的数据集,旨在增强个性化对话文本生成模型,使其在生成的响应中能够一致地反映角色的个性。每个对话都反映了两个角色之间的交流,展示了个人特征、背景和叙事如何影响对话流程和响应生成。数据字段包括对话的唯一标识符、角色B的个性事实列表、对话轮次列表以及基于角色B视角的参考响应。数据集的创建结合了半手工制作的基于个性的聊天生成数据集和Google Research的Synthetic Persona Chat数据集的部分改写和工程化版本,使用了ChatGPT-3.5和Claude进行改写,并手动整理了结果。
数据集概述
数据集名称
Persona Based Commonsense Dialogue Dataset
数据集信息
- 语言: 英语
- 许可证: CC
- 任务类别: 文本生成
数据集特征
- conv_id: 字符串类型,每个对话的唯一标识符。
- persona_b: 字符串序列,描述persona B的属性和经历。
- dialogue: 字符串序列,包含对话轮次,每个对话以Persona A的响应开始和结束。
- reference: 字符串类型,基于persona B的视角和给定对话的参考响应。
数据集划分
- 训练集:
- 数据量: 75615979字节
- 样本数: 64192
- 下载大小: 37368534字节
数据集创建
该数据集结合了半手动创建的基于角色的聊天生成数据集和部分改写及工程化的Synthetic Persona Chat数据集。改写和数据集生成使用了ChatGPT-3.5和Claude,并进行了手动精选。