
bethgelab/revengebench
收藏官方服务:
资源简介:
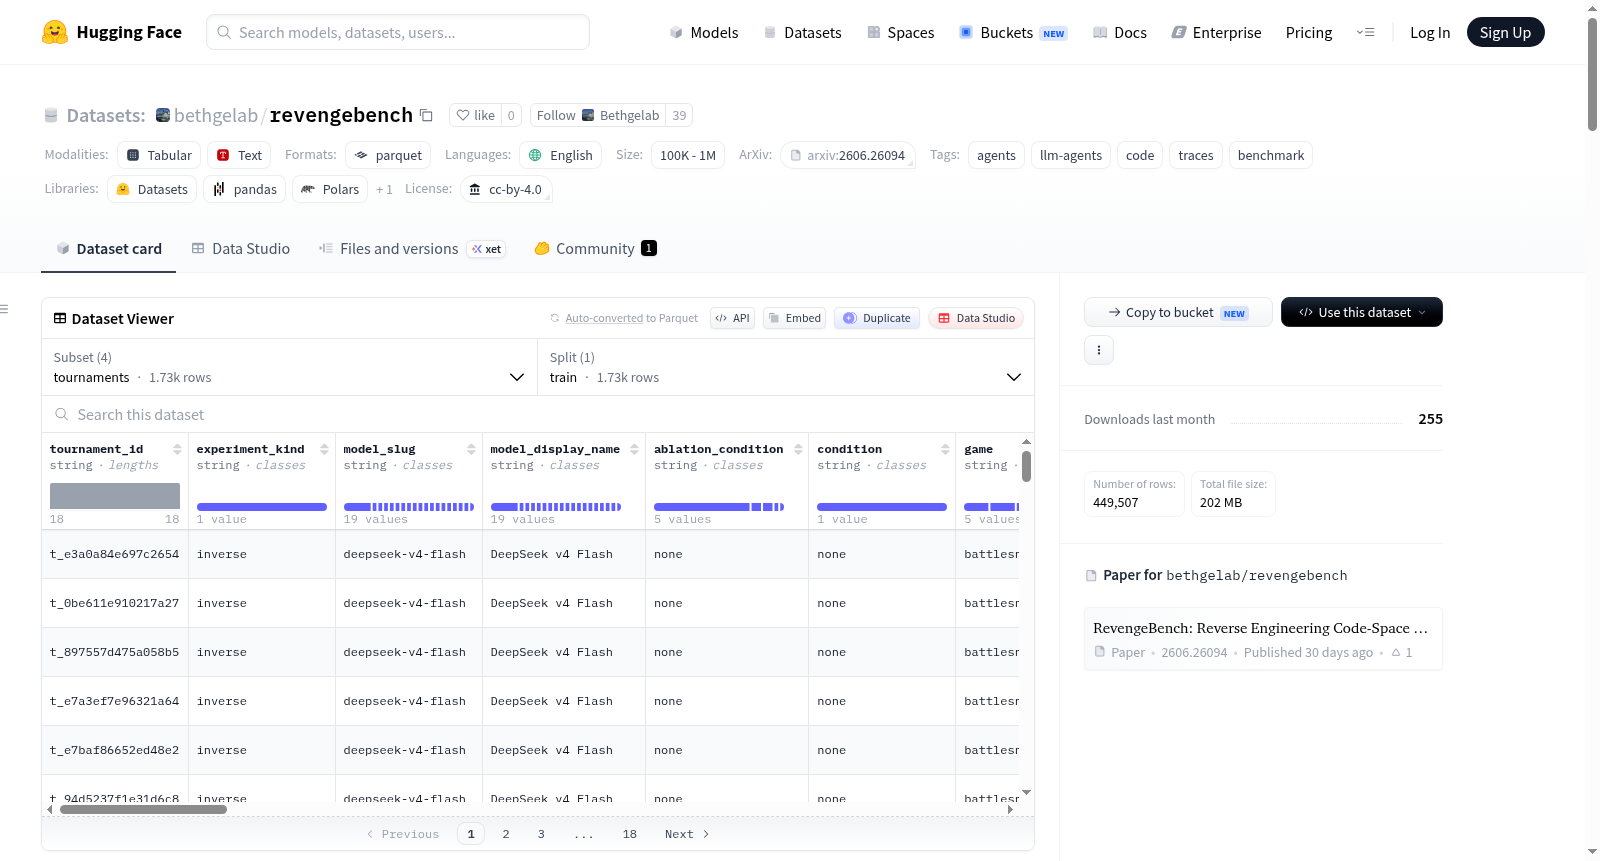
RevengeBench Traces 数据集包含RevengeBench锦标赛的每消息轨迹和每轮模拟结果,这些数据已规范化为四个Parquet表,并通过`tournament_id`和`config_id`进行连接。该数据集用于支持行为实验中的代码空间策略逆向工程研究,具体包括代理代码编辑行为、策略恢复、科学推理分析、评估方法以及大型语言模型的行为消融等用途。数据以结构化表格形式存储,涵盖锦标赛、消息、模拟和实验配置等信息,适用于自然语言处理和机器学习领域的研究。
Per-message traces and per-round simulation outcomes for RevengeBench tournaments, normalized into four Parquet tables joined by `tournament_id` and `config_id`.
提供机构:
bethgelab搜集汇总
数据集介绍
构建方式
RevengeBench数据集的构建源于对智能体代码编辑行为的系统性实验。研究人员通过设计多轮锦标赛(tournaments)形式的交互环境,让不同的大语言模型(LLM)在预设的游戏规则下执行逆向工程任务。每场锦标赛包含多个回合,记录模型生成的消息序列、模拟对战结果以及实验配置参数。这些原始日志经过标准化处理,被组织为四个Parquet表格(tournaments、messages、simulations、experiment_configs),并通过tournament_id和config_id进行关联。构建过程注重可复现性,每个锦标赛行都标注了其加入数据集的版本号,便于研究者追踪数据来源和演化。
特点
该数据集的核心特色在于其多层次、多维度的结构设计,完美兼顾了宏观评估与微观分析的需求。tournaments表提供锦标赛级别的聚合指标,如最佳距离、总Token消耗和成本;messages表则记录了每一步交互的详细内容,包括角色、思考和工具调用。特别地,JSON编码的嵌套列(如distances、per_round_usage)既保持了数据完整性,又允许按回合细粒度解析。此外,通过ablation_condition字段,数据集囊括了不同推理努力度设置下的模型表现变体,为研究LLM行为消融提供了宝贵窗口。
使用方法
使用RevengeBench数据集建议采用Parquet格式的高效读取方式。推荐通过pyarrow或pandas直接加载表格数据,对于tournaments表中的JSON编码列,需使用json.loads进行解析以获取结构化的回合级信息。典型分析流程包括:基于tournament_id将messages或simulations表与tournaments表进行连接,从而按模型、游戏或消融条件筛选数据。研究人员可计算各模型在不同任务中的成功率、Token效率及策略分布,也可深入分析messages表格中的推理轨迹。需注意,HuskyBench类型的锦标赛在simulations表中对应对手字段为null,而Codex消融实验中的成本字段统一为零。
背景与挑战
背景概述
RevengeBench数据集由Babak Rahmani、Sebastian Dziadzio、Joschka Strüber、Sergio Hernández-Gutiérrez和Matthias Bethge等研究人员于2026年创建,旨在通过行为实验逆向工程智能体在代码空间中的策略行为。该数据集聚焦于大型语言模型(LLM)智能体在编程任务中的决策过程,通过记录智能体在博弈中的逐轮交互轨迹和模拟结果,为研究智能体代码编辑行为、策略恢复和科学推理分析提供了标准化基准。作为新兴的智能体行为评估工具,RevengeBench填补了现有数据集在细粒度策略逆向工程方面的空白,对理解LLM智能体的底层策略逻辑和评估其鲁棒性具有重要推动作用。
当前挑战
该数据集面临的核心挑战在于所解决的领域问题:现有基准难以深入揭示LLM智能体在代码空间中的策略形成机制,而RevengeBench需要设计多轮博弈实验架构,以捕捉智能体在面对不同对手和任务时的动态适应过程。构建过程中遇到的挑战包括:确保不同模型(如GPT-5、Grok-4.1-fast等)在统一实验框架下的公平比较,处理大模型输出内容的许可约束(需遵守上游提供商服务条款),以及管理大规模、多维度指标(如token消耗、推理成本、探测失败率)的复杂JSON编码结构,同时维持数据版本迭代的兼容性与可重现性。
常用场景
经典使用场景
RevengeBench数据集为研究大型语言模型(LLM)在代码空间中的行为策略提供了核心实验平台。该数据集记录了多个模型在锦标赛式代码编辑任务中的完整交互轨迹,包含逐轮消息、模拟对战结果及实验配置等结构化信息。研究者可利用这些细粒度数据,剖析智能体在代码修复、策略迭代和对抗性博弈中的决策过程。数据集特别适用于逆向工程LLM的代码空间策略,通过分析模型在不同条件(如消融设置、对手目标)下的行为差异,揭示其内在推理机制与偏好。这一经典使用场景为理解AI智能体的可解释性与策略鲁棒性奠定了基础。
衍生相关工作
基于RevengeBench,研究者已衍生出多项开创性工作。例如,有人沿着‘行为克隆’路径,利用消息序列数据训练轻量级代理模型,实现策略的知识蒸馏;另有工作聚焦于‘策略扰动分析’,通过注入对抗性代码片段观察模型策略突变点,由此催生了细粒度鲁棒性评估新框架。数据集中的模拟结果还启发了‘多智能体博弈均衡’研究,学者们据此构建了LLM在零和代码博弈中的纳什策略近似模型。这些衍生工作共同拓宽了LLM行为科学的研究边界,将逆向工程方法从静态代码分析推向动态策略推理的新范式。
数据集最近研究
最新研究方向
RevengeBench数据集聚焦于通过行为实验逆向工程代码空间策略的前沿研究,为大型语言模型(LLM)在代码编辑任务中的策略恢复与推理分析提供了关键支撑。该数据集记录了多轮锦标赛中智能体的交互轨迹、模拟结果及实验配置,推动了LLM行为可解释性与评估方法学的突破。近期热点包括利用Codex CLI智能体进行的消融实验,以及GPT-5系列、Grok-4.1等先进模型的基准测试,这些工作揭示了不同推理努力水平下智能体的策略差异与资源消耗模式。RevengeBench的发布不仅为智能体行为科学化分析建立了标准化评估框架,更深化了我们对LLM在动态代码环境中的决策机制与适应能力的理解,对构建可信赖、可审计的自主智能体系统具有深远意义。
以上内容由遇见数据集搜集并总结生成


