
遇见数据集

AOS-Trajectories

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

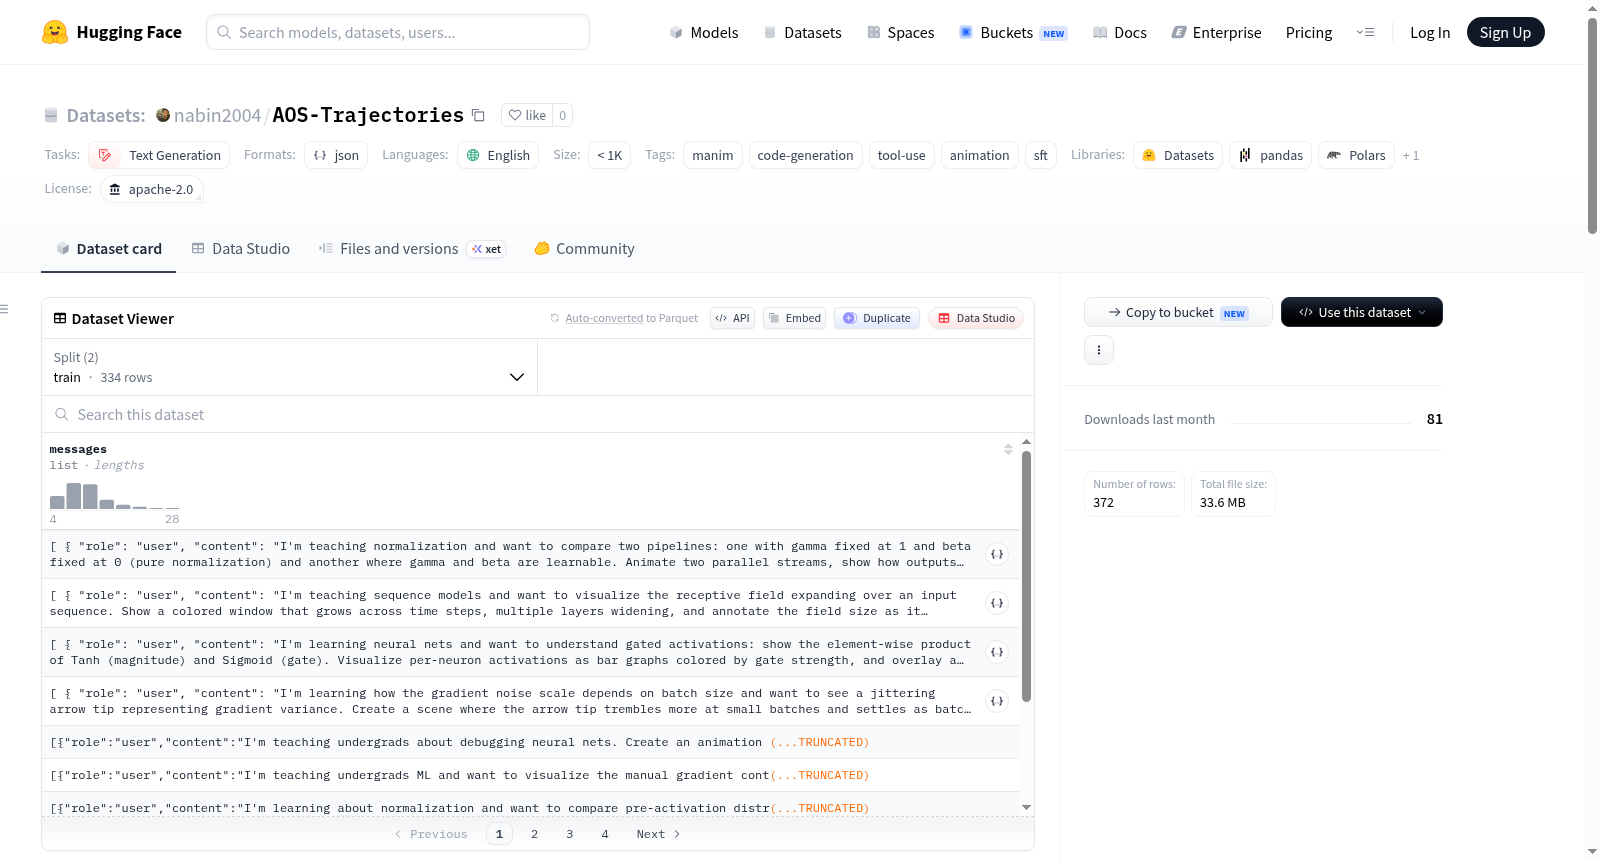
AOS-Trajectories是一个专门用于代码代理工具调用轨迹的数据集,旨在为大型语言模型(LLMs)在Manim动画生成任务上进行微调提供数据支持。该数据集包含两种主要数据格式:原始代理轨迹和OpenAI风格的多轮工具调用轨迹。原始轨迹数据记录了从用户提示开始到最终生成可成功运行的Manim Python脚本的完整工具调用序列,每个样本包括用户提示、工具步骤列表(含类型、工具名称、输入、输出和错误标志)、最终代码、可选的叙述摘要以及成功状态等字段。工具轨迹数据则被处理成适用于工具使用或代码模式微调的多轮对话格式,包含用户、助理和工具角色之间的交互消息。数据集规模小于1000个样本,主要用于监督微调(SFT)阶段,以提升LLMs在理解和执行Manim动画编程任务中的工具调用与代码生成能力。数据通过AOS代码代理收集并导出,适用于动画生成、代码生成和工具使用等研究与应用场景。

AOS-Trajectories is a dataset specifically designed for code agent tool-call trajectories, aimed at providing data support for fine-tuning large language models (LLMs) on Manim animation generation tasks. As part of the AOS project, it includes two main data formats: raw agent trajectories and OpenAI-style multi-turn tool-call trajectories. The raw trajectory data records the complete sequence of tool calls from user prompts to the final generation of a successfully executable Manim Python script, with each sample containing fields such as user prompts, a list of tool steps (including type, tool name, input, output, and error flags), final code, optional narrative summaries, and success status. The tool trajectory data is processed into a multi-turn dialogue format suitable for tool usage or code pattern fine-tuning, involving interaction messages among user, assistant, and tool roles. The dataset contains less than 1000 samples and is primarily used for the supervised fine-tuning (SFT) phase to enhance LLMs capabilities in tool calling and code generation for understanding and executing Manim animation programming tasks. Data is collected and exported via the AOS code agent, making it applicable to research and application scenarios such as animation generation, code generation, and tool usage.

创建时间:
2026-07-23
搜集汇总
数据集介绍
AOS-Trajectories 数据集图片
构建方式
AOS-Trajectories数据集源自AOS项目,其构建依托于精心设计的代码代理(coder_agent.py)与轨迹采集流水线(collect_traces.py)。系统通过向大语言模型投放约8000条合成提示,引导其生成Manim动画代码,并记录每一步工具调用、输入输出及错误状态。经过编译验证筛选,最终保留约5000条成功轨迹,经export_local_sft.py脚本导出为标准格式。该过程结合了LoRA微调策略,确保数据的高效迭代与质量把控。
特点
该数据集的显著特色在于其双轨设计:原始轨迹(trajectories.jsonl)存储了完整的工具调用链、错误标记与最终代码,适合阶段一的监督微调;而工具追踪(tool_trace)则采用OpenAI兼容的多轮对话结构,包含用户指令、助手响应及工具调用记录,便于模型学习工具使用与代码生成。此外,元数据文件(metadata.jsonl)支持对运行日志进行过滤与分析,提升了数据筛选的灵活性。
使用方法
用户可通过HuggingFace Datasets库便捷加载数据。加载原始轨迹时,使用load_dataset函数指向trajectories.jsonl文件即可;若需训练工具调用能力,则可分别加载tool_trace目录下的train.jsonl与val.jsonl。该数据集亦无缝集成AOS项目中的SFT训练器,用户仅需运行指定脚本(uv run python run.py)即可启动微调流程,降低了使用门槛。
背景与挑战
背景概述
AOS-Trajectories数据集由研究者Nabin等人于近期创建,隶属于AOS项目,旨在推动大语言模型在Manim动画生成领域中的代码智能体工具调用能力。该数据集的核心研究问题聚焦于如何通过微调(SFT)使语言模型掌握多步工具调用轨迹,从而将自然语言描述转化为可执行的Manim Python脚本。通过记录智能体从用户提示到最终成功代码的完整交互路径,该数据集为代码生成与工具使用结合的范式提供了标准化训练资源,对于提升语言模型在动画生成这类复杂任务中的实用性与可靠性具有重要影响。
当前挑战
该数据集面临的挑战首先源自领域问题本身:Manim动画生成需要模型精准理解空间几何、时间序列与图形渲染逻辑,并将抽象的叙事描述转化为结构化代码,这对语言模型的语义解析与代码合成能力提出了极高要求。在构建过程中,团队需应对从约8k条合成提示中筛选出约5k条编译通过轨迹的显著损耗,同时确保工具调用记录的完整性与一致性,避免因智能体多步操作中的错误累积而导致训练数据质量下降。如何平衡数据规模与轨迹成功率,并设计出广泛适用的工具调用Schema,是当前数据集建设的核心难点。
常用场景
经典使用场景
AOS-Trajectories数据集的核心经典用途在于对大型语言模型进行指令微调,以增强其生成Manim动画代码的能力。该数据集记录了代码智能体在执行动画生成任务时的完整工具调用轨迹,包括用户指令、中间推理步骤、工具调用输入输出以及最终成功编译的Python脚本。研究者可利用这些轨迹对基础模型进行监督式微调,从而显著提升模型在数学动画领域的代码生成质量与工具使用准确性。
解决学术问题
该数据集解决了代码生成领域一个关键学术难题:如何让大语言模型学会在复杂工具调用环境中通过多步推理产生可执行代码。传统文本生成数据集常忽略中间工具交互过程,导致模型缺乏分解复杂任务与纠错能力。AOS-Trajectories通过提供完整的成功与失败轨迹,使研究者能够探索工具增强型推理、错误恢复机制以及多步代码规划,为具身智能与程序合成研究提供了宝贵的数据基础。
衍生相关工作
该数据集衍生了一系列重要工作,最典型的是与ManiBench(一个用于GRPO奖励评估的基准数据集)形成互补,共同构建了从模型训练到性能验证的完整闭环。此外,基于AOS-Trajectories的LoRA微调方案和分阶段数据生成管道(从约8000个合成提示到约5000个编译成功轨迹)为低资源场景下的大模型适配提供了可复现范例,相关代码库及数据生成脚本已在GitHub上开源,推动了开源社区在代码智能体研究方面的协作进展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

