
LUOHANYU/ESconvpre5
收藏官方服务:
资源简介:
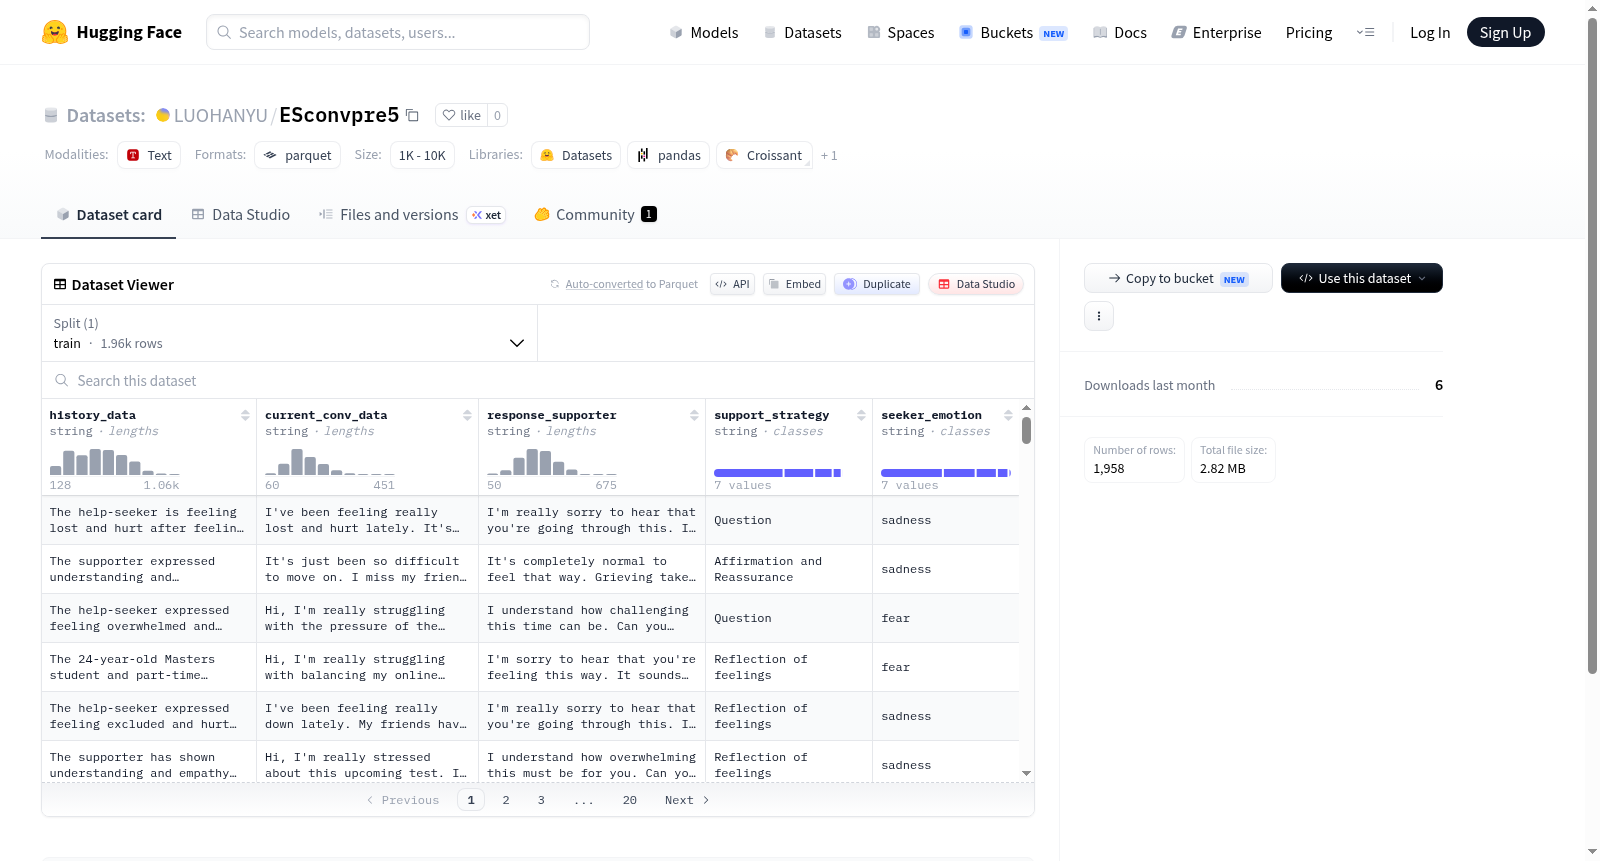
该数据集包含历史数据、当前对话数据、支持者响应、支持策略和寻求者情绪等特征。数据集分为一个训练集,包含1958个样本,总大小为1978425字节。下载大小为722800字节。
This dataset includes features such as history data, current conversation data, supporter response, support strategy, and seeker emotion. The dataset is divided into a training set containing 1958 samples, with a total size of 1978425 bytes. The download size is 722800 bytes.
提供机构:
LUOHANYU原始信息汇总
数据集概述
数据集信息
- 特征:
history_data: 类型为stringcurrent_conv_data: 类型为stringresponse_supporter: 类型为stringsupport_strategy: 类型为stringseeker_emotion: 类型为string
数据集划分
- 训练集:
- 名称:
train - 字节数: 1978425
- 样本数: 1958
- 名称:
数据集大小
- 下载大小: 722800 字节
- 数据集大小: 1978425 字节
配置
- 配置名称:
default- 数据文件:
- 划分:
train - 路径:
data/train-*
- 划分:
- 数据文件:
搜集汇总
数据集介绍
构建方式
在情感支持对话研究领域,高质量的数据集是驱动模型理解复杂人际交互的关键。LUOHANYU/ESconvpre5数据集基于对话历史与当前会话的上下文,精心构建了包含支持策略与求助者情绪标签的多维度结构。每条数据由历史对话序列、当前交互轮次、支持者回应、支持策略分类及求助者情绪状态五部分构成,确保了对话逻辑的连贯性与情感维度的完整性。数据集共收录1958条训练样本,以JSON格式存储,便于高效加载与解析。
使用方法
使用者可通过HuggingFace的datasets库直接加载该数据集,指定配置名为'default'并选择'train'划分即可获取全部样本。每条数据以字典形式返回,包含'history_data'、'current_conv_data'、'response_supporter'、'support_strategy'及'seeker_emotion'五个字段。推荐将数据用于训练基于Transformer的对话模型,通过将支持策略与情绪标签作为辅助损失函数,优化模型在情感支持任务上的表现。
背景与挑战
背景概述
在心理健康支持领域,对话系统的发展日益受到关注,尤其是面向情绪支持场景的智能交互技术。LUOHANYU/ESconvpre5数据集由研究团队创建,专注于情绪支持对话的预处理与策略分析,其核心研究问题在于如何通过结构化对话数据提升支持性回应生成的准确性与共情能力。该数据集包含历史对话、当前会话、支持者回应、支持策略及求助者情绪等多维特征,为构建更具人性化的心理支持模型提供了基础资源。尽管数据集规模有限(训练集含1958条样本),但其精细的标注维度为情感计算与人机交互研究开辟了新路径,尤其在探索支持策略与情绪识别之间的关联方面具有潜在影响力。
当前挑战
当前数据集面临的核心挑战包括:其一,情绪支持对话领域长期受困于数据稀缺与标注复杂性,求助者情绪的动态变化及支持策略的多样性难以被有限样本充分覆盖,这限制了模型泛化能力;其二,构建过程中需平衡隐私保护与数据真实性,对话记录可能涉及敏感心理信息,而人工标注情感标签与策略类型时易引入主观偏差。此外,现有数据规模(约1.9MB)难以支撑深度神经网络的训练需求,数据增强与跨领域迁移学习成为亟待突破的瓶颈。这些挑战不仅影响模型在真实场景中的鲁棒性,也阻碍了情绪支持系统从实验研究向临床应用的转化进程。
常用场景
经典使用场景
LUOHANYU/ESconvpre5数据集深耕于心理咨询对话系统领域,其经典使用场景在于训练和评估面向情绪支持的心理健康对话模型。该数据集精心构建了心理咨询师与来访者之间的多轮对话历史、当前对话内容、支持策略及来访者情绪标签,为研究者提供了结构化的交互样本。通过利用这些数据,模型能够学习在对话中识别来访者的情绪状态,并据此生成具有共情性和策略性的回复,从而模拟专业心理咨询师的支持行为。这一场景不仅推动了情感计算与对话系统的交叉研究,还为构建更自然、更具人文关怀的人机交互系统奠定了数据基础。
解决学术问题
该数据集核心解决了学术研究中情感支持对话系统缺乏高质量、结构化训练资源的瓶颈问题。传统对话数据集多聚焦于任务导向或闲聊,而忽视了心理健康场景中情绪识别与策略性回复的复杂性。ESconvpre5通过标注支持策略(如积极倾听、认知重构)和来访者情绪,使得研究者能够系统性地探索如何将心理学理论融入对话模型,量化评估模型在情绪支持任务上的表现。其意义在于为情感对话系统的可解释性研究提供了基准,促进了从单纯的语言生成向具有治疗意图的智能交互的范式转变,对情感计算、人机交互和计算心理学领域产生了深远影响。
实际应用
在实际应用中,ESconvpre5数据集驱动的模型可被部署于在线心理健康服务平台,作为初级情绪支持工具。例如,在用户表达焦虑或抑郁情绪时,系统能根据历史对话与当前语境,自动选择合适的支持策略(如提供安慰或引导自我反思),从而缓解用户心理压力。此外,该数据集还可用于训练心理咨询师辅助系统,帮助专业人员快速分析来访者的情绪变化并推荐干预策略。这类应用显著降低了心理健康服务的门槛,尤其适用于偏远地区或资源匮乏场景,为大规模、低成本的普惠心理关怀提供了技术可行性。
数据集最近研究
最新研究方向
在心理健康与情感计算交叉领域,LUOHANYU/ESconvpre5数据集聚焦于对话式情感支持的前沿探索。该数据集通过结构化记录求助者情绪状态、支持策略及对话历史,为构建可感知用户情绪并动态调整响应策略的智能对话系统提供了训练基础。当前研究热点集中在利用该数据集训练大语言模型,以模拟专业咨询师的共情回应与策略性引导,推动AI在心理危机干预、在线情感陪伴等场景中的落地应用。其意义在于将非结构化的情感支持对话转化为可量化的多维度标签体系,为开发具有社会价值的情感AI奠定数据基石,呼应了全球对数字心理健康解决方案日益增长的需求。
以上内容由遇见数据集搜集并总结生成


