silkome-masp-idv-grouped
收藏资源简介:
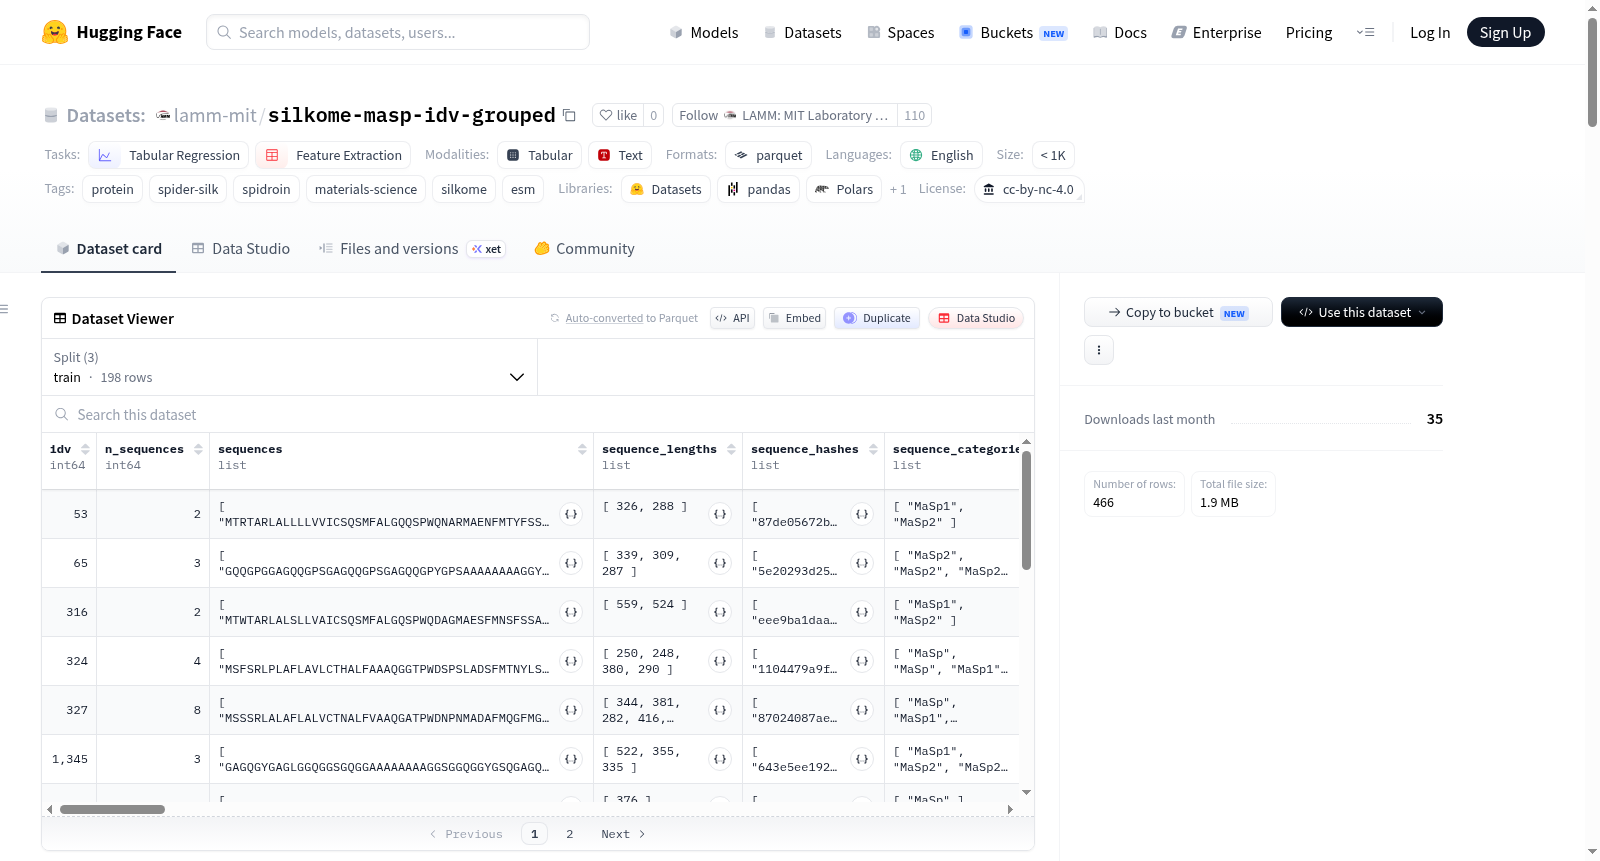
Silkome MaSp Idv Grouped 是一个用于从主要壶腹丝蛋白(MaSp)序列集预测蜘蛛拖丝纤维力学性能的数据集。该数据集由源数据集 lamm-mit/silkome-masp 衍生而来,其核心创新在于将具有相同测量纤维/属性标识符(idv)的多个 MaSp 蛋白序列行分组为一个样本,形成“{某个idv对应的MaSp序列集合} -> {韧性、杨氏模量、强度、应变}”的映射关系。这种 formulation 专为 ESMC 嵌入模型及后续的集合级聚合模型设计。数据集包含 233 个唯一的 idv 分组样本,划分为训练集(198 个样本)和测试集(35 个样本),划分基于源数据集的 benchmark_split,确保了训练集与测试集在 idv 和四元组属性上零重叠。分组前共有 1033 个源序列行,分组后每个 idv 包含的序列数量中位数为 4,最大序列长度为 5896 个残基。数据覆盖了 MaSp、MaSp1、MaSp2、MaSp2B、MaSp3、MaSp3B 等多种丝蛋白类别。每个样本提供了详细的序列信息(氨基酸序列列表、序列类别、长度、哈希值)、组成与元数据(物种分类、性别、NCBI标识符、各类别丝蛋白的计数统计)以及四个关键的纤维力学性能目标值(韧性、杨氏模量、强度、应变)及其标准差和归一化版本。为方便使用,还提供了序列的FASTA格式文本、以25个‘X’残基连接的串联序列等表示形式。本数据集旨在支持基于分组丝蛋白序列集的纤维级力学性能预测研究,特别是 ESMC 嵌入结合集合聚合(如平均池化、注意力池化、DeepSets、集合变换器)的模型基准测试,并可用于分析序列类别组成与性能之间的关系。其分组设计相比随机序列级划分能提供更安全的防数据泄露评估。需要注意的是,目标值是纤维级别的宏观测量,并非单个蛋白质的直接标签,且纤维性能还受实验、环境、纺丝、结构及翻译后修饰等多种因素影响。
Silkome MaSp Idv Grouped is a dataset for predicting the mechanical properties of spider dragline silk fibers from a set of major ampullate spidroin (MaSp) sequences. It is derived from the source dataset lamm-mit/silkome-masp, with the core innovation being the grouping of multiple MaSp protein sequence rows with the same measured fiber/property identifier (idv) into a single sample, forming a mapping relationship of {MaSp sequence set corresponding to a specific idv} -> {toughness, Youngs modulus, strength, strain}. This formulation is specifically designed for ESMC embedding models and subsequent set-level aggregation models. The dataset contains 233 unique idv grouped samples, divided into a training set (198 samples) and a test set (35 samples), based on the benchmark_split of the source dataset, ensuring zero overlap in idv and quadruple properties between the training and test sets. Before grouping, there were 1033 source sequence rows; after grouping, the median number of sequences per idv is 4, with a maximum sequence length of 5896 residues. The data covers various silk protein categories such as MaSp, MaSp1, MaSp2, MaSp2B, MaSp3, and MaSp3B. Each sample provides detailed sequence information (amino acid sequence list, sequence category, length, hash value), composition and metadata (species classification, gender, NCBI identifier, count statistics for each silk protein category), and four key fiber mechanical property target values (toughness, Youngs modulus, strength, strain) along with their standard deviations and normalized versions. For ease of use, it also includes representations such as FASTA format text of sequences and concatenated sequences connected by 25 X residues. This dataset aims to support research on fiber-level mechanical property prediction based on grouped silk protein sequence sets, particularly for benchmarking models that combine ESMC embedding with set aggregation (e.g., average pooling, attention pooling, DeepSets, set transformers), and can be used to analyze the relationship between sequence category composition and performance. Its grouped design provides a safer evaluation against data leakage compared to random sequence-level partitioning. It should be noted that the target values are macroscopic measurements at the fiber level, not direct labels for individual proteins, and fiber performance is also influenced by various factors such as experimental conditions, environment, spinning, structure, and post-translational modifications.