alkintin/huchenfeng-dataset
收藏资源简介:
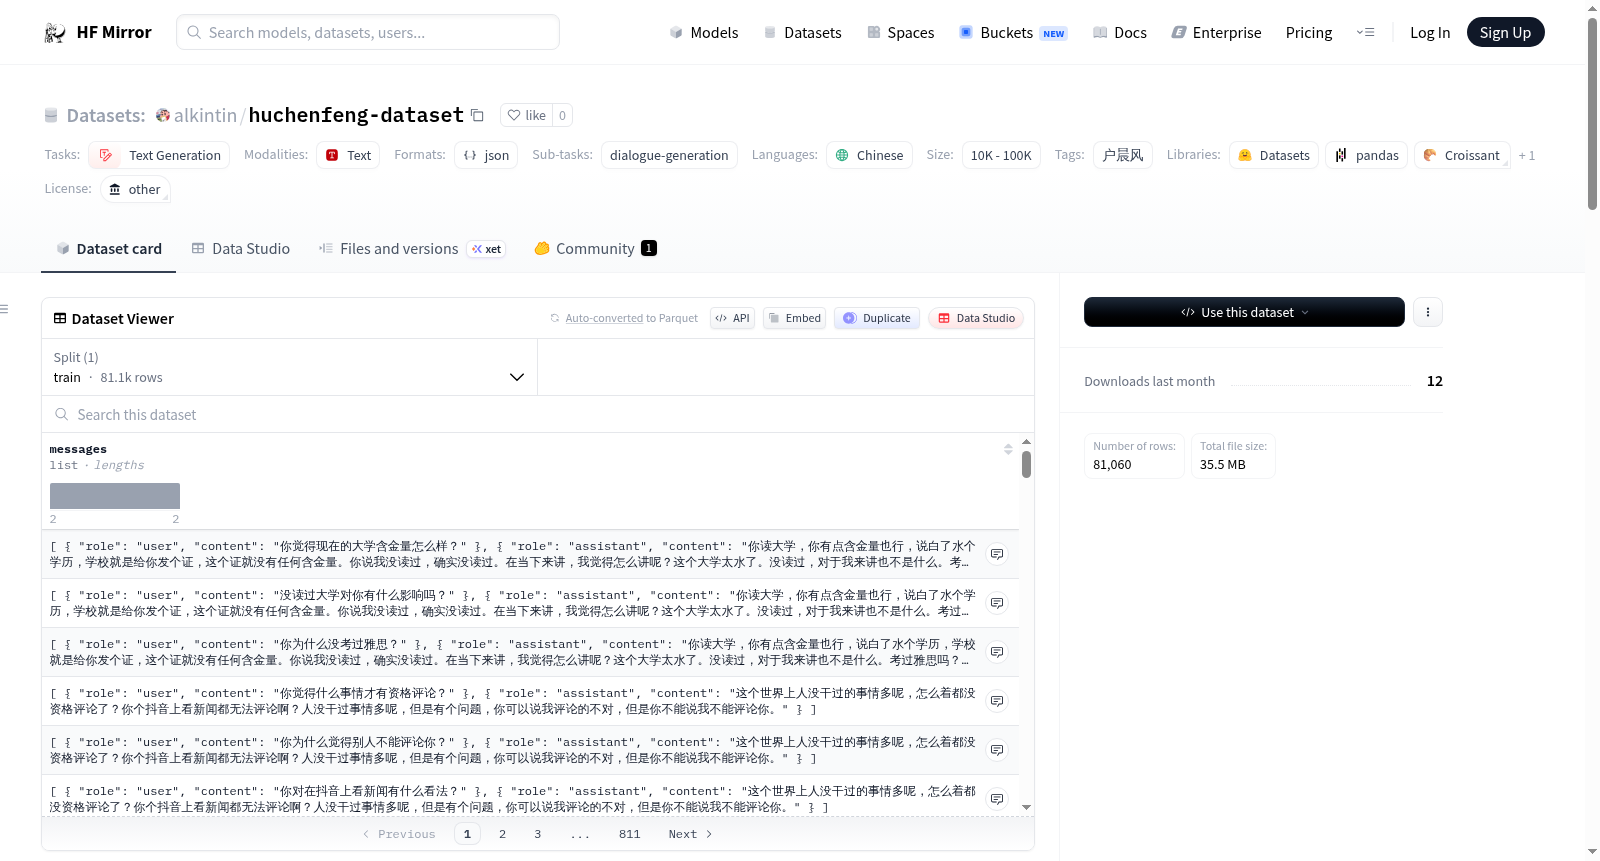
--- language: - zh license: other pretty_name: HuChenFeng Dialogue Dataset size_categories: - 50K<n<100K task_categories: - text-generation task_ids: - dialogue-generation source_datasets: - original tags: - 户晨风 --- # Dataset Card: HuChenFeng Dialogue Dataset ## Dataset Summary HuChenFeng Dialogue Dataset 收录了 81,060 条高质量的中文单轮对话,每条样本由一个「用户」提问与一段长篇的「主播」回答组成,完整保留了知名主播 **户晨风** 的口语化表达、情绪变化与节奏。原始素材来自 2023–2025 年的直播转录,先经 Whisper Large-v3 语音识别,再由 Gemini-2.5-Flash 清洗去噪,最终使用 Gemini-2.5-Flash-Lite 为每段回答生成 3–5 个不同角度的问题。生成的问题与对应原回答经人工与规则联动过滤,最后导出为 `question_answer.jsonl`(ChatML 风格 `messages` 列表),可直接用于监督微调(SFT)、LoRA/QLoRA、角色扮演代理构建等任务。 * **规模**:81,060 条问答对(≈2.8B tokens,Qwen 分词),平均问题 18.3 个中文字,回答 342.7 个中文字。 * **格式**:JSON Lines,每行一个样本,字段同 `transformers` ChatML(`user` → `assistant`)。 * **来源**:户晨风 2023–2025 年[直播转录](https://github.com/Olcmyk/HuChenFeng)。 * **用途**:适合训练中文风格迁移、长篇回答、直播带货口吻或人格化聊天的模型,也可作为 prompt 工程与数据合成案例。 ## Supported Tasks and Leaderboards - **Dialogue / Instruction Tuning**:训练中文问答、角色扮演、对话安全或记忆模块。 - **Data Augmentation**:可为其他中文会话系统提供长篇回答示例。 ## Languages - **Input language**:Simplified Chinese (zh-Hans),包含大量口语、俚语、幽默用法以及中文夹杂口头禅。 ## Dataset Structure ### Data Instances ```json { "messages": [ {"role": "user", "content": "你觉得现在的大学还有含金量吗?"}, {"role": "assistant", "content": "你读大学,你有点含金量也行,说白了水个学历..."} ] } ``` 回答通常是 1–3 段长文本,保持主播原始口吻;不同问题可能指向相同回答,以保留多问法效果。 ### Data Fields - `messages` *(List[Dict])*:标准 ChatML 对话列表,长度固定 2。 - `role` *(str)*:`"user"` 或 `"assistant"`。 - `content` *(str)*:UTF-8 中文文本,已去除 Markdown/表情符号,仅保留原生口语。 ## Data Collection ### Curation Rationale - 通过公开直播内容构建能体现主播人格、语速、逻辑跳跃等特征的风格化语料,填补中文口语 LoRA/SFT 数据缺口。 ### Source Data #### Initial Data Collection and Normalization 1. **语音转文字**:户晨风 2023–2025 直播音频 → Whisper Large-v3(≈200 万字)。 2. **转录切分**:仅保留 ≥200 字的完整段落,分月归档 (`dataset/2024年05月/*.md` 等)。 3. **语料清洗**:Gemini-2.5-Flash 删除噪声(读评论、重复口癖、背景音乐描述、ASR 错误)。 4. **问法生成**:Gemini-2.5-Flash-Lite 按段生成 3–5 个不同视角、语气提问。 5. **数据库存储**:写入 `raw_dialogues.db` → `train_dialogues`(长回答列表) → `question_answer_table`(问题、回答、模型版本、状态)。 6. **导出**:`train/generate_dataset.py` 过滤 `status=1` 且 `LEN(question)>2` 的行,输出 ChatML JSONL。 #### Who are the source language producers? - 主体为主播户晨风在直播中的即兴独白,问题由 Gemini-2.5-Flash-Lite 自动生成,再由开发者审核。 ## Annotations ### Annotation Process - 由自动问法生成 + 规则过滤 + 人工抽检。`status` 字段记录是否通过审核,只有通过记录会进入导出的 JSONL。 ### Who are the annotators? - 项目维护者(HuChenFeng 团队)负责审查脚本日志、抽样评估以及剔除不合格的问答对。 ## Citation 如果本数据集对你的工作有帮助,请引用本仓库: ```bibtex @misc{huchenfeng_dialogue_2024, title = {HuChenFeng Dialogue Dataset}, author = {tinymindkin and contributors}, howpublished = {GitHub repository}, url = {https://github.com/tinymindkin/huchenfeng}, year = {2024} } ``` ## Contributions - Dataset curators & maintainers: [@tinymindkin](https://github.com/tinymindkin) and HuChenFeng project collaborators. - 感谢 [Olcmyk/HuChenFeng](https://github.com/Olcmyk/HuChenFeng) 提供完整直播文字稿参考。
--- 语言: - 简体中文 许可证:其他 展示名称:户晨风对话数据集 样本规模分类: - 50000 < 样本数 < 100000 任务类别: - 文本生成 任务子类别: - 对话生成 源数据集: - 原创 标签: - 户晨风 --- # 数据集卡片:户晨风对话数据集 ## 数据集概览 户晨风对话数据集共收录81060条高质量中文单轮对话样本,每条样本均由1组「用户」提问与一段长篇「主播」回复构成,完整还原了知名主播**户晨风**的口语化表达、情绪起伏与叙事节奏。原始素材源自2023至2025年的直播转录内容,先通过Whisper Large-v3进行语音识别,再经Gemini-2.5-Flash完成降噪清洗,最终使用Gemini-2.5-Flash-Lite为每段回复生成3至5个不同视角的提问。生成的提问与对应原回复经人工与规则联动过滤后,导出为`question_answer.jsonl`(采用ChatML风格的`messages`列表格式),可直接用于监督微调(SFT)、LoRA/QLoRA、角色扮演AI智能体构建等任务。 * **规模**:共计81060组问答对(经Qwen分词器统计约含28亿Token),单条提问平均长度为18.3个中文字符,单条回复平均长度为342.7个中文字符。 * **格式**:采用JSON Lines格式,每行对应一条样本,字段与`transformers`库的ChatML格式保持一致(`user` → `assistant`)。 * **来源**:户晨风2023至2025年[直播转录内容](https://github.com/Olcmyk/HuChenFeng)。 * **用途**:适用于训练具备中文风格迁移能力、长篇回复生成、直播带货口吻或人格化聊天的模型,亦可作为提示词工程与数据合成的参考案例。 ## 支持任务与排行榜 - **对话/指令微调**:可用于训练中文问答、角色扮演、对话安全或记忆模块。 - **数据增强**:可为其他中文会话系统提供长篇回复生成示例。 ## 语言 - **输入语言**:简体中文(zh-Hans),包含大量口语表达、俚语、幽默用法及中文口头禅。 ## 数据集结构 ### 样本示例 json { "messages": [ {"role": "user", "content": "你觉得现在的大学还有含金量吗?"}, {"role": "assistant", "content": "你读大学,你有点含金量也行,说白了水个学历..."} ] } 回复通常为1至3段长文本,严格保留主播原始口吻;不同提问可对应同一段回复,以保留多提问视角的效果。 ### 数据字段 - `messages` *(List[Dict])*:标准ChatML对话列表,固定长度为2。 - `role` *(str)*:取值为`"user"`或`"assistant"`。 - `content` *(str)*:UTF-8编码中文文本,已去除Markdown格式与表情符号,仅保留原生口语内容。 ## 数据采集 ### 筛选逻辑 通过公开直播内容构建能够体现主播人格特征、语速特点、逻辑跳跃性等风格化语料,填补中文口语化LoRA/SFT训练数据的缺口。 ### 源数据 #### 初始采集与标准化流程 1. **语音转写**:将户晨风2023至2025年的直播音频通过Whisper Large-v3转换为文本(总字数约200万字)。 2. **转录切分**:仅保留长度≥200字的完整段落,并按月归档(如`dataset/2024年05月/*.md`等)。 3. **语料清洗**:使用Gemini-2.5-Flash删除噪声内容(如读评论环节、重复口癖、背景音乐描述、ASR识别错误等)。 4. **提问生成**:通过Gemini-2.5-Flash-Lite为每段回复生成3至5个不同视角、语气的提问。 5. **数据库存储**:将处理后的数据写入`raw_dialogues.db`的`train_dialogues`表(存储长回复列表)与`question_answer_table`表(存储提问、回复、模型版本与审核状态)。 6. **导出**:通过`train/generate_dataset.py`脚本过滤`status=1`且`LEN(question)>2`的条目,输出ChatML格式的JSONL文件。 #### 语料生产者 主体为主播户晨风在直播中的即兴独白,提问由Gemini-2.5-Flash-Lite自动生成后经开发者审核。 ## 标注 ### 标注流程 采用自动提问生成+规则过滤+人工抽检的三级审核机制。`status`字段用于记录审核结果,仅通过审核的条目才会被纳入最终导出的JSONL文件。 ### 标注人员 项目维护者(户晨风团队)负责审查脚本日志、抽样评估并剔除不合格的问答对。 ## 引用说明 若本数据集对你的研究工作有所帮助,请引用本仓库: bibtex @misc{huchenfeng_dialogue_2024, title = {HuChenFeng Dialogue Dataset}, author = {tinymindkin and contributors}, howpublished = {GitHub repository}, url = {https://github.com/tinymindkin/huchenfeng}, year = {2024} } ## 贡献 - 数据集整理与维护者:[@tinymindkin](https://github.com/tinymindkin)及户晨风项目协作成员。 - 感谢[Olcmyk/HuChenFeng](https://github.com/Olcmyk/HuChenFeng)提供完整直播文字稿参考。