
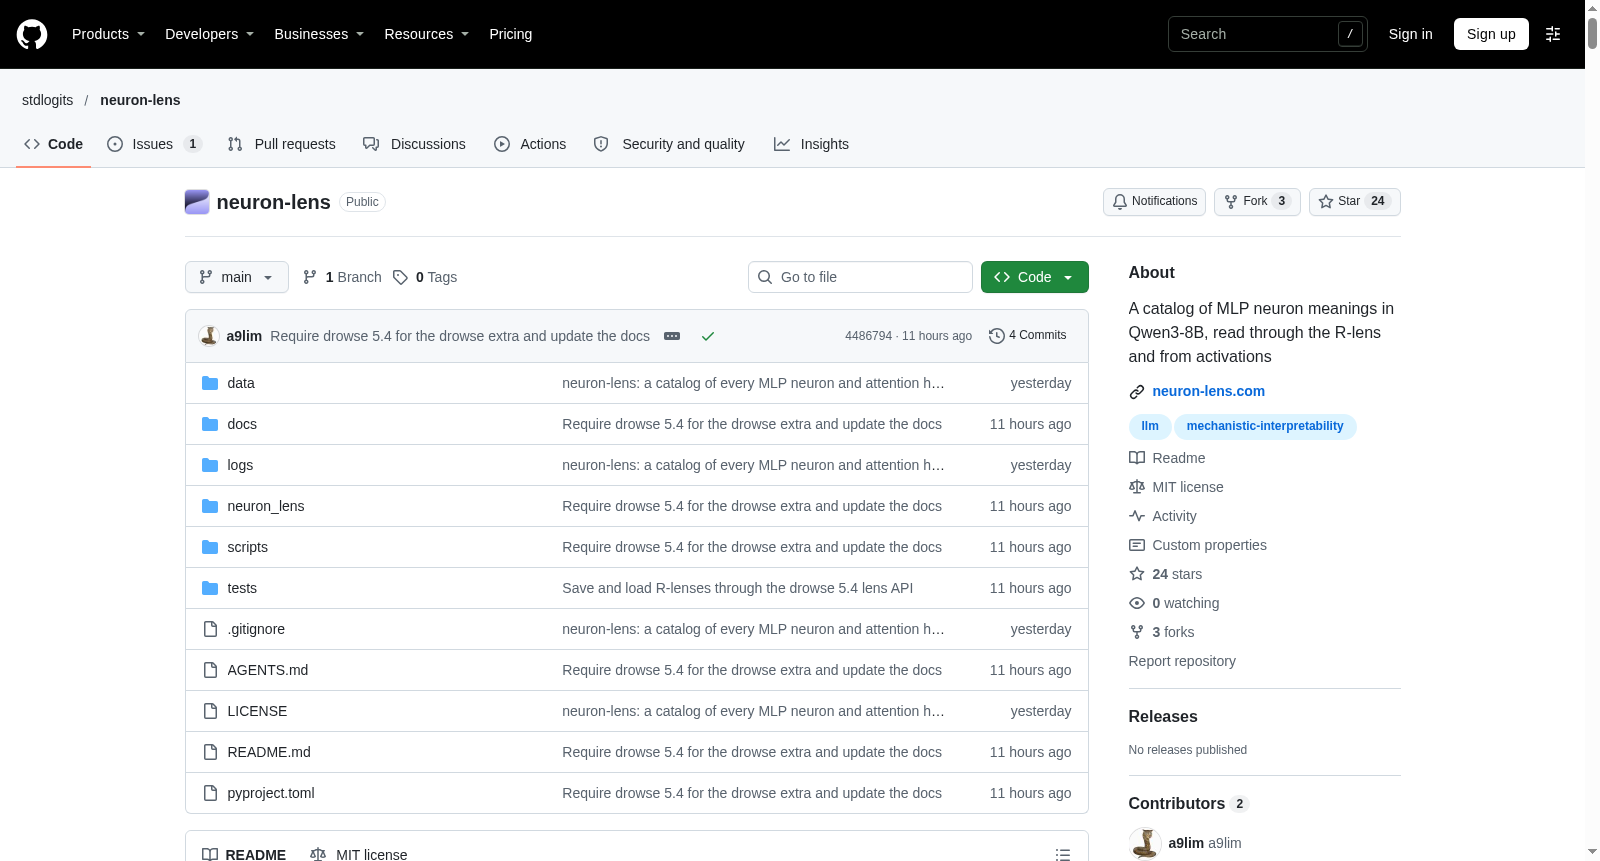
neuron-lens
收藏数据链接:
官方服务:
资源简介:
一个公开目录,包含Qwen3-8B和Gemma 4 12B中MLP神经元和注意力头的含义,包括通过R-lens和S-lens从权重读取的结果、在1500万token上的激活统计、token驱动因素、易读性测试、词语标签,以及Gemma 4对图像和声音的响应。
创建时间:
2026-10-30
原始信息汇总
neuron-lens 数据集详情总结
一、数据集定位与产出
- 项目目标:读取两个开放模型 Qwen3-8B 与 Gemma 4 12B 的每个 MLP 神经元和每个注意力头,解释模型各部分做什么。
- 读取方式:仅从权重通过两个 Jacobian lenses 读取;读取其在 15M tokens 真实文本上的行为;读取驱动它们的精确 tokens。
- Gemma 4 还支持图像与声音输入,因此其神经元也通过图像和声音读取。
- 产出包括:公共目录、生成目录的 lenses、以及每种读取方式在何处有效、在何处失败的测量结果。
主要资源
- Lenses:
stdlogits/rs-lenses,包含 Qwen3-8B 的 R-lens 与 S-lens,以及 Gemma 4 12B 在文本、图像、声音中的 lenses。
URL:https://huggingface.co/stdlogits/rs-lenses - Catalog:
stdlogits/neuron-lens,包含每个神经元和头的 reads、激活统计、token drivers、legibility tests、词语标签;Gemma 4 还包含每个神经元对图像和声音的响应。
URL:https://huggingface.co/datasets/stdlogits/neuron-lens - Results:https://github.com/stdlogits/neuron-lens/blob/HEAD/docs/findings.md
- Methods:https://github.com/stdlogits/neuron-lens/blob/HEAD/docs/design.md
- 数据集详情页地址:https://github.com/stdlogits/neuron-lens
- 作者:https://x.com/_a9lim 与 https://x.com/treetowntree,以及 Claude。
二、涉及模型与读取对象
| 模型 | 层数 | 每层头数 | 每层 MLP 神经元数 | 神经元条目数 | 头条目数 |
|---|---|---|---|---|---|
| Qwen3-8B | 36 | 32 | 12,288 | 884,736 | 1,152 |
| Gemma 4 12B | 48 | 16 | 15,360 | 1,474,560 | 768 |
- 每个神经元有
+与−两个 pole,因此神经元条目数按两个 pole 计数。 - Qwen3-8B 使用 SwiGLU MLP,激活为“gate”乘“up”,可为正或负,因此每个神经元有两个 pole。
- Gemma 4 12B 结构相同,但 gate 中使用 GELU 替代 SiLU,其神经元也有两个 pole。
- Gemma 4 的输入位置除文本 token 外,还可以包含图像 patch 或 40 ms 声音。
三、Lenses 与拟合方法
Lens 类型
| lens | 映射方式 | 读取方式 | 回答的问题 |
|---|---|---|---|
| logit | 不做映射 | W_U |
若下游不作用,h 会说什么 |
| J / R | J_L = mean_t Σ_{t≥t} ∂h_final(t)/∂h_L(t) |
W_U |
h 使模型之后说什么;J 用真实导数,R 用 RelP 导数 |
| K / S | K_L = mean_t Σ_{s≤t} ∂h_L(t)/∂e(s) |
W_E |
哪些输入 tokens 把 h 放到那里;K 用真实导数,S 用 RelP 导数 |
拟合细节
- 每个模型的两种 lens 拟合在相同的 1,000 篇 DCLM 文档上,每篇 128 tokens。
- 在单张 H100 上,每篇文档每个 lens 约 11–16 秒。
- Gemma 4 的 lens 还拟合于图像 COCO 和声音 ESC-50。
- 拟合不需要训练目标,每个 lens 是精确线性化的平均值。
- R-lens 读取是 scale-free 的;目录中的 S-lens 读取使用单位方向,因此读取描述方向,而非效应大小。
四、Catalog 覆盖内容
每个神经元和头从三个侧面读取:
- 从权重:通过两个 lenses 读取神经元写什么、其读取方向响应什么;头复制什么(OV)、注意什么(QK),逐 token。
- 从激活:覆盖网络、中文、Python、聊天文本的 15M positions,记录点火强度、频率和 top contexts。
- 从精确 token drivers:在 8 篇真实文档的一个位置上替换每个常见 token,测量哪些 token 直接使单元点火。
Gemma 4 额外内容:
- 每个神经元通过图像和声音读取。
- 使用 49,694 张带标签图像和 46,932 个带标签声音,记录哪些图像或声音使其点火。
- 记录其读取方向作为像素 patch 或 40 ms 声音的样子。
- 记录为驱动该神经元优化的模式。
表结构:
- 神经元和头有五个表,每行对应一个 pole 或一个头:
reads:仅权重的 lens 读取。acts:激活统计与 top firings。drivers:精确 token drivers。legible:哪些读取在单元自身 top firings 上成立。labels:Claude Haiku 的词语标签。
- Gemma 4 为每个神经元增加
image和audio表,并增加图像、音频上下文中头的media表。 - dataset card 记录每一列:https://huggingface.co/datasets/stdlogits/neuron-lens
读取可信范围
- 无单一读取在所有深度都有效。
- 早层最好从输入侧读取,晚层最好从 write 侧读取,中间层两侧都困难。
- Qwen3-8B 的深度图:
- L0–L7:pole 的驱动最好用其读取方向的 S-lens 读取;其 write 用 S-lens 读取,约 L4 起用 R-lens。
- L8:两个 lens 最一致。
- L9–L12:输入侧用读取方向的 R-lens 读取与精确 drivers;write 用 R-lens,反映 steering 效果,较少反映 firing 后续。
- L13–L20:输入侧主要靠精确 drivers 与激活;write 用 R-lens,用于 steering。
- L21–L35:输入侧用读取方向的 R-lens 与精确 drivers;write 用 R-lens,约 L23 起为下一 token,L32 起为抑制。
- Gemma 4 的映射形状相同,输入侧有效到约 L13,write 侧从约 L33 开始有效。
代表性示例
Qwen3-8B 神经元示例:
| pole | fires on | exact drivers | R-lens 读取输入 | R-lens 读取 write |
|---|---|---|---|---|
L1 n11672 − |
德⟦國⟧ | 德国、german、Germany | noise;S-lens 读为 German、Germany、德国 | German、Germany、hub tokens |
L8 n344 + |
the sound of the⟦ ow⟧ls | owl、Owl、OWL、Athena | owl、星空、Owl | owl、noct、bedtime、night |
L8 n1931 + |
non-B⟦ib⟧lical、Gods⟦ Word⟧ | biblical、圣经、Scripture | 圣经、基督教、信仰 | 圣经、基督徒、Bible、Scripture |
L28 n8868 − |
quite⟦ arist⟧ocratic、a⟦ plut⟧ocracy | arist、bureauc、democr、anarch | democracy、民主 | democracy、民主、democratic |
L30 n1034 + |
is⟦ once⟧ again | Once、once | again、再次 | again、再次、Again |
L35 n9510 + |
jsessionid=⟦0⟧000 等哈希与 ID | unrelated words | punctuation | none;设置输出温度 |
头示例:
| head | 权重读取结果 |
|---|---|
L20h17 |
复制 she、herself、她,抑制 he、himself;读取 himself 时反向 |
L26h31 |
复制数量:weight、体重、strength、temperature |
L34h1、L32h9 |
L34h1 复制姓氏;L32h9 为复制抑制头,抑制相同姓氏 |
L1h28 |
重复 token 头:Paris → Paris,几乎不复制其他内容 |
L0h27 |
注意代码与文档开头,如 /*、import |
五、主要发现
1. Lenses 稳定,语料改变 token 而非概念
- 在两个语料半集上拟合 lens,矩阵每层最大差异不超过 6%。
- R-lens 半集对神经元 write 的读取,其 top token 在 89–99% 的神经元上一致。
- 在聊天语料上拟合的 R-lens 与网页文本 lens,在 L16 前只有 31–51% 神经元共享 top token,但读取概念相同、顺序不同,所有因果测试表现相同,包括聊天格式测试。
2. 激活:神经元在何处点火
- 覆盖 15M positions。
- 典型激活从 L5 到 L21 平坦在 3–5,到 L35 增长十倍。
- L1 有 56% poles 接近沉默;L2–L3 大多数 pole 只在第一个位置工作。
- 中文选择性 pole 位于网络两端;代码选择性 pole 位于 L20–L29;聊天切片选择性 pole 对 ChatGPT 语体点火,如 “ delve”、“As of 2021”。
3. 仅从权重读取 neuron write,可预测 steering 效果
- 在 16 篇网页文档约 48 个位置加入 pole 的 write,以其典型激活强度,测量 next-token log-probability 变化,并与 lens 对同一向量的读取相关。
- R-lens 中位 r:L4–L8 为 0.46–0.51;L12–L16 为 0.64–0.74;L22 后不低于 0.9。
- 另一个神经元的读取对照为 ±0.04。
- R-lens 在 L4–L23 领先 J-lens 0.03–0.12;logit lens 到约 L20 前落后,L8 为 0.51 对 0.12。
- 从 L5 起,92–100% 随机 pole 的 write 可预测自身 steering 效果;错误配对为 0–5%。
4. Steering 不等同于神经元点火时实际行为
- 真实文本中,点火 pole 的 write 很少预测下一个 token。
- L22 前,净去偶然机会后,只有 1–4% poles 促进其 top firings 后出现的 tokens;L28–L29 为 31–32%。
- 对 2,290 个 pole 在真实点火处做精确线性化:点火效应接近线性,但 L21 前依赖上下文。同一 pole 同样强度点火,在不同文档中推向不同预测;一个 firing 对其他 firings 的 r 为 0.05–0.11;从 L28 起为 0.78。
- lens 与 steering 一致是因为二者对上下文平均;中层神经元在单一上下文中的行为大多是该上下文特有的,单一向量无法承载。
5. 预测与抑制是同一神经元的两个符号
- 晚层 pole 在它促进的词之前的 token 上点火,例如 “is⟦ once⟧” → again;“⟦arist⟧” → -ocracy。
- Prediction 从 L20 上升,在 L28–L31 峰值:7–8% poles 的 top firings 后超过三分之一是它们促进的 token;控制低于 0.1%。
- Suppression 从 L32 开始,在 L35 超过 prediction。
- SwiGLU 中两类功能位于同一神经元:promoting pole 到 L32 更强,suppressing pole 从 L34 更强。
6. 输入侧:早期 S-lens,后期 R-lens,中间精确 sweeps
- 早期神经元检测 token 与 token 家族,如“阔”“以出开头的词”、英文名。
- L2 时典型 write 的 95% 沿一个方向,并由 R-lens 向前携带。
- S-lens 可从权重恢复这些检测器:L0 时平均 40% pole top firings 的 token 在其 S-lens 读取 top 10 中,另一个 pole 的读取为 0.1%;L1–L8 为 2–9%;R-lens 读取低于 1.5%,L8 为 3.5%。
- 早期神经元也写回其检测 token 的 footprint:L0–L8 实际上像扩展 embedding。
- 从 L9 起,输入方向的 R-lens 读取更常命名精确 drivers;L13–L20 是所有仅权重输入读取最弱的区间。
- L0 之后,一个 token 的效应大多是非线性的:在 token 自身上下文中,精确线性化在 L0 解释 footprint 的 86%,在 L15 解释 7%。
7. 多数中层神经元对仅权重读取是暗的,但并非不可描述
- 每个 pole 的读取在自身 top firings 上对错误配对测试,FDR 为 5%。
- 38% poles 可被某测试读取;5% 沉默;57% 为 dark:会点火,但没有 token 级测试通过。
- Dark poles 占 L13–L20 的 82%。
- 带完整 evidence cards 的 explainers 描述 dark poles 几乎与 legible poles 一样好:detection AUROC 为 0.90 对 0.96。多数 dark poles 可能是概念检测器,其点火在 token 上变化。
8. 仅从 lenses 描述神经元
- Claude explainers 仅从 lens reads、top contexts 或二者标注 160 个随机 pole,从不看 steering。
- Firing labels 按 detection 评分:新模型能否根据标签从安静文本中挑出该 pole 的留出 top firings。
- Write labels 按判断者能否从 steering 生成的文本中,从四个选项中挑出该 pole 的标签。
- 仅从 lenses:firing labels 得分 0.80;write labels 被选中 65%。L28–L35 为 95%,L0–L8 为 34%;随机为 25%。
- Top contexts 对 firing 更好,为 0.87;lenses 对 writes 更好;二者结合达到 0.89 与 63%。
- Claude Opus 不比 Sonnet 更好,表明瓶颈在证据。
- Claude Haiku 以 105 美元标注全部 884,736 个 poles;在另外 100 个随机 poles 上,使用保留每层有效读取加 top contexts 的卡片,匹配 Sonnet:0.82 对 0.83。
9. Attention sinks 与输出温度
- 最终 RMSNorm 将每个位置向量除以其总体大小,再按学习权重逐维缩放。
- 两个维度的权重约为 1e-4,写入那里不会直接移动预测;但它们占最终残差平方长度的 64%,因此设定除数,并决定所有预测的锐度。
- 三个 L6 神经元在第一个 token 上点火最高达 10,752,写入这两个维度之一,创建后续头默认注意的 attention sink;触发因素是第 0 层 MLP 在该位置的输出。
- L16 神经元在日期后的年份创建第二个 sink,如 “May 7, ⟦2⟧013”;四个 L34 神经元在输出前清除它。
L35 n9510 +在哈希与 ID 上点火,此时下一 token 难以猜测,并通过该 scale 提高输出熵:即 Stolfo 等(2024)意义上的 entropy neuron。
10. 外部标签
- Neuron Persona Library 通过 steering 每个 pole,同时让模型回答 “Who are you?” 来标注 poles。
- 在 360 行上宽松且盲评:34% 的 personas 明确匹配 pole 的 write read,27% 匹配 input read,40% 同时匹配二者;置换名称后为 2–5%。
- 匹配最多出现在晚层,最少出现在中层。
- 按该库的深度混合加权。
六、结果索引说明
- 发现 1–12 属于 Qwen3-8B,发现 13–16 属于 Gemma 4 12B。
- 提供的 README 内容列出至发现 10;发现 13 在深度图部分提及 Gemma 4 12B 的文本目录映射。
- 完整结果见:https://github.com/stdlogits/neuron-lens/blob/HEAD/docs/findings.md
- 方法见:https://github.com/stdlogits/neuron-lens/blob/HEAD/docs/design.md
搜集汇总
数据集介绍
构建方式
面向大语言模型机制可解释性中对内部单元进行系统编目的需求,neuron-lens 以 Qwen3-8B 与 Gemma 4 12B 为对象,逐层读取全部 MLP 神经元和注意力头。其构建依托权重透镜与行为测量:在 DCLM 的 1,000 篇文档(每篇 128 token)上拟合基于 RelP 规则的 R-lens 与 S-lens,Gemma 4 另在 COCO 图像与 ESC-50 声音上拟合;在 1,500 万 token 的网页、中文、Python 与聊天文本上统计激活,并通过 8 篇真实文档的逐 token 替换识别精确驱动。最终形成公共目录、透镜矩阵及可读性检验。每个神经元正负极分别建档,Qwen3-8B 含 884,736 个神经元条目和 1,152 个头,Gemma 4 含 1,474,560 个神经元条目和 768 个头。
特点
在 Transformer 可解释性从单点探针扩展至全模型图谱的背景下,neuron-lens 的特点体现为全量覆盖与多视角互证。目录对每个神经元正负极及注意力头提供 reads、acts、drivers、legible 与 labels 五类表,Gemma 4 另设 image、audio 与 media 表。权重透镜既可读取单元的输入方向,也可读取其写入方向;激活统计刻画 firing 强度、频率与典型语境;精确 token 驱动则通过受控替换辨识直接触发因素。数据集区分原始读取与层对比读取,以缓解 hub token 干扰,并保留跨层可读性的经验图谱:浅层偏输入侧,深层偏写侧,中层多呈暗态。其标签、可读性检验与因果 steering 结果共同构成多维证据。
使用方法
对于从事机制可解释性、神经元标注与因果干预分析的研究者,neuron-lens 可通过 Hugging Face 的 stdlogits/neuron-lens 目录及 stdlogits/rs-lenses 透镜访问。使用时可按模型、层、单元或头检索相应表格,读取权重透镜给出的 token 排名、激活统计、精确驱动与词语标签。R-lens 用于从内部向量预测模型后续输出,S-lens 用于回溯形成该向量的输入 token;结合 findings 的深度地图可选择可信读取:浅层优先 S-lens,中层依赖精确驱动,深层优先 R-lens 写入读数。Gemma 4 使用者还可调用图像、声音与媒体表开展多模态单元分析,并以 legible 与 steering 结果进行验证。
背景与挑战
背景概述
在大语言模型机制可解释性由局部电路探针迈向全模型单元级目录的学术脉络中,neuron-lens 构建了一个面向 Qwen3-8B 与 Gemma 4 12B 的神经元与注意力头读取资源。公开资料未明确标注创建日期,依据其引用的2026年文献与发布语境,可推断为2026年前后公开;主要作者为 @_a9lim 与 @treetowntree,并借助 Claude 协作,托管于 Hugging Face 的 stdlogits 组织。其核心问题是:大语言模型每个 MLP 神经元与注意力头究竟承担何种功能,能否仅凭权重、真实文本激活与精确 token 驱动加以刻画。该工作整合 R-lens、S-lens 等雅可比透镜,输出可公开检索的目录与可靠性测量,对机制可解释性、神经元语义学及多模态模型内部剖析具有参考价值。
当前挑战
在大语言模型单元级解释面临多义性、上下文依赖与读出可靠性验证困难的前提下,neuron-lens 的挑战可归为领域与构建双重维度。领域层面,单个神经元或注意力头常呈多义性,同一单元在真实文本中的触发效应随上下文漂移,因果 steering 与自然激活并不等价;权重透镜读法具深度依赖性,早期宜读输入端、晚期宜读输出端,中层层段尤易出现暗单元与 hub token 干扰。构建层面,需覆盖 Qwen3-8B 的442,368个神经元与1,152个头、Gemma 4 12B的737,280个神经元与768个头,拟合多套雅可比透镜、处理15M位置激活、图像与声音模态、精确 token 驱动及大规模标签生成,计算与验证成本高昂。
常用场景
经典使用场景
在大语言模型机制可解释性研究中,neuron-lens 的经典用途在于对 Transformer 的 MLP 神经元与注意力头进行系统化读取与编目。研究者可借助 R-lens、S-lens 等雅可比透镜,从权重层面推断神经元的输入响应与输出写入方向,并以 1500 万 token 的真实文本激活统计、精确 token driver 和跨模态图像声音探测,交叉验证每个单元的功能。该目录覆盖 Qwen3-8B 的 442,368 个神经元与 1,152 个头,以及 Gemma 4 12B 的 737,280 个神经元与 768 个头,为神经元语义标注、注意力头电路分析和跨层可读性评估提供标准化入口,进而支撑机制可解释性、模型审计与表征工程等研究。
实际应用
在模型开发与治理实践中,neuron-lens 可用于定位影响生成行为的关键神经元和注意力头,辅助调试幻觉、偏见、知识召回与格式控制等问题。安全审计人员能够借助神经元激活、token driver 与透镜读取,观察模型对敏感内容、指令格式和风险 token 的内部响应;工程师也可在可控生成、知识编辑和提示工程中,以神经元写入方向为依据设计干预。对于 Gemma 4 12B,目录还覆盖图像与声音模态,使多模态模型的单元功能分析、跨模态对齐检查和媒体内容治理获得可操作依据,并为教育演示与可解释性基准建设提供公共资源。
衍生相关工作
围绕神经单元读取与透镜方法,neuron-lens 承继并拓展了 logit lens、J-lens、R-lens、K-lens 与 S-lens 等经典工作,其中 S-lens 在该数据集中被明确提出并与 R-lens 共享 RelP 传播规则。其目录与 Neuron Persona Library、Gurnee 等人关于预测与抑制神经元的研究、Stolfo 等人关于熵神经元与注意力汇的观察相互呼应,也推动 Claude 等模型参与自动化神经元标注与盲测评估。这些工作共同构成从权重线性化、激活普查到自然语言标签的链条,为后续神经元电路发现、跨模型比较和多模态可解释性研究提供了可复用的方法范式与基准。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


