遇见数据集

airbnb_listings_lite_processed

收藏
Hugging Face2026-08-02 更新2026-08-03 收录
官方服务:

资源简介:

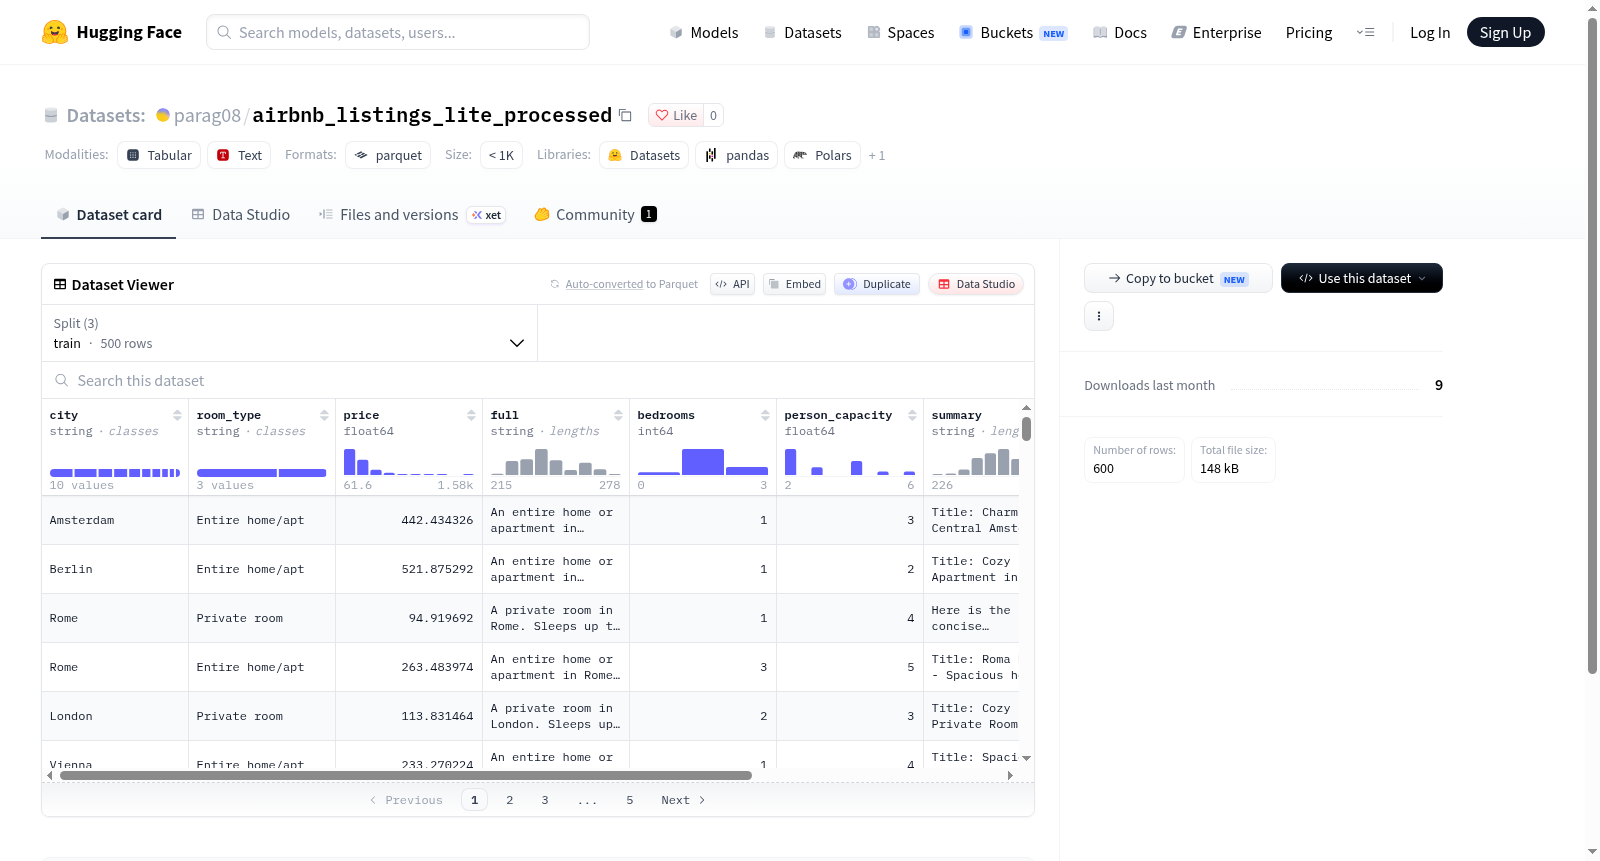
该数据集包含Airbnb房源的详细信息,共有600个样本,分为训练集(500条)、验证集(50条)和测试集(50条)。每个样本包含城市(city)、房间类型(room_type)、价格(price)、完整描述(full)、卧室数量(bedrooms)、可住人数(person_capacity)、摘要(summary)、提示(prompt)以及唯一标识符(id)。数据集可用于基于文本的房源描述生成、价格预测或推荐系统等任务,特征组合支持多模态输入输出。

This dataset contains detailed information about Airbnb listings, with a total of 600 samples divided into training set (500), validation set (50), and test set (50). Each sample includes city, room_type, price, full description, number of bedrooms, person_capacity, summary, prompt, and a unique identifier (id). The dataset can be used for tasks such as text-based listing description generation, price prediction, or recommendation systems, and the feature combination supports multimodal input and output.

创建时间:
2026-08-01
原始信息汇总

数据集概述:airbnb_listings_lite_processed

基本信息

  • 数据集地址:https://huggingface.co/datasets/parag08/airbnb_listings_lite_processed
  • 数据集大小:612,450 字节(约 598 KB)
  • 下载大小:144,448 字节(约 141 KB)

数据划分

数据划分 样本数量 数据大小
train(训练集) 500 510,066 字节
validation(验证集) 50 51,137 字节
test(测试集) 50 51,247 字节

总计样本数:600 条

数据特征(Features)

该数据集包含以下 9 个字段:

字段名 数据类型 说明
city 字符串 城市
room_type 字符串 房间类型
price 浮点数 价格
full 字符串 完整信息
bedrooms 整数 卧室数量
person_capacity 浮点数 可容纳人数
summary 字符串 摘要描述
prompt 字符串 提示词
id 整数 唯一标识符

数据配置

  • 配置名称:default(默认配置)
  • 数据文件路径
    • 训练集:data/train-*
    • 验证集:data/validation-*
    • 测试集:data/test-*
搜集汇总
数据集介绍
airbnb_listings_lite_processed 数据集图片
构建方式
在共享经济与短租市场研究领域,房源数据的结构化整理是支撑价格预测与推荐系统开发的基础。该数据集通过对Airbnb房源原始信息进行筛选与字段抽取,构建了轻量化的处理版本。数据实例来源于平台公开的房源列表,经清洗后保留城市、房型、价格、卧室数量、容纳人数、房源摘要等核心字段,并额外生成完整文本描述与提示语字段。数据集划分为训练集500例、验证集50例与测试集50例,各字段均以标准化格式存储,便于后续建模与评估。
特点
相较于原始房源数据,该数据集以精简结构呈现多维信息,兼顾数值型与文本型特征。价格与容纳人数采用浮点型,卧室数量为整型,城市、房型及摘要等为字符串,形成异构特征空间。其显著特点在于引入full与prompt字段,将房源属性与自然语言提示相结合,为文本生成与条件建模提供便利。数据规模适中,划分明确,适用于快速实验与基准测试,同时避免冗余信息对模型训练的干扰。
使用方法
使用该数据集时,可借助HuggingFace datasets库直接加载默认配置,按split获取训练、验证与测试子集。针对价格预测任务,可将city、room_type、bedrooms、person_capacity等作为输入特征,price作为回归目标;针对文本生成任务,可利用prompt与full字段构建条件生成或摘要复述模型。数值字段需根据模型需求进行归一化或分桶处理,类别字段可进行独热编码或嵌入表示。加载后建议检查字段分布与缺失情况,以确保实验可复现。
背景与挑战
背景概述
随着共享经济在全球范围内的迅速崛起,Airbnb作为短租平台的代表,积累了海量且多维的房源信息,涵盖地理位置、房型、价格、容量及文本描述等。airbnb_listings_lite_processed数据集在此背景下应运而生,其构建可追溯至对短租市场数据驱动研究的迫切需求,由关注住宿价格预测与文本生成的研究者整理发布。该数据集聚焦于房源价格与多模态属性之间的关联建模,并引入prompt字段以支持基于大语言模型的受控文本生成任务。其核心研究问题在于如何利用结构化特征与文本摘要实现精准预测与内容合成,对推荐系统、定价策略及自然语言处理交叉领域具有显著的推动价值。
当前挑战
该数据集所应对的领域问题兼具回归与生成双重属性,其难点在于价格预测需融合城市、房型、卧室数等异构特征,而文本生成则要求模型从摘要和prompt中捕捉房源语义并保持事实一致性。构建过程中的挑战同样突出:原始Airbnb数据存在缺失值、异常价格与多语言混杂的摘要,清洗与标准化流程复杂;为控制规模而进行的筛选可能引入采样偏差,导致城市与房型分布不均衡;prompt字段的模板设计需兼顾多样性与无偏性,避免生成结果过拟合于特定表达。此外,训练集与验证集、测试集之间的小样本划分对模型泛化能力构成额外考验。
常用场景
经典使用场景
共享住宿平台的房源推荐与价格预测是短租市场研究的核心议题,airbnb_listings_lite_processed数据集凭借其结构化的字段设计,成为此类任务的经典基准。该数据集涵盖城市、房型、价格、卧室数量、可容纳人数、房源摘要以及预置提示词等多元信息,其中价格作为回归目标,摘要与提示词则为文本建模提供语义线索。研究者常以此数据构建多模态预测模型,融合结构化特征与文本描述,探索房源定价的关键影响因素,并评估模型在不同城市与房型间的泛化能力。
实际应用
在实际应用中,该数据集直接服务于民宿平台的动态定价与智能推荐系统。房东可借助基于此数据训练的模型,结合卧室数、可容纳人数及房源摘要,获得合理的价格建议,提升收益管理效率。平台方则能利用摘要与提示词字段,优化房源描述生成与搜索排序,改善用户体验。此外,城市与房型维度的信息支持区域市场分析,帮助运营团队识别供需热点,制定差异化的营销策略与库存规划。
衍生相关工作
围绕该数据集,衍生出多项经典工作。部分研究聚焦于文本增强的回归模型,利用摘要与提示词提升价格预测精度;另一些工作探索多任务学习,同时预测价格与房型分类,共享底层表示。还有学者基于此数据开展可解释性分析,量化各特征对定价的贡献度,并开发可视化工具。这些衍生物不仅拓展了短租市场的研究边界,也为后续引入图像、评论等多源数据奠定了方法基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务