
TheFinAI/llm-econ-memorization-paper
收藏官方服务:
资源简介:
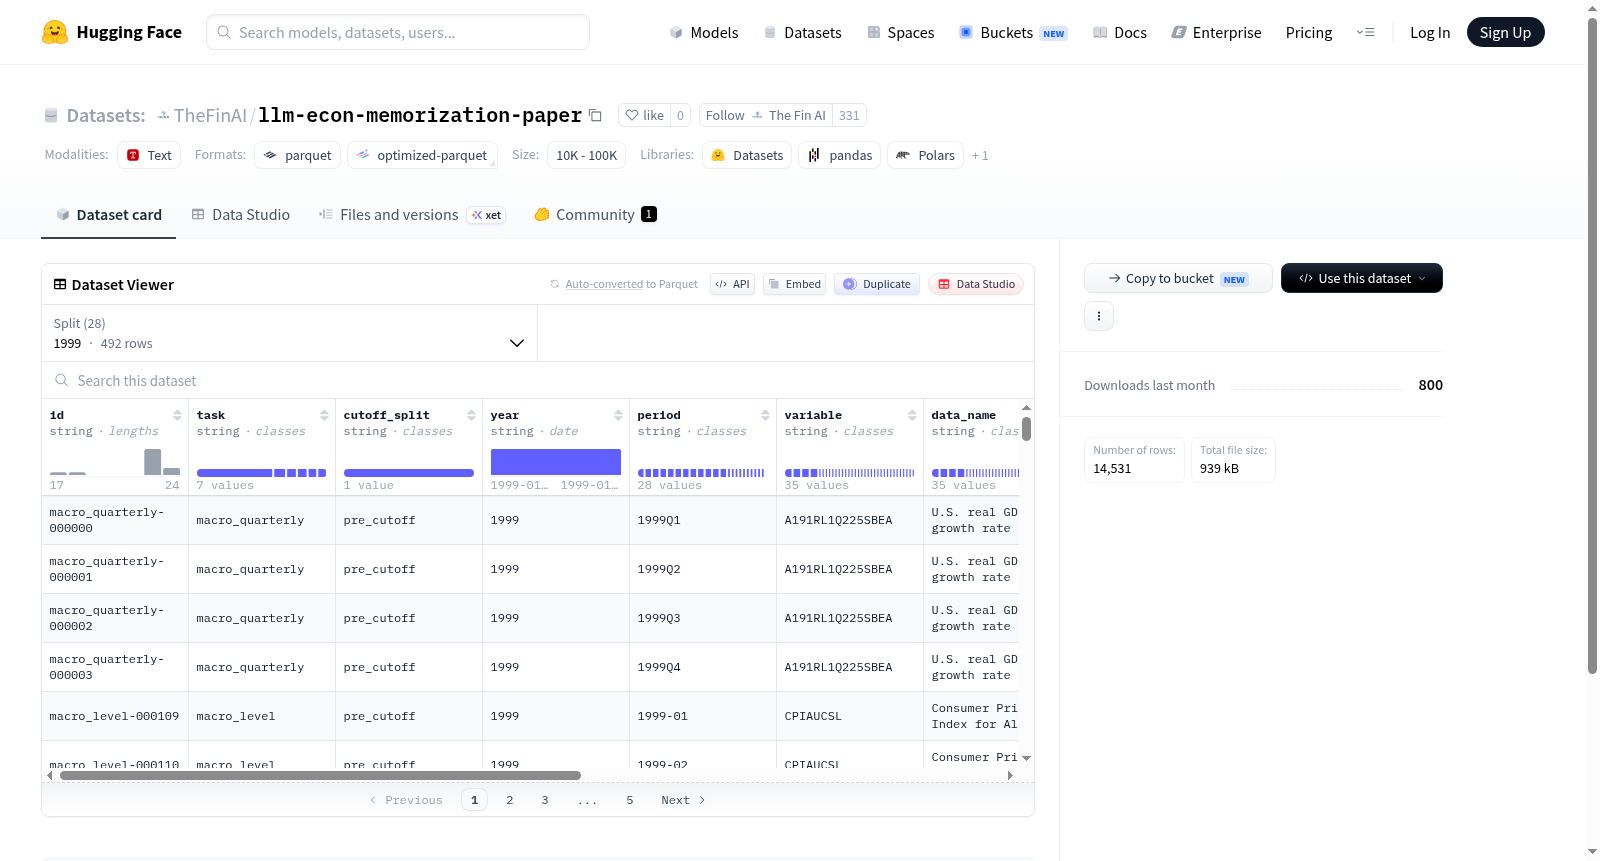
该数据集是一个按年份组织的数据集合,涵盖1999年至2026年的时间范围,包含多个任务和变量。数据特征包括id、任务类型、截止分割、年份、周期、变量、数据名称、系统、提示、答案、答案类型和元数据JSON。每个年份分片包含数百个示例,用于支持任务导向的问答或评估场景,可能用于自然语言处理或机器学习模型的训练和测试。
This dataset is a collection organized by year, covering the time range from 1999 to 2026, and includes multiple tasks and variables. The features consist of id, task, cutoff_split, year, period, variable, data_name, system, prompt, answer, answer_type, and meta_json. Each year split contains hundreds of examples, designed to support task-oriented question answering or evaluation scenarios, likely for natural language processing or machine learning model training and testing.
提供机构:
TheFinAI搜集汇总
数据集介绍
构建方式
该数据集围绕经济学领域的记忆化研究而构建,旨在系统性地评估大型语言模型对特定经济数据的记忆程度。数据集以年份为分割维度,从1999年至2026年,共涵盖27个时间切片,每个切片包含数百条不等的样本。每条样本均包含唯一标识符、任务类型、切割点、年份、时期、变量、数据名称、系统提示、用户提示、标准答案及答案类型等结构化字段,并辅以元数据JSON字段以存储更丰富的背景信息。这种按年度划分且高度结构化的设计,使得研究者能够精确追溯模型对不同时期经济知识的记忆差异。
特点
该数据集的核心特点在于其严格的时间序列划分与精细的元数据标注。数据按年份切分为独立子集,从1999年的492条到2026年的225条,样本数量随时间推移呈先增后减的分布,这可能反映了经济数据在历史上的可获得性与研究热度的变化。每个样本均包含prompt与answer对,且answer_type字段区分了答案的类型,为分析模型输出的多样性提供了依据。此外,meta_json字段的存在使得每条数据都能携带额外的上下文信息,极大增强了数据集的可扩展性与研究深度。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库直接加载,利用config_name='default'并按年份split参数选择所需的时间切片。例如,加载2000年的数据可指定split='2000'。每条样本中的system与prompt字段可作为输入,answer字段作为标准对照,用于测试模型的经济知识记忆水平。通过遍历不同年份的子集,研究者能够系统性地分析模型记忆能力随时间变化的规律,或聚焦于特定经济变量与时期进行深入分析。数据集的大小适中(约10MB),便于快速加载与实验迭代。
背景与挑战
背景概述
在大型语言模型(LLM)快速发展的时代,其在经济领域的应用引发了广泛关注,尤其是模型是否依赖对训练数据的记忆来回答经济事实类问题,这直接关涉到模型的泛化能力与可信度。llm-econ-memorization-paper数据集正是在此背景下创建,旨在系统评估和探测LLM对宏观经济时序数据的记忆程度。该数据集覆盖了从1999年至2026年的经济变量数据,包含任务类型、时间分割、提示语与标准答案等结构化信息,为跨年份的对照分析提供了基础。其核心研究问题聚焦于:LLM能否在不记忆的情况下准确回答经济指标,以及记忆程度如何随时间变化。该工作对理解LLM在下游经济任务中的行为模式具有重要启示,尤其在稳健性评估与工具使用场景中影响深远。
当前挑战
该数据集面临的核心挑战在于精准区分语言模型的常识推理能力与机械性记忆。经济数据具有严格的时序性和数值精确性,模型若通过记忆近期高频率出现的数值来生成回答,则难以评估其真实理解水平。此外,构建过程中需解决数据标准化问题,如统一不同年份经济变量的表达形式、消除噪声数据对提示设计的干扰。另一个关键挑战是设计有效的实验框架,以控制测试过程中的数据泄漏,避免模型在训练时已见过相同年份的同类指标。这些挑战不仅影响着数据集本身的可信度,也对经济领域中语言模型的公平评估和稳健部署提出了更高要求。
常用场景
经典使用场景
在经济学与人工智能交叉研究领域,llm-econ-memorization-paper数据集被广泛用于评估大语言模型对经济类时序知识的内化与再现能力。该数据集按年份划分了从1999年至2026年的经济变量记录,涵盖任务类型、变量名称、数据来源及系统指令等关键字段。研究者利用其构建的问答对结构,系统性地考察模型是否在预训练阶段记忆了特定年度经济指标,从而衡量模型在未显式学习时的知识回溯水平。这一应用场景为理解大语言模型的知识边界与记忆黑箱提供了强有力的实证工具。
解决学术问题
该数据集精准回应了学术界关于大语言模型知识注入与时间敏感性记忆的深层关切。传统上,经济学实证研究依赖结构化数据检验模型的预测准确性,却难以判断模型是否真正理解经济规律抑或仅凭记忆复述。llm-econ-memorization-paper通过引入严格的时序划分与零样本问答设计,使得研究者可以量化模型在不同年份经济变量上的记忆偏差,进而揭示预训练语料中经济知识的分布规律与遗忘曲线。这为解决模型可解释性、知识时效性评估以及数据污染检测等关键议题提供了可靠的数据基石,推动了AI经济学研究范式的演进。
衍生相关工作
围绕llm-econ-memorization-paper数据集,学术界涌现了一系列极具启发性的衍生工作。研究者基于其时序问答架构,开发了经济知识蒸馏框架,以量化模型对历史经济冲击的反应模式与记忆强度。另有工作将其与宏观经济预测模型相结合,提出“记忆校准”机制,通过对比模型输出与真实经济数据的时间序列,修正预训练知识中的结构性偏差。此外,该数据集还催生了跨语言经济记忆基准测试,将原本的英文经济变量推广至多语种场景,深入探究大语言模型在全球化经济知识中的泛化表现与记忆共性。这些衍生成果不断拓展着AI经济学领域的理论边疆。
以上内容由遇见数据集搜集并总结生成


