
遇见数据集

thetemirbolatov/Karachay-words

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

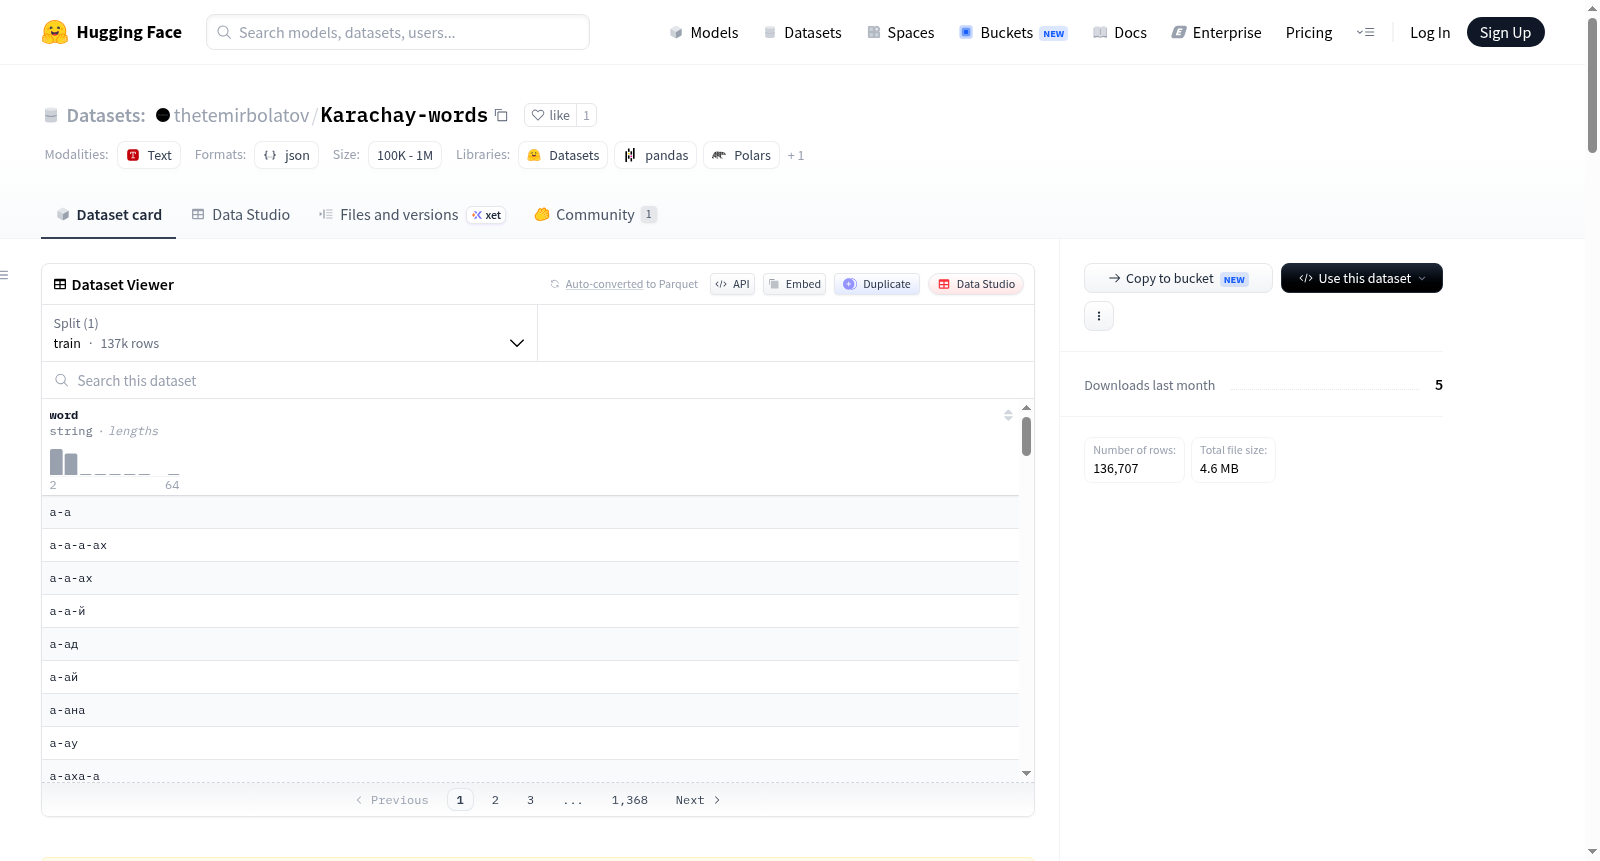
该数据集是一个卡拉恰伊语单词和短语的基本集合,专门用于训练和微调突厥语系的语言模型,特别是卡拉恰伊-巴尔卡尔语(ISO 639-3语言代码:krc)。它旨在弥补低资源语言数据的严重短缺,适用于从头开始训练、微调现有模型或扩展分词器。数据集格式为JSON Lines(.jsonl),每条记录是一个有效的JSON对象,包含一个word字段,存储卡拉恰伊语单词或短短语。内容涵盖卡拉恰伊-巴尔卡尔语的本土词汇、俄语借词(适应拼写)以及固定表达和习语。数据集包含136,706行(单词),文件大小约4.6 MB。

This repository contains a basic set of Karachay words and phrases, designed for training and fine-tuning language models of the Turkic group, specifically the Karachay-Balkar language (ISO 639-3 code: krc). The dataset is created to address the acute shortage of low-resource language data and is suitable for training from scratch, fine-tuning existing models, or expanding tokenizers. The format is JSON Lines (.jsonl), with each line being a valid JSON object containing a word field for Karachay words or short phrases. The content includes native Karachay-Balkar vocabulary, modern borrowings from Russian adapted in spelling, and stable expressions or idioms. The dataset consists of 136,706 lines (words), with a file size of approximately 4.6 MB.
提供机构:
thetemirbolatov
搜集汇总
数据集介绍
thetemirbolatov/Karachay-words 数据集图片
构建方式
Karachay-words数据集采用JSON Lines格式构建,每一行均为包含'word'字段的独立JSON对象,存储单一的卡拉恰伊词汇或短句。数据集共计136,706条词条,涵盖了原生卡拉恰伊-巴尔卡尔词汇、源自俄语并在正字法层面适配的现代借词(如автомобиль),以及稳定的短语和成语(如Ингир ашхы болсун)。这种以词汇表为核心的构建方式,旨在直接缓解突厥语系尤其是卡拉恰伊-巴尔卡尔语在自然语言处理领域数据匮乏的困境。
特点
该数据集的主要特点在于其作为低资源语言词汇库的专门性与实用性。它收录了超过13万条词条,显著高于同类基础词汇集,为语言模型训练提供了宝贵的源数据。数据包含了本土词汇与外来借词的混合,既适合用于捕捉语言的实际使用面貌,也支持代码切换(code-switching)场景。此外,数据集中缺乏词性标注或形态学分解,保持纯文本形态,从而在使用上赋予研究者更大的灵活性,尤其适宜于语言建模、掩码语言建模以及词元分析器的扩展优化。
使用方法
该数据集可通过Hugging Face Datasets库直接加载,使用load_dataset(\"thetemirbolatov/Karachay-words\", split= \"train\")即可获取训练分片。每条记录提供词条文本,便于构建因果语言模型(如GPT)或掩码语言模型(如BERT)的训练语料。开发者亦可利用生成器函数迭代数据以完成自定义分词器的再训练,从而将特异的卡拉恰伊词元高效整合进现有多语言架构(如LLaMA、XLM-RoBERTa)。此外,数据文件(karachay_words.jsonl)支持以标准Python JSON解析直接读取,方便集成至无依赖环境下的本地或离线工作流。
背景与挑战
背景概述
Karachay-words数据集由研究人员thetemirbolatov于近年创建,旨在缓解卡拉恰伊-巴尔卡尔语(ISO 639-3: krc)这一低资源语言在自然语言处理领域的数据匮乏问题。作为突厥语系的重要分支,该语言面临着数字化资源稀缺的严峻挑战,严重制约了语言建模、掩码语言建模及分词器扩展等现代NLP技术的应用。该数据集收录了超过13万条词汇与短语,涵盖本土词汇、俄语借词及习语表达,为开发面向低资源语言的语言模型、拼写检查系统及跨语言基准测试提供了基础资源。其发布依托Apache 2.0开源许可,推动了数字语言复兴与人工智能在少数民族语言保护中的融合。
当前挑战
该数据集所解决的领域挑战在于低资源语言NLP的共性难题:卡拉恰伊-巴尔卡尔语缺乏大规模标注语料与平衡语料库,导致现有模型难以有效建模其形态复杂性与词汇多样性。构建过程中的挑战包括:数据来源主要依赖词典与人工整理,难以保证覆盖日常口语与语法的完整性;大量俄语借词与现代借词的混入,可能干扰纯文学语言的训练目标;同时,缺少词性标注与形态分析等元信息,限制了其在细粒度NLP任务中的应用。此外,数据集中词汇的语义歧义与多义现象未作消歧,增加了模型过拟合与泛化能力下降的风险。
常用场景
经典使用场景
Karachay-words数据集是一座为低资源语言自然语言处理领域精心构筑的词汇宝库。其核心用途聚焦于语言模型的预训练与微调,尤其适用于因果语言建模与掩码语言建模任务。研究者可借助该数据集,从零开始训练类似GPT的自回归模型,或对BERT类编码器架构进行深度适配,赋能卡拉恰伊-巴尔卡尔这一突厥语系语言的语义理解与生成能力。此外,该数据集还常被用于扩展现有分词器的词汇表,通过注入特有词元来降低词汇碎片化率并提升推理速度,为低资源语言模型在算力受限环境下的部署提供坚实的数据基石。
解决学术问题
在学术探索中,Karachay-words数据集直面低资源语言长期面临的“数据荒漠”困境,系统性地缓解了卡拉恰伊-巴尔卡尔语在自然语言处理研究中缺乏高质量、标准化词汇资源的痛点。数据集的构建使得研究者能够开展语言建模、文本纠错、词嵌入质量评测等基础性实验,填补了突厥语族计算语言学的一项显著空白。其意义不仅在于提供了一个可复用的数据基础设施,更在于激发了关于跨语言迁移学习、代码混合文本处理以及低资源语言数字化保护的深层讨论,推动了计算语言学界对语言多样性的关注与包容性技术的演进。
衍生相关工作
基于Karachay-words数据集,学术界衍生出一系列富有启发性的经典工作。例如,有研究团队以此为基础训练了专用的卡拉恰伊-巴尔卡尔语BERT模型,并通过在下游文本分类与命名实体识别任务上的微调,验证了数据驱动方法在低资源场景下的有效性。另有学者利用该数据集与混合专家模型结合,探索如何高效整合俄语借词与本土词汇,实现了代码混合文本的流畅生成。在分词器优化方向,该数据集被用于扩展现有多语言模型的词表,显著降低了段落级文本的词元化长度,为大规模低资源模型压缩提供了基准实验平台。这些工作不仅深化了对突厥语系计算特性的理解,也为其他濒危语言的数字化保护树立了可参照的范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

