TAESOO98/meld-transcript-final_temp
收藏资源简介:
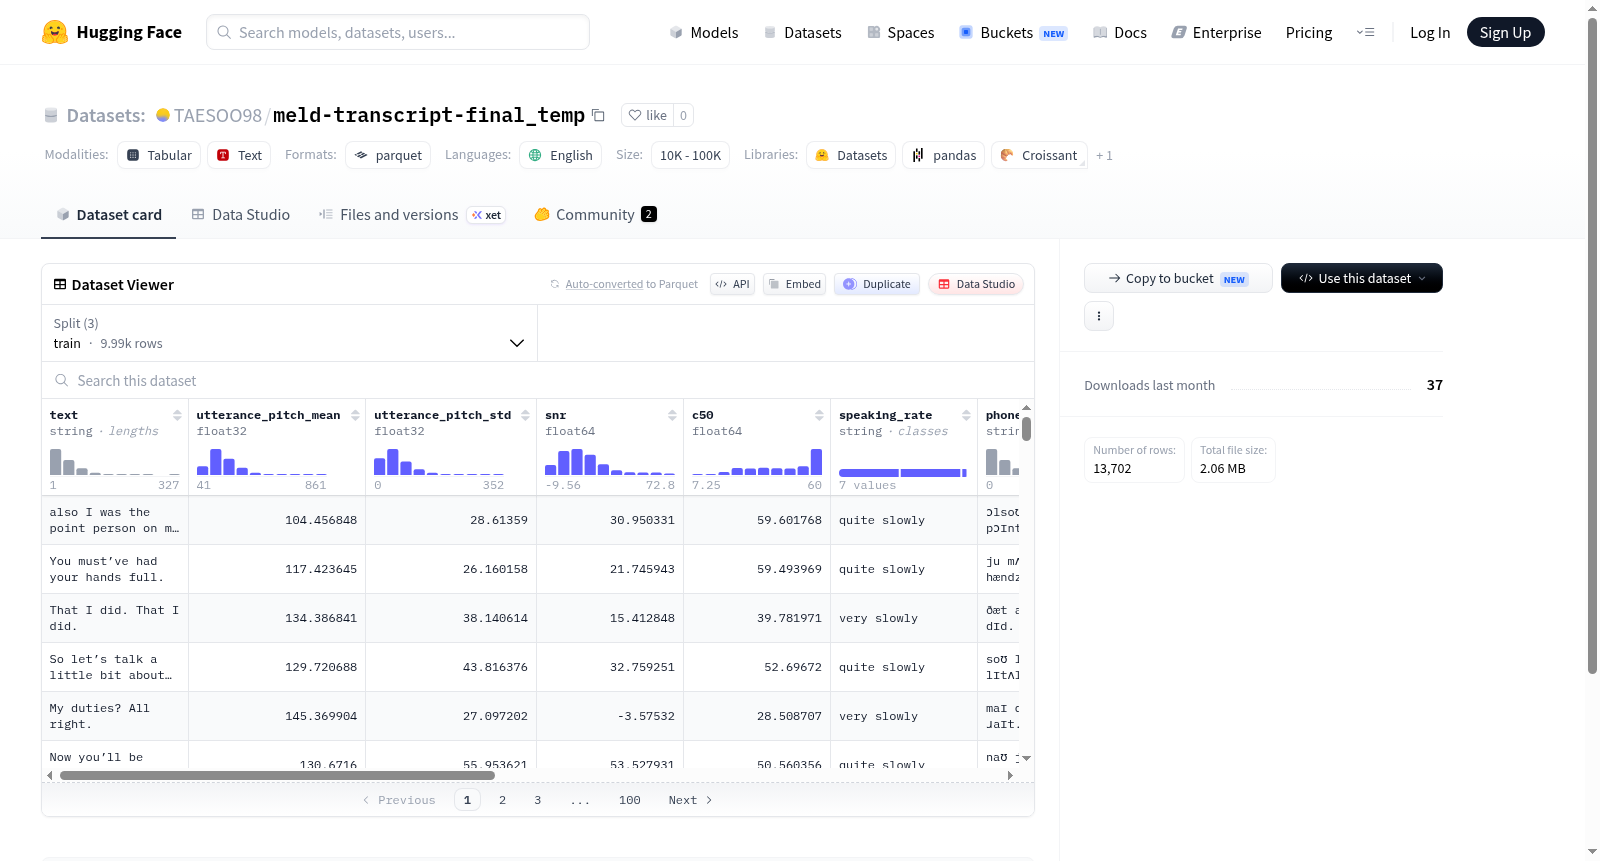
--- language: - en dataset_info: features: - name: text dtype: string - name: utterance_pitch_mean dtype: float32 - name: utterance_pitch_std dtype: float32 - name: snr dtype: float64 - name: c50 dtype: float64 - name: speaking_rate dtype: string - name: phonemes dtype: string - name: speaker_id dtype: string - name: gender dtype: string - name: pitch dtype: string - name: noise dtype: string - name: reverberation dtype: string - name: speech_monotony dtype: string - name: text_description dtype: string splits: - name: train num_bytes: 4637991 num_examples: 9985 - name: test num_bytes: 1215673 num_examples: 2609 - name: valid num_bytes: 516323 num_examples: 1108 download_size: 2055646 dataset_size: 6369987 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* - split: valid path: data/valid-* ---
语言: - 英语 数据集信息: 特征: - 名称:文本(text),数据类型:字符串(string) - 名称:语句基频均值(utterance_pitch_mean),数据类型:单精度浮点数(float32) - 名称:语句基频标准差(utterance_pitch_std),数据类型:单精度浮点数(float32) - 名称:信噪比(SNR),数据类型:双精度浮点数(float64) - 名称:C50指数(c50),数据类型:双精度浮点数(float64) - 名称:语速(speaking_rate),数据类型:字符串(string) - 名称:音素(phonemes),数据类型:字符串(string) - 名称:说话人ID(speaker_id),数据类型:字符串(string) - 名称:性别(gender),数据类型:字符串(string) - 名称:基频序列(pitch),数据类型:字符串(string) - 名称:噪声(noise),数据类型:字符串(string) - 名称:混响(reverberation),数据类型:字符串(string) - 名称:语音单调度(speech_monotony),数据类型:字符串(string) - 名称:文本描述(text_description),数据类型:字符串(string) 划分集: - 名称:训练集(train),字节数:4637991,样本数:9985 - 名称:测试集(test),字节数:1215673,样本数:2609 - 名称:验证集(valid),字节数:516323,样本数:1108 下载大小:2055646,总数据集大小:6369987 配置: - 配置名称:默认(default),数据文件: - 划分集:训练集,路径:data/train-* - 划分集:测试集,路径:data/test-* - 划分集:验证集,路径:data/valid-*
数据集概述
数据集特征
- text:文本,数据类型为字符串。
- utterance_pitch_mean:话语音高平均值,数据类型为浮点数32位。
- utterance_pitch_std:话语音高标准差,数据类型为浮点数32位。
- snr:信噪比,数据类型为浮点数64位。
- c50:混响测量指标,数据类型为浮点数64位。
- speaking_rate:说话速率,数据类型为字符串。
- phonemes:音素,数据类型为字符串。
- speaker_id:说话者ID,数据类型为字符串。
- gender:性别,数据类型为字符串。
- pitch:音高,数据类型为字符串。
- noise:噪音,数据类型为字符串。
- reverberation:混响,数据类型为字符串。
- speech_monotony:语音单调性,数据类型为字符串。
- text_description:文本描述,数据类型为字符串。
数据集分割
- train:训练集,包含9985个样本,总大小为4637991字节。
- test:测试集,包含2609个样本,总大小为1215673字节。
- valid:验证集,包含1108个样本,总大小为516323字节。
数据集大小
- 下载大小:2055646字节。
- 数据集总大小:6369987字节。