遇见数据集

nahyeon00/mixsnips_clean

收藏
Hugging Face2023-07-19 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: token sequence: string - name: tag sequence: string - name: intent sequence: string splits: - name: train num_bytes: 16319528 num_examples: 39776 - name: validation num_bytes: 915087 num_examples: 2198 - name: test num_bytes: 902367 num_examples: 2199 download_size: 3076227 dataset_size: 18136982 --- # Dataset Card for "mixsnips_clean" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

--- 数据集信息: 特征字段: - 名称为Token(token),类型为字符串序列 - 名称为标签(tag),类型为字符串序列 - 名称为意图(intent),类型为字符串序列 数据划分: - 名称为训练集,字节数:16319528,样本数:39776 - 名称为验证集,字节数:915087,样本数:2198 - 名称为测试集,字节数:902367,样本数:2199 下载大小:3076227 数据集总大小:18136982 --- # "mixsnips_clean"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
nahyeon00
原始信息汇总

数据集概述

数据集名称

  • 名称: mixsnips_clean

数据集特征

  • 特征1: token
    • 类型: 字符串序列
  • 特征2: tag
    • 类型: 字符串序列
  • 特征3: intent
    • 类型: 字符串序列

数据集分割

  • 训练集
    • 字节数: 16319528
    • 示例数: 39776
  • 验证集
    • 字节数: 915087
    • 示例数: 2198
  • 测试集
    • 字节数: 902367
    • 示例数: 2199

数据集大小

  • 下载大小: 3076227字节
  • 数据集总大小: 18136982字节
搜集汇总
数据集介绍
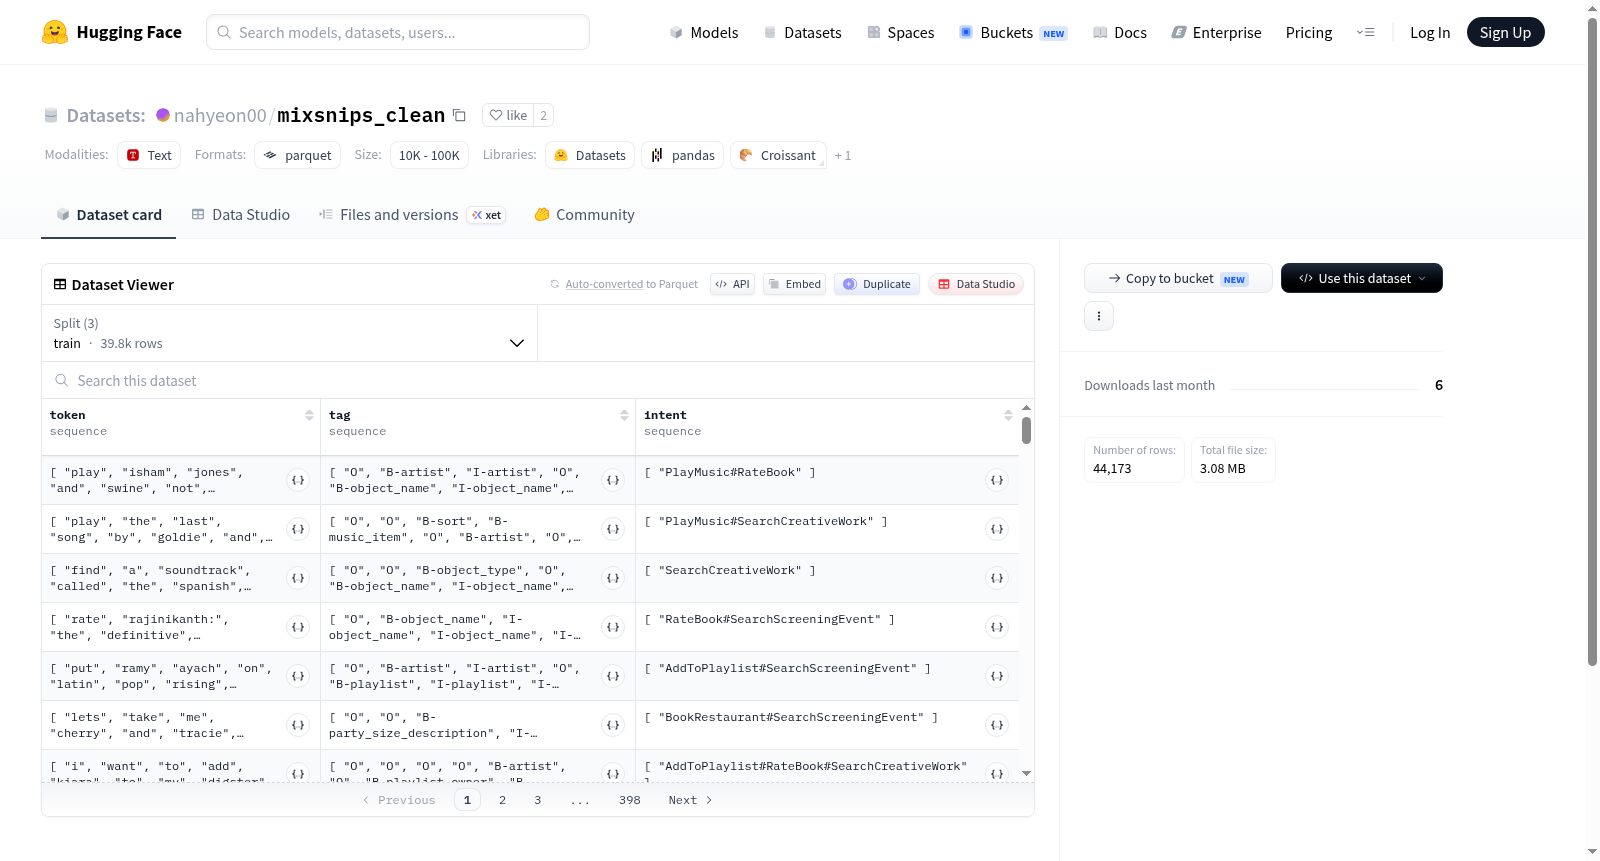
nahyeon00/mixsnips_clean 数据集图片
构建方式
在自然语言理解领域,高质量的数据集是驱动模型性能提升的关键。nahyeon00/mixsnips_clean 数据集基于经典的 SNIPS 语料库进行精心清洗与整合,旨在为意图识别和槽位填充任务提供更为纯净的基准。该数据集以序列化结构组织,每条样本包含 token、tag 和 intent 三个字段,分别对应输入词元、词元级别的语义标签以及整体意图类别。数据被划分为训练、验证和测试三个子集,其中训练集包含 39,776 条样本,验证集与测试集分别包含 2,198 和 2,199 条样本,确保了模型评估的充分性与可靠性。
特点
该数据集的核心特点在于其简洁而明确的标注体系与均衡的样本分布。所有数据均以序列形式存储,token 字段保留了原始文本的词汇顺序,tag 字段则采用 BIO 标注模式对实体和语义角色进行细粒度标记,intent 字段则提供了高层次的对话目标分类。这种多维度的标注结构使得数据集既能支持端到端的联合建模,也适用于独立的意图分类或序列标注任务。此外,经过清洗后的数据在噪声控制上表现优异,为研究者在少样本学习、跨领域迁移等前沿课题上提供了可靠的实验基础。
使用方法
在使用 nahyeon00/mixsnips_clean 数据集时,研究者可通过 Hugging Face Datasets 库直接加载,无需额外手动下载。加载后,可将 token 序列作为模型输入,结合 tag 和 intent 标签构建监督学习目标。对于基于 Transformer 的预训练模型,建议将 token 字段进行子词分词后与标签对齐,并采用动态填充策略以适配批处理。在评估阶段,可分别计算意图分类的准确率与槽位填充的 F1 分数,以全面衡量模型在自然语言理解任务上的综合性能。
背景与挑战
背景概述
在自然语言理解领域,意图识别与槽位填充作为对话系统的核心任务,长期面临数据标注不一致与噪声干扰的困境。nahyeon00/mixsnips_clean数据集由研究人员于近年构建,旨在通过清洗与整合原始MixSNIPS语料库,提供高质量的训练基准。该数据集聚焦于多领域意图分类与序列标注任务,涵盖天气、音乐、导航等典型场景,其核心研究问题在于如何通过数据净化技术提升模型在真实对话中的泛化能力。作为SNIPS数据集的衍生版本,它通过严格的标注校验与格式统一,为领域内提供了可复现的评估标准,显著推动了对话系统从实验室环境向实用化场景的迁移。
当前挑战
该数据集所应对的核心挑战源于原始MixSNIPS中存在的标注歧义与领域交叉噪声,这些因素常导致模型在细粒度意图识别上产生混淆。具体挑战包括:1) 多领域意图边界模糊,例如音乐播放与天气查询的混合指令难以通过简单规则区分;2) 槽位标注一致性不足,同一语义实体在不同领域可能被赋予不同标签,影响序列标注模型的鲁棒性;3) 构建过程中需处理数据扩增带来的冗余样本,并平衡各领域样本分布以规避类别不平衡问题。此外,清洗算法需在去除噪声的同时保留原始语义多样性,这对自动化校验流程的设计提出了较高要求。
常用场景
经典使用场景
MixSNIPS_Clean数据集作为自然语言理解领域的精炼语料库,其经典使用场景聚焦于口语对话系统中的意图识别与槽位填充联合任务。该数据集对原始SNIPS数据进行了清洗与标准化处理,保留了token、tag与intent三要素对齐的标注结构,为序列标注与分类的端到端模型提供了高质量的训练基准。研究者常利用其划分清晰的训练、验证与测试集,评估BERT、LSTM-CRF等架构在多领域(如音乐、天气、导航)口语理解中的泛化性能。
实际应用
在实际应用中,MixSNIPS_Clean直接服务于智能语音助手与客服机器人的核心模块开发。基于该数据集训练的模型可精准解析用户查询中的意图(如“播放音乐”)与实体(如“歌手周杰伦”),从而驱动任务型对话的流程编排与响应生成。企业常将其作为原型验证的种子数据,用于金融、电商等垂直领域对话系统的领域适配与冷启动优化,显著降低人工标注成本。
衍生相关工作
该数据集衍生了一系列经典工作,包括基于CRF与Transformer的联合解码器设计(如BERT-Joint)、跨领域零样本意图识别框架(如Zero-Shot NLU),以及利用对比学习增强语义表征的MixSNIPS变体。此外,研究者还基于其标签结构构建了多语言扩展数据集(如MultiSNIPS),推动跨语言口语理解的研究。这些工作共同构成了面向任务型对话的语义解析技术演进脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务