kerala-recipes
收藏资源简介:
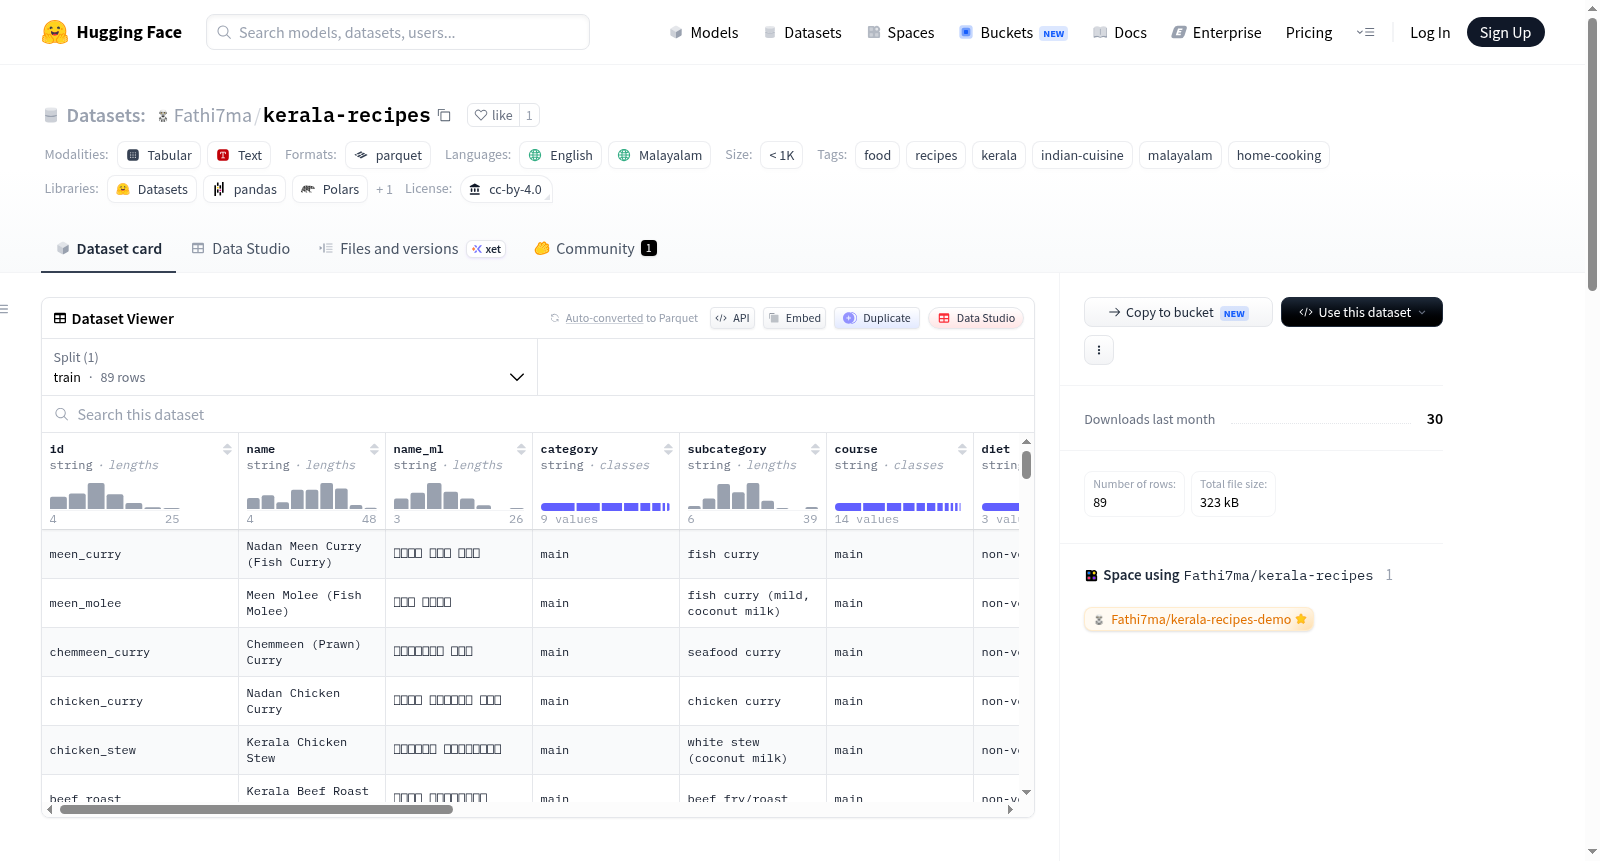
该数据集名为“Kerala Recipes & Meal Pairings”,是一个手工制作的包含89道正宗喀拉拉邦(南印度)家庭菜肴的数据集,采用CC BY 4.0许可。数据集以英语和马拉雅拉姆语双语提供,旨在保留传统“Nadan”家庭烹饪知识,以结构化格式支持食谱查看器、膳食计划或烹饪应用的构建。每道菜均提供精确的人均配料量(以家庭厨房单位如杯、汤匙、个为单位),并包含实用的缩放规则:主料和蔬菜按人数线性缩放,香料和辣椒逐步缩放以防止过量,调味和叶子类固定不变。此外,数据集包含250个传统餐食搭配推荐,展示与主菜相配的咖喱、配菜和佐餐组合(如Kappa与鱼咖喱、Puttu与Kadala,以及Onam Sadya盛宴)。文件包括:kerala_dishes.json(完整菜品记录,含配料、步骤、辣度、准备/烹饪时间)、meal_pairs.json(传统搭配推荐及完整盛宴模板)、kerala_dishes.csv(电子表格格式)。该数据集适用于食谱推荐、烹饪计算、文化传承研究等任务。
The dataset is named "Kerala Recipes & Meal Pairings," a handcrafted collection of 89 authentic Kerala (South Indian) home-style dishes, licensed under CC BY 4.0. It is bilingual in English and Malayalam, aiming to preserve traditional "Nadan" home cooking knowledge and support the construction of recipe viewers, meal planners, or cooking applications in a structured format. Each dish provides precise per-person ingredient quantities (in household units such as cups, tablespoons, pieces) and includes practical scaling rules: main ingredients and vegetables scale linearly with the number of people, spices and chilies scale gradually to prevent overuse, and seasonings and leafy items remain fixed. Additionally, the dataset contains 250 traditional meal pairing recommendations, showcasing side dishes, curries, and accompaniments that complement main dishes (e.g., Kappa with fish curry, Puttu with Kadala, and the Onam Sadya feast). Files include: kerala_dishes.json (complete dish records with ingredients, steps, spiciness, prep/cooking time), meal_pairs.json (traditional pairing recommendations and full feast templates), and kerala_dishes.csv (spreadsheet format). The dataset is suitable for tasks such as recipe recommendation, cooking computation, and cultural heritage research.
📊 数据集概述
数据集名称:Kerala Recipes & Meal Pairings
许可证:CC BY 4.0
语言:英语(en)、马拉雅拉姆语(ml)
数据规模:n<1K(少于1000条)
🍛 数据集内容
- 菜品数量:89道正宗的喀拉拉邦(南印度)家常菜,涵盖日常主食(如Nadan Meen Curry、Appam、Puttu、Avial、Thoran)和节日特色菜(如Onam Sadya、Parippu Pradhaman、Thalassery Biryani)。
- 食材与份量:
- 每道菜提供1人份基础用量,并包含实际扩展规则:
- 主食材和蔬菜:按人数线性缩放(
数量 × 人数)。 - 香料和辣椒:逐步增加,避免过量。
- 调味料和香叶:保持固定。
- 主食材和蔬菜:按人数线性缩放(
- 使用家庭厨房计量单位(杯、汤匙、茶匙、个数)以及克数。
- 每道菜提供1人份基础用量,并包含实际扩展规则:
- 传统搭配推荐:包含250条主食与咖喱、配菜、腌菜等的传统搭配链接。
- 双语名称:每道菜提供英文标题和马拉雅拉姆语脚本(如
നാടൻ മീൻ കറി)。
🗂️ 文件结构
kerala_dishes.json:完整的菜品记录,包括食材、逐步烹饪方法、辣度、准备和烹饪时间。meal_pairs.json:传统搭配推荐和完整宴席模板(如Onam Sadya、喀拉拉早餐、Kappa-Meen组合)。kerala_dishes.csv:电子表格格式。
🍃 数据集用途
该数据集旨在以结构化格式保存传统Nadan家庭烹饪知识,适用于构建菜谱查看器、膳食规划器或烹饪应用。同时提供了一个在线交互式演示(Recipe Calculator and Pairing Explorer),可访问:Kerala Recipes Demo Space。
📜 使用许可
数据集采用 CC BY 4.0 许可证,允许自由用于项目、应用和研究。