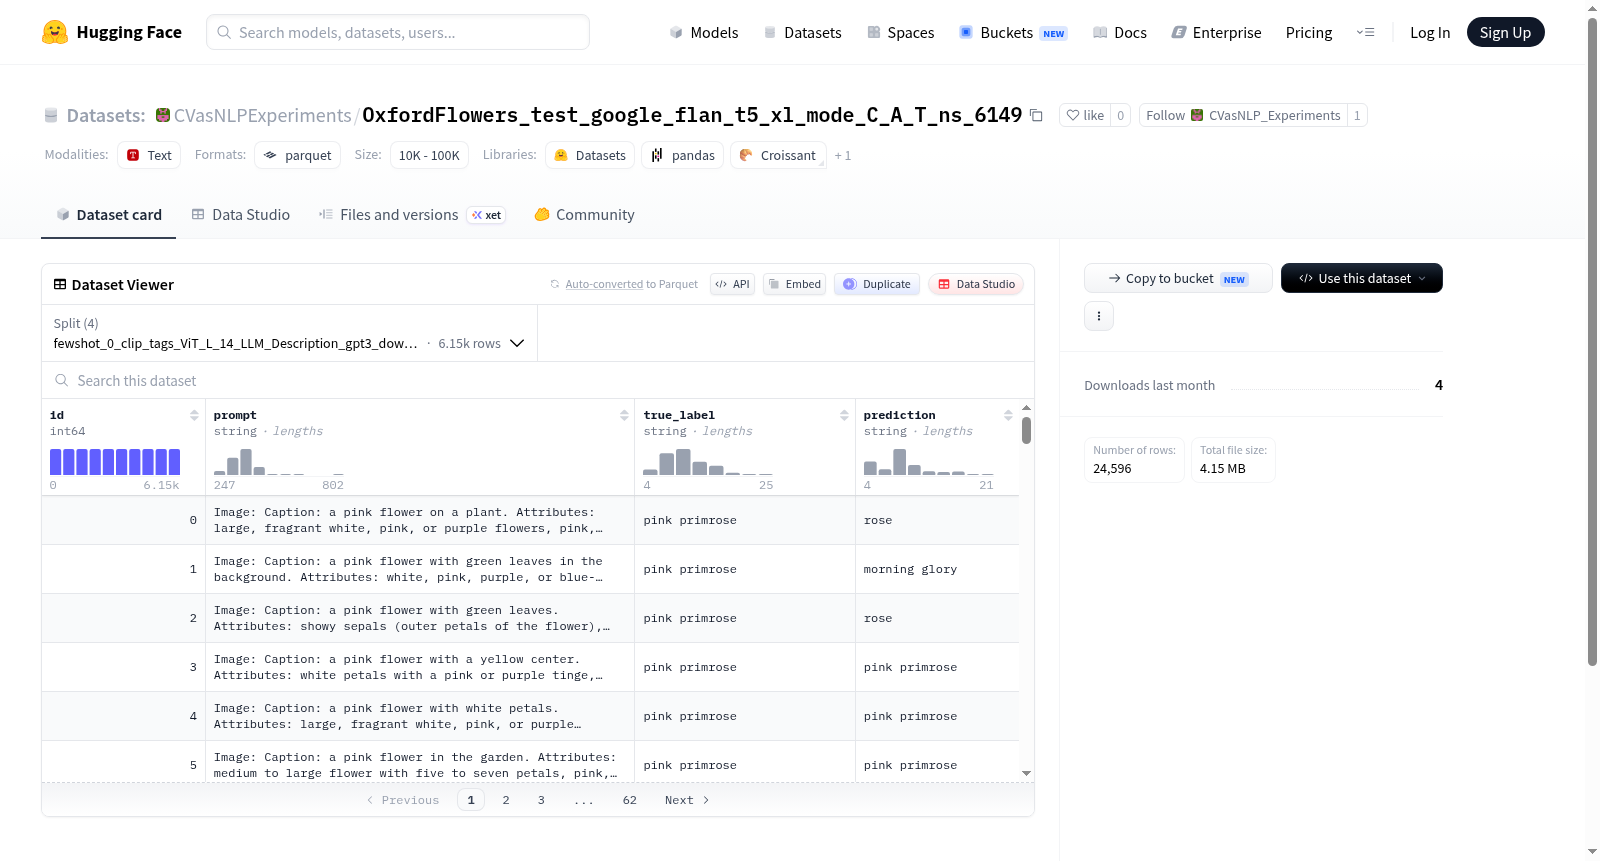
CVasNLPExperiments/OxfordFlowers_test_google_flan_t5_xl_mode_C_A_T_ns_6149
收藏资源简介:
--- dataset_info: features: - name: id dtype: int64 - name: prompt dtype: string - name: true_label dtype: string - name: prediction dtype: string splits: - name: fewshot_0_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 2519586 num_examples: 6149 - name: fewshot_1_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 4889340 num_examples: 6149 - name: fewshot_3_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 9611851 num_examples: 6149 - name: fewshot_5_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 14323006 num_examples: 6149 download_size: 4144345 dataset_size: 31343783 --- # Dataset Card for "OxfordFlowers_test_google_flan_t5_xl_mode_C_A_T_ns_6149" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征字段: - 字段名:id 数据类型:64位整数 - 字段名:提示词(prompt) 数据类型:字符串 - 字段名:真实标签(true_label) 数据类型:字符串 - 字段名:预测结果(prediction) 数据类型:字符串 数据集划分: - 划分名称:fewshot_0_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices 字节数:2519586 样本数:6149 - 划分名称:fewshot_1_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices 字节数:4889340 样本数:6149 - 划分名称:fewshot_3_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices 字节数:9611851 样本数:6149 - 划分名称:fewshot_5_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices 字节数:14323006 样本数:6149 下载大小:4144345 数据集总大小:31343783 # 「OxfordFlowers_test_google_flan_t5_xl_mode_C_A_T_ns_6149」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
- 名称: OxfordFlowers_test_google_flan_t5_xl_mode_C_A_T_ns_6149
数据集特征
- id: 整数类型 (int64)
- prompt: 字符串类型 (string)
- true_label: 字符串类型 (string)
- prediction: 字符串类型 (string)
数据集分割
- fewshot_0_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 2519586 字节
- 示例数量: 6149
- fewshot_1_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 4889340 字节
- 示例数量: 6149
- fewshot_3_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 9611851 字节
- 示例数量: 6149
- fewshot_5_clip_tags_ViT_L_14_LLM_Description_gpt3_downstream_tasks_visual_genome_ViT_L_14_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 14323006 字节
- 示例数量: 6149
数据集大小
- 下载大小: 4144345 字节
- 数据集总大小: 31343783 字节