
Ujan/gsm8k_formal_prover_judge
收藏官方服务:
资源简介:
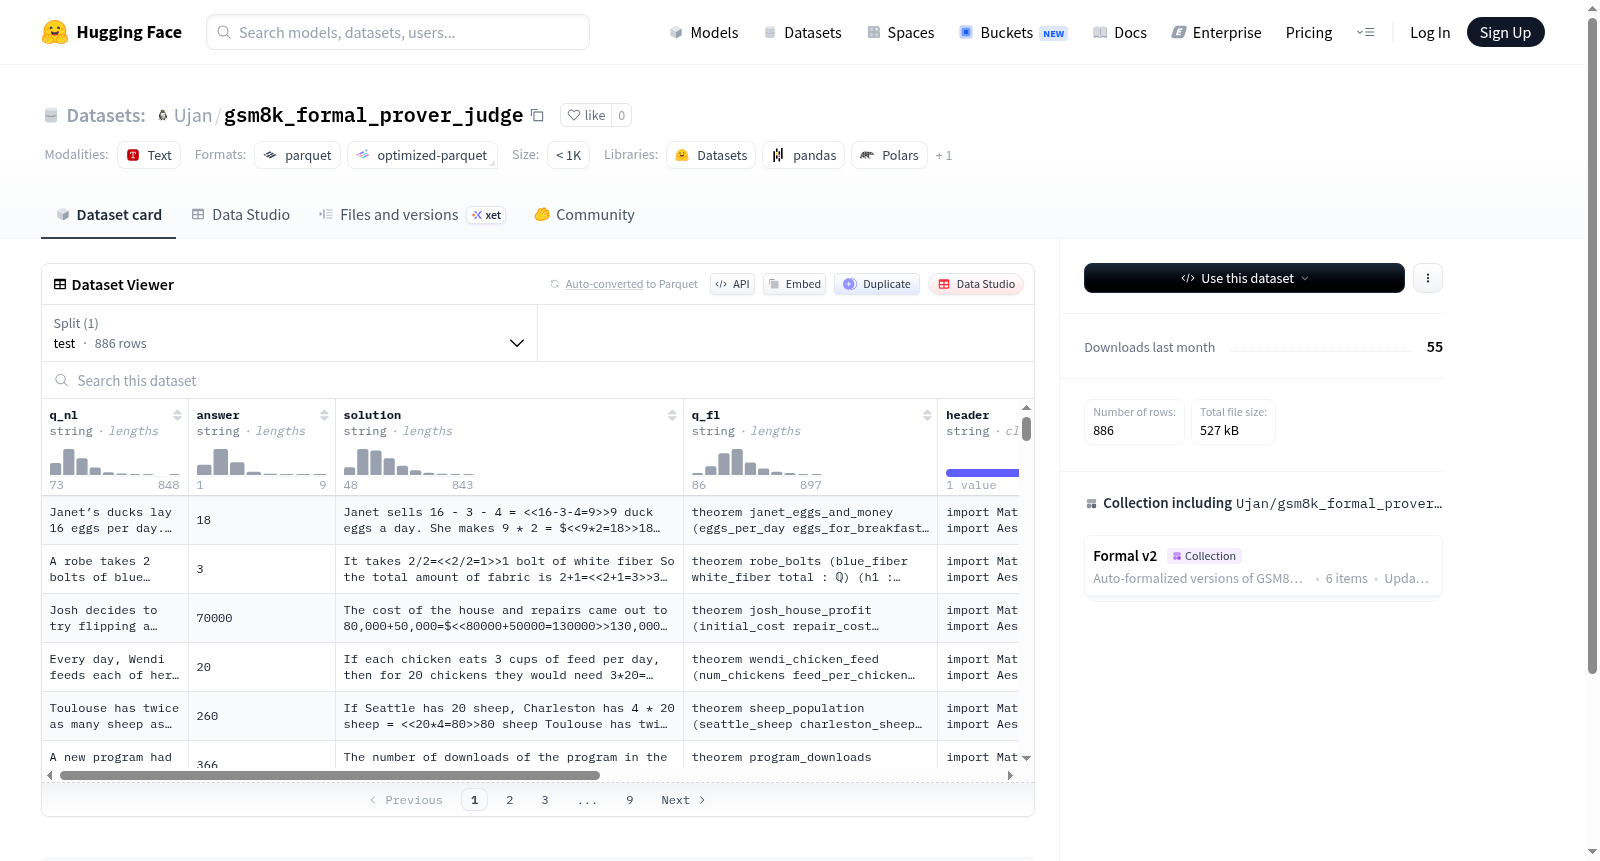
该数据集包含自然语言问题、答案、解法及形式化问题,并提供了对答案忠实性、答案匹配度、推理过程及主要问题的评判字段。主要用于评估和训练模型在数学或逻辑推理任务中的回答质量和正确性。
This dataset contains natural language questions, answers, solutions, formal language questions, and judgment fields for faithfulness, answer matches, reasoning, and major issues. It is intended for evaluating and training models on mathematical or logical reasoning tasks, focusing on response quality and correctness.
提供机构:
Ujan搜集汇总
数据集介绍
构建方式
该数据集源自GSM8K数学推理语料,通过将自然语言数学问题转化为形式化逻辑语言表述,构建了包含问题自然语言描述、形式化逻辑表达、解题步骤及标准答案的多维数据对。同时引入裁判评估维度,由模型对形式化解题过程的忠实性、答案匹配度、推理合理性及主要问题进行分类标注,形成了覆盖886个测试样本的精细化评估数据集。
特点
数据集核心亮点在于将自然语言推理与形式化证明过程相融合,通过八元组结构(q_nl, answer, solution, q_fl, header, judge_faithfulness, judge_answer_matches, judge_reasoning, judge_major_issues)完整保留了从问题输入到形式化推理验证的全链路信息。特别设计的裁判评估字段实现了对推理过程的多维质量检视,为数学推理的形式化验证研究提供了珍贵的细粒度标注资源。
使用方法
研究者可利用该数据集开展形式化数学推理的自动化验证研究,通过输入自然语言问题与形式化逻辑表述,训练模型生成符合形式化规范的解题过程,并利用裁判评估字段中的忠实度、答案匹配度等标签构建监督信号。建议将文本字段拼接为序列用于生成任务,布尔类型字段作为二分类标签,字符串列表字段作为多标签分类目标进行模型优化。
背景与挑战
背景概述
在人工智能领域,数学推理能力被视为衡量模型智能水平的重要指标,尤其是对于大型语言模型在解决复杂数学问题时的表现评估。GSM8K(Grade School Math 8K)数据集自2019年由OpenAI的研究团队提出以来,已成为评估模型算术与逻辑推理能力的基准之一,其核心研究问题聚焦于多步数学题解的正确性与可解释性。随后衍生的GSM8K Formal Prover Judge(gsm8k_formal_prover_judge)数据集,由研究者进一步扩展,旨在利用形式化证明系统对模型生成的解答进行忠实度与正确性的自动评判。该数据集包含自然语言问题、形式化问题表述、解答及多个评判维度(如忠实度、推理合理性等),为自动化验证语言模型数学推理过程提供了标准化测试平台,对推动可解释AI和形式化验证研究具有显著影响力。
当前挑战
该数据集所解决的领域问题挑战在于:传统数学推理评估往往仅关注答案正确性,而忽略了解答过程的逻辑严谨性与忠实性,难以鉴别模型是否真正理解问题或仅通过模式匹配获得答案。GSM8K Formal Prover Judge通过引入形式化语言(q_fl)与多维度评判指标(如judge_faithfulness、judge_reasoning),倒逼模型在输出时兼顾结果与过程,但构建过程面临显著困难:一是如何将自然语言问题精确转化为形式化表述而不丢失语义,这需要领域专家深度参与;二是设计统一的评判标准以覆盖推理中的细微错误——从逻辑不连贯到前提偏离——这对标注者的一致性要求极高;三是形式化证明的复杂度随问题步数增加而指数级上升,使得大规模数据集的构建在效率与质量之间难以平衡。
常用场景
经典使用场景
GSM8K_Formal_Prover_Judge数据集基于经典的小学数学推理基准GSM8K构建,专注于评估形式化定理证明器在自然语言数学问题上的推理质量。其经典使用场景在于为自动化定理证明系统提供多维度的校验标准,包括证明的忠实性、答案匹配度、推理逻辑以及主要错误检测。通过将自然语言问题转化为形式化语言表达,该数据集能够系统性地检验证明器是否准确把握问题本质,是否在推导过程中保持逻辑一致性,从而成为衡量神经符号推理系统性能的关键工具。
衍生相关工作
围绕GSM8K_Formal_Prover_Judge,衍生出了一系列关于推理过程评估与形式化验证的经典工作。例如,研究者基于该数据集提出了新的忠实性评估指标,用于量化证明过程中每一步与原始问题的语义对齐程度。另有工作利用其法官标注信息训练专门的推理校验模型,实现自动化的错误定位与修复。这些衍生研究不仅深化了对数学推理系统内部机制的理解,还推动了形式化语言与自然语言交互接口的设计,使得人工智能能够以更透明、更可信的方式参与复杂推理任务。
数据集最近研究
最新研究方向
将形式化证明与自然语言推理相结合,以提升大语言模型在数学问题求解中的忠实性与可解释性。该数据集通过GSM8K中文数学应用题,构造了自然语言与形式化逻辑表述的对应关系,并引入法官模型对解的忠实度、答案匹配度及推理过程进行多维度评判,为研究模型在复杂推理任务中的逻辑一致性提供了稀缺标注资源。当前热点聚焦于利用形式化验证锚定模型输出,以期缓解高影响力事件中暴露的模型幻觉现象,推动可信赖人工智能在数学教育、定理证明等严谨场景的落地。
以上内容由遇见数据集搜集并总结生成


