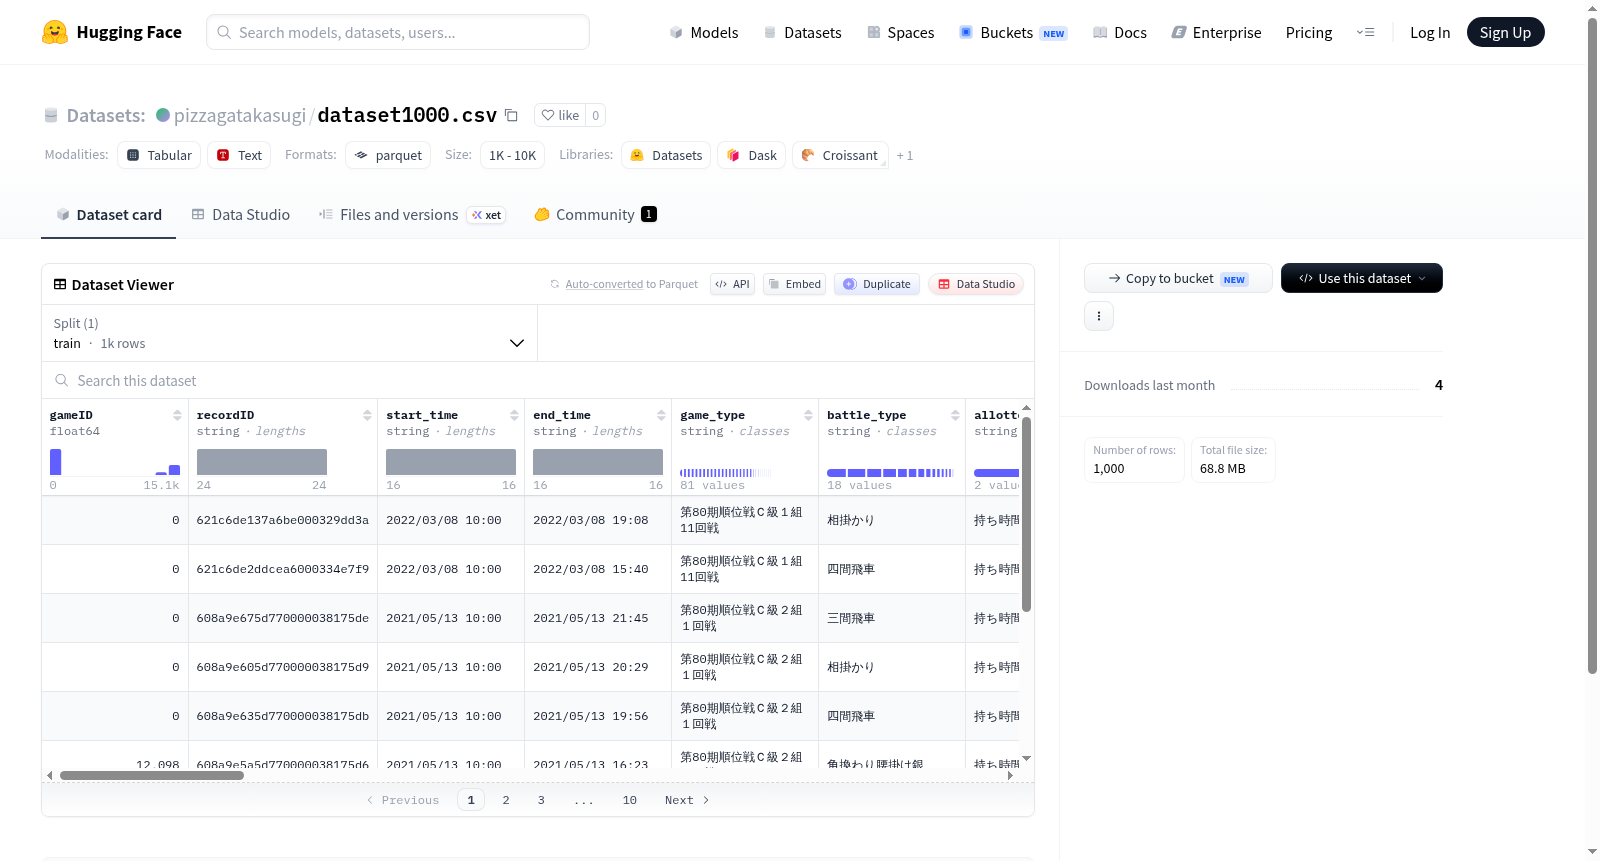
pizzagatakasugi/dataset1000.csv
收藏资源简介:
--- dataset_info: features: - name: gameID dtype: float64 - name: recordID dtype: string - name: start_time dtype: string - name: end_time dtype: string - name: game_type dtype: string - name: battle_type dtype: string - name: allotted_time dtype: string - name: seconds_time dtype: float64 - name: consumption_time dtype: string - name: place dtype: string - name: appendix dtype: string - name: league_results dtype: string - name: end_type dtype: string - name: precedence_age dtype: float64 - name: follower_age dtype: float64 - name: hurigoma dtype: string - name: timing_method dtype: string - name: pre_adding_time dtype: float64 - name: fow_adding_time dtype: float64 - name: Handicap dtype: string - name: precedence_name dtype: string - name: follower_name dtype: string - name: lunch_break dtype: string - name: dinner_break dtype: string - name: pre_lunch_time dtype: string - name: pre_omit_name dtype: string - name: fow_omit_name dtype: string - name: kif dtype: string - name: comment dtype: string - name: follwer_age dtype: float64 - name: sfen dtype: string - name: bestlist dtype: string - name: best2list dtype: string - name: debug_list dtype: string splits: - name: train num_bytes: 547404872 num_examples: 1000 download_size: 68799840 dataset_size: 547404872 configs: - config_name: default data_files: - split: train path: data/train-* ---
数据集信息: 特征列表: - 字段名:gameID,数据类型:64位浮点数(float64) - 字段名:recordID,数据类型:字符串(string) - 字段名:start_time,数据类型:字符串(string) - 字段名:end_time,数据类型:字符串(string) - 字段名:game_type,数据类型:字符串(string) - 字段名:battle_type,数据类型:字符串(string) - 字段名:allotted_time,数据类型:字符串(string) - 字段名:seconds_time,数据类型:64位浮点数(float64) - 字段名:consumption_time,数据类型:字符串(string) - 字段名:place,数据类型:字符串(string) - 字段名:appendix,数据类型:字符串(string) - 字段名:league_results,数据类型:字符串(string) - 字段名:end_type,数据类型:字符串(string) - 字段名:precedence_age,数据类型:64位浮点数(float64) - 字段名:follower_age,数据类型:64位浮点数(float64) - 字段名:hurigoma,数据类型:字符串(string) - 字段名:timing_method,数据类型:字符串(string) - 字段名:pre_adding_time,数据类型:64位浮点数(float64) - 字段名:fow_adding_time,数据类型:64位浮点数(float64) - 字段名:Handicap,数据类型:字符串(string) - 字段名:precedence_name,数据类型:字符串(string) - 字段名:follower_name,数据类型:字符串(string) - 字段名:lunch_break,数据类型:字符串(string) - 字段名:dinner_break,数据类型:字符串(string) - 字段名:pre_lunch_time,数据类型:字符串(string) - 字段名:pre_omit_name,数据类型:字符串(string) - 字段名:fow_omit_name,数据类型:字符串(string) - 字段名:kif,数据类型:字符串(string) - 字段名:comment,数据类型:字符串(string) - 字段名:follwer_age,数据类型:64位浮点数(float64) - 字段名:sfen,数据类型:字符串(string) - 字段名:bestlist,数据类型:字符串(string) - 字段名:best2list,数据类型:字符串(string) - 字段名:debug_list,数据类型:字符串(string) 拆分信息: - 拆分名称:train(训练集),字节数:547404872,样本数量:1000 下载大小:68799840 字节 数据集总大小:547404872 字节 配置项: - 配置名称:default(默认配置),数据文件: - 拆分:train(训练集),路径:data/train-*
数据集概述
数据集特征
- gameID: float64
- recordID: string
- start_time: string
- end_time: string
- game_type: string
- battle_type: string
- allotted_time: string
- seconds_time: float64
- consumption_time: string
- place: string
- appendix: string
- league_results: string
- end_type: string
- precedence_age: float64
- follower_age: float64
- hurigoma: string
- timing_method: string
- pre_adding_time: float64
- fow_adding_time: float64
- Handicap: string
- precedence_name: string
- follower_name: string
- lunch_break: string
- dinner_break: string
- pre_lunch_time: string
- pre_omit_name: string
- fow_omit_name: string
- kif: string
- comment: string
- follwer_age: float64
- sfen: string
- bestlist: string
- best2list: string
- debug_list: string
数据集分割
- train:
- num_bytes: 547404872
- num_examples: 1000
数据集大小
- download_size: 68799840
- dataset_size: 547404872