
遇见数据集

sulabhkatiyar/ne-asr-trp-aug

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

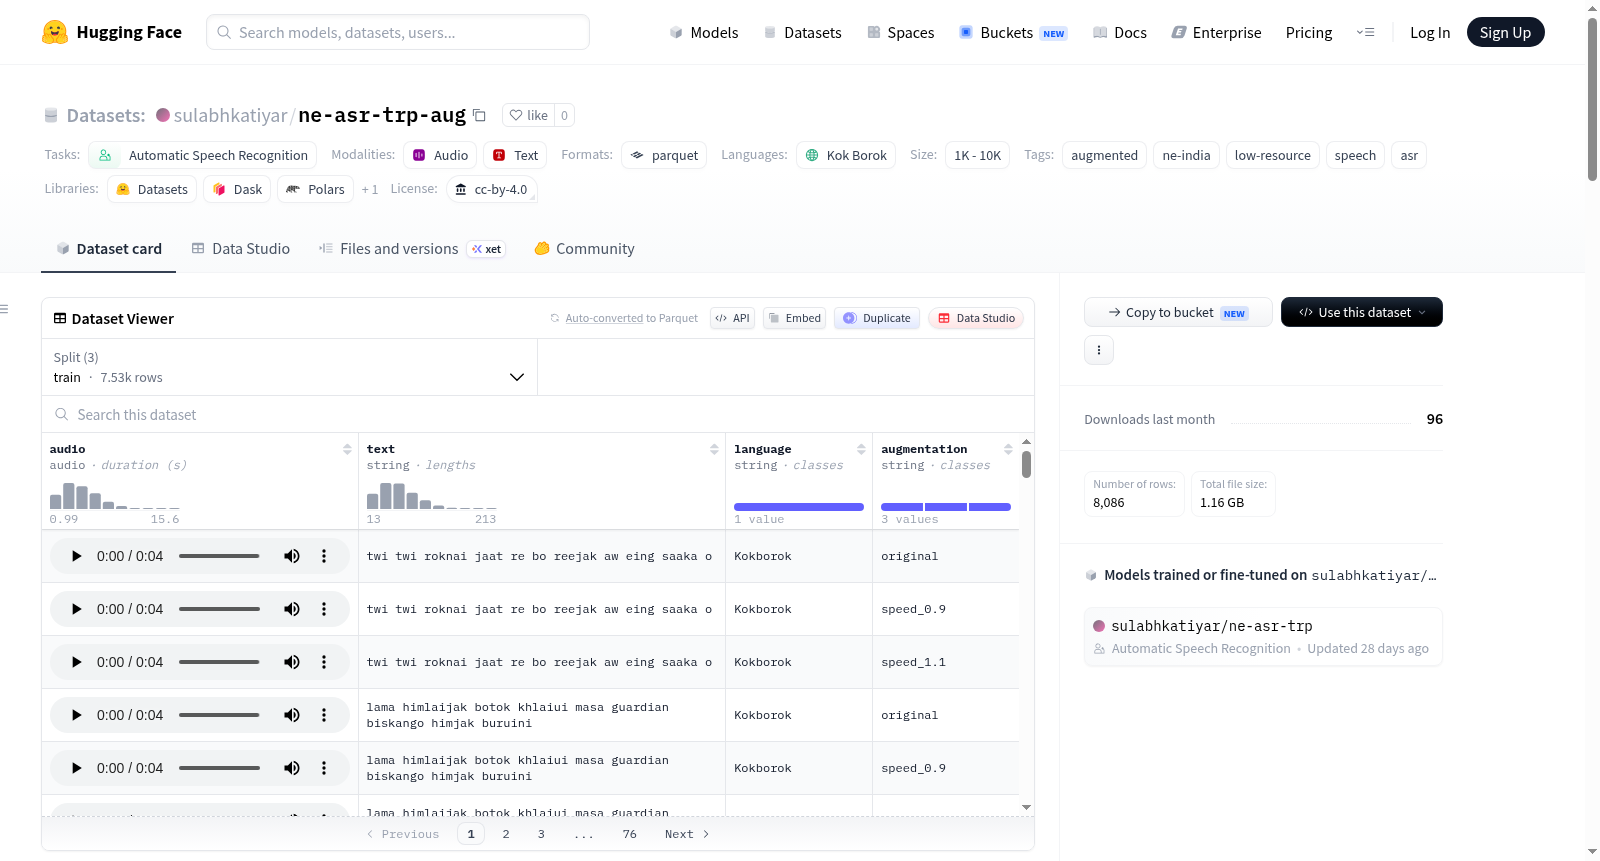
NE ASR增强数据集——Kokborok(trp)是一个用于自动语音识别(ASR)的增强数据集,专门针对Kokborok语言(ISO 639-3代码:trp)。Kokborok是一种藏缅语系语言,在印度特里普拉邦使用,属于声调语言,具有高/低两种音位声调。该数据集基于原始数据集sulabhkatiyar/ne-asr-trp(来自ARTPARK-IISc Vaani项目)进行增强,当前版本为v2(重建于2026-05-29),仅应用速度扰动增强(因子为0.9、1.0、1.1),避免了音高移位,以保护声调对比。数据集包含训练集(7,533个样本,3倍增强)、验证集(274个样本)和测试集(279个样本),估计原始音频时长约3.8小时,增强后约11.4小时。数据格式包括16kHz单声道WAV音频(以Parquet格式存储)、文本转录、语言和增强标签(如original、speed_0.9、speed_1.1)。许可证为CC-BY-4.0。

The NE ASR Augmented Dataset -- Kokborok (trp) is an augmented automatic speech recognition (ASR) dataset for the Kokborok language (ISO 639-3: trp). Kokborok is a Tibeto-Burman language spoken in Tripura, India, and is a tonal language with two phonemic tones (high/low). The dataset is augmented from the original dataset sulabhkatiyar/ne-asr-trp (from the ARTPARK-IISc Vaani project). The current version is v2 (rebuilt on 2026-05-29), applying only speed perturbation augmentation (factors: 0.9, 1.0, 1.1) while disabling pitch shift to preserve tonal contrasts. It includes a training set (7,533 samples, 3x augmentation), a validation set (274 samples), and a test set (279 samples), with an estimated original duration of ~3.8 hours and augmented duration of ~11.4 hours. The data format consists of 16kHz mono WAV audio (stored as Parquet), text transcriptions, language, and augmentation labels (e.g., original, speed_0.9, speed_1.1). The license is CC-BY-4.0.
提供机构:
sulabhkatiyar
搜集汇总
数据集介绍
sulabhkatiyar/ne-asr-trp-aug 数据集图片
构建方式
该数据集基于ARTPARK-IISc Vaani项目收集的Kokborok语音数据构建而成。原始数据包含约3.8小时、2,511条训练样本,通过速度扰动技术进行扩充,采用0.9x、1.0x和1.1x三种速度因子,每个原始样本衍生出3个变体,最终训练集增至7,533条。鉴于Kokborok是一种拥有高低两个音位声调的声调语言,设计策略特意禁用了音高偏移增强,避免破坏声调对比信息。验证集和测试集保持原始状态未做任何增强。
特点
该数据集专为低资源自动语音识别任务设计,具有鲜明的声调敏感性特点。音频以16kHz单声道WAV格式存储于Parquet文件中,包含音频、文本、语言和增强标记四个特征字段。每个样本标注增强类型(原始、速度0.9、速度1.1),便于研究者在实验中灵活筛选。增强后总时长约11.4小时,训练集分成6个分片,有效扩充了Kokborok这一藏缅语族语言的语音资源规模。
使用方法
可通过HuggingFace Datasets库直接加载使用,调用load_dataset函数即可获取完整数据集。支持split参数指定加载训练、验证或测试子集。利用filter方法可根据augmentation特征字段精准过滤样本类型,例如仅保留原始样本或特定速度扰动变体。在训练流程中,建议配合SpecAugment参数使用,包括时间遮蔽概率0.07和特征遮蔽概率0.05等,以进一步提升模型鲁棒性。
背景与挑战
背景概述
ne-asr-trp-aug数据集由Sulabh Katiyar等人于2025年构建,专注于Kokborok语(trp)的自动语音识别任务。Kokborok语是一种藏缅语系语言,主要分布于印度特里普拉邦,属于资源匮乏的低资源配置语言,仅有约3.8小时原始语音数据。该数据集源自ARTPARK-IISc Vaani项目,通过速度扰动增强技术将训练样本扩展至7,533条(约11.4小时),旨在促进低资源声学模型的鲁棒性。其核心研究问题是如何在不破坏声调语言音位对立的前提下有效扩充数据,为印度东北部濒危语言语音技术发展提供了关键基准。
当前挑战
该数据集面临的核心挑战在于Kokborok语作为高低双声调语言,音高扰动会破坏词汇间的声调对立,因此增强策略必须规避音高变化。构建过程中,v1版本因错误启用音高扰动而被废弃,暴露了声调语言数据增强的敏感性。此外,原始资源仅3.8小时,低资源条件限制了模型泛化能力;需借助速度扰动(0.9x、1.1x)和在线SpecAugment等轻量化手段平衡数据量与声学真实性。数据格式上,采用Parquet压缩存储16kHz音频,兼顾效率与可重复性,但跨项目协作的标准化仍有待完善。
常用场景
经典使用场景
该数据集专为低资源语言Kokborok(trp)的自动语音识别(ASR)模型训练而设计,其经典使用场景在于构建和评估针对声调语言的端到端语音识别系统。通过速度扰动(0.9x、1.0x、1.1x)实现3倍数据扩充,同时明确禁用音高偏移以保护该语言高低二调的音位对立,为声调语言的鲁棒ASR研究提供了精准且无破坏性的训练基础。
实际应用
在实际应用中,该数据集赋能了面向印度东北部濒危语言Kokborok的语音交互系统,可用于开发语音转文字、语音搜索及口述记录等工具。其增强后的11.4小时音频覆盖了不同语速的变体,提升了模型在真实多变环境下的泛化能力,为Tripura地区的语言教育、文化遗产数字化及人机无障碍沟通提供了技术支撑。
衍生相关工作
该数据集衍生了多项关键工作,包括基于Wav2Vec2或Whisper等预训练模型的下游微调任务,以及针对声调语言设计的特殊增强管道(如速度扰动与SpecAugment的联合配置)。其重建过程(v2版本)和音调审计报告为后续研究提供了宝贵的最佳实践范例,激励了更多针对低资源语言的敏感型数据增强策略探索,如噪声混合与多语种迁移学习的融合。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

