DocTalkBN
收藏资源简介:
DocTalkBN是一个大规模多模态孟加拉语专家远程医疗对话数据集,由孟加拉国工程技术大学构建。该数据集包含557.63小时的时间对齐音频与文本,涵盖1,515个多轮患者通话与10,274个主持-医生问答对,总计1.7M tokens,覆盖26个医学专科。数据源自全国广播的实时远程医疗节目,经自动字幕、人工验证、去标识化及结构化处理而成。该数据集旨在为低资源语言提供真实临床对话资源,支持医疗分诊分类、建议安全评估、医学命名实体识别等下游任务,推动可靠医疗NLP的发展。
DocTalkBN is a large-scale multimodal Bengali expert telemedicine dialogue dataset constructed by Bangladesh University of Engineering and Technology. It contains 557.63 hours of time-aligned audio and text, covering 1,515 multi-turn patient calls and 10,274 host-doctor question-answering pairs, totaling 1.7 million tokens and spanning 26 medical specialties. The data is sourced from nationwide live broadcast telemedicine programs, and has undergone automatic subtitling, manual verification, de-identification and structured processing. This dataset aims to provide authentic clinical dialogue resources for low-resource languages, supporting downstream tasks such as medical triage classification, safety assessment of recommendations, medical named entity recognition and other related tasks, so as to promote the development of reliable medical natural language processing.
DocTalkBN 数据集详情
数据集概述
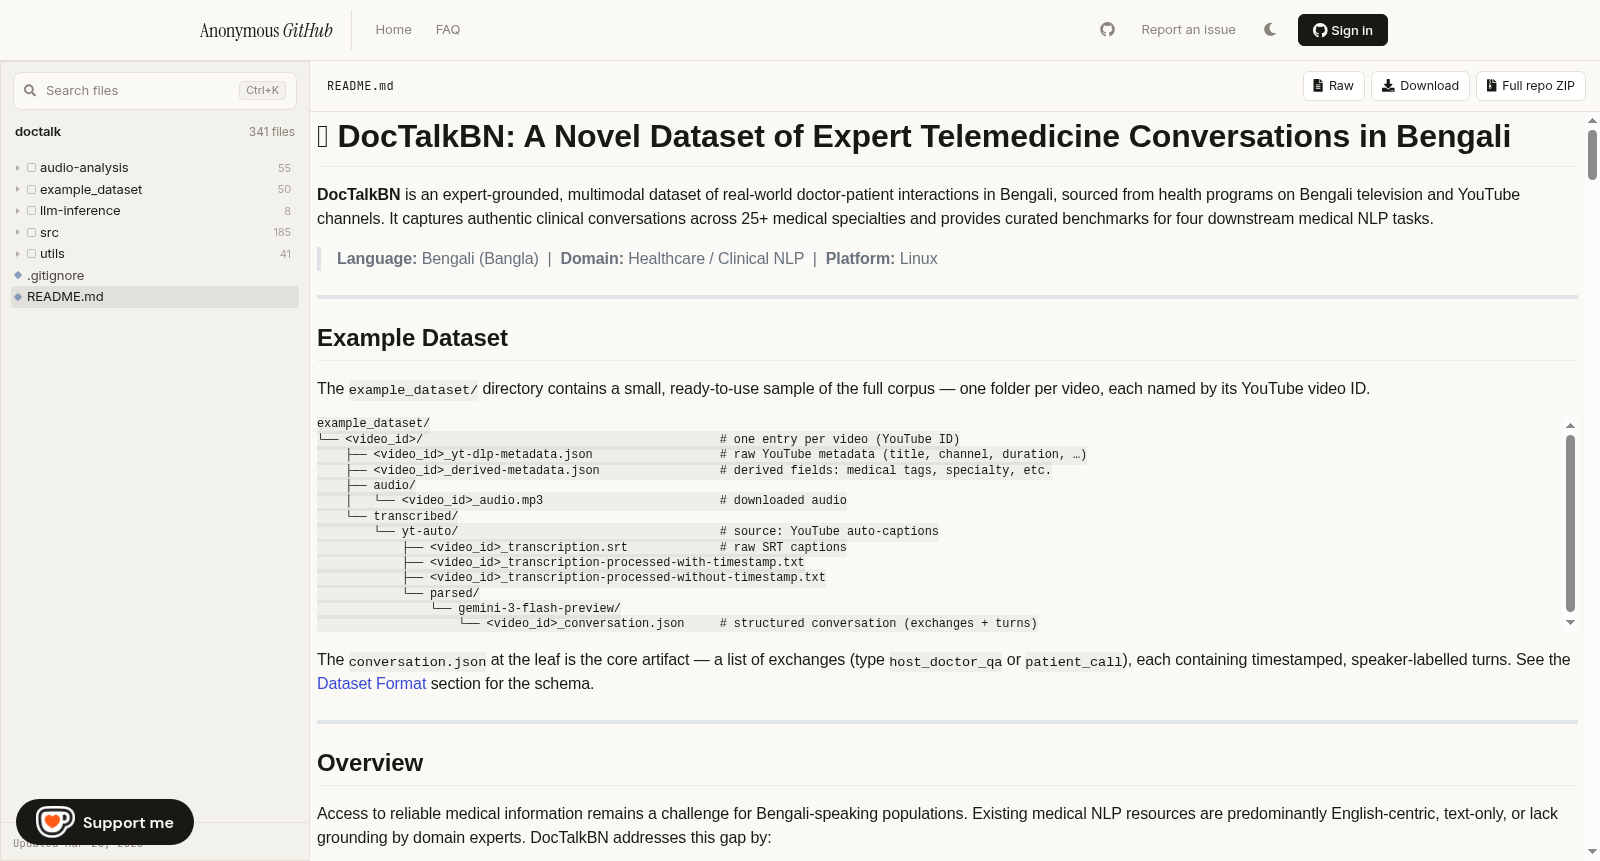
DocTalkBN 是一个基于专家真实远程医疗对话的孟加拉语多模态数据集,数据来源于孟加拉语电视频道和 YouTube 频道的健康节目。该数据集涵盖 25 个以上医学专科的真实临床对话,并为四项下游医学 NLP 任务提供了基准测试集。
- 语言:孟加拉语(Bangla)
- 领域:医疗保健 / 临床 NLP
- 平台:Linux
数据来源
DocTalkBN 聚合了来自 14 个主要孟加拉语电视频道的健康节目内容,包括:
| 频道 | 节目 |
|---|---|
| BTV | স্বাস্থ্য জিজ্ঞাসা |
| ATN Bangla | Sustho Thakun |
| NTV | Shastho Protidin |
| RTV | Sustho Thakun |
| MyTV | My Health |
| GTV | Doctors Chamber |
| DBC News | স্বাস্থ্যকথা |
| Channel 24 | সুরক্ষায় প্রতিদিন, Sustho Merudondo |
| Jamuna TV | Doctors On Call |
| Maasranga TV | Doctors Chamber |
| Deepto | Sustha Jibon |
| Banglavision | Shastha Katha |
| Boishakhi TV | Boishakhi Health |
| News24 | Health Tips |
覆盖的医学专科包括心脏病学、神经病学、胃肠病学、儿科、精神病学、骨科、皮肤病学、内分泌学等 17 个以上专科。
数据格式
每个处理后的视频以 JSON 数组存储对话交换记录。每个交换记录包含 type(类型)、timestamp(时间戳)和 turns(说话者轮次列表)。
两种交换类型:
host_doctor_qa— 主持人 与医生之间的讨论(一般医学问答)patient_call— 患者电话在线咨询
示例结构:
json [ { "type": "host_doctor_qa", "timestamp": "00:01:15.910", "turns": [ { "speaker": "host", "text": "..." }, { "speaker": "doctor", "text": "..." } ] }, { "type": "patient_call", "timestamp": "00:12:12.389", "turns": [ { "speaker": "patient", "text": "..." }, { "speaker": "doctor", "text": "..." } ] } ]
下游任务
| 任务 | 描述 | 输入 | 输出 |
|---|---|---|---|
| 医学命名实体识别(Medical NER) | 识别临床文本中的医学实体 | 文本片段 | BIO 标注实体(疾病、药物、症状等) |
| 医学分诊(Medical Triage) | 分类患者病例的紧急程度 | 患者档案(对话历史) | 家庭护理 / 就诊 / 急诊 |
| 建议安全性(Advice Safety) | 检测潜在有害的医学建议 | (患者档案,建议)对 | 安全 / 不安全 |
数据集构建流程
- 视频搜索与元数据收集 — 从 YouTube 搜索并抓取健康节目视频(使用 yt-dlp)
- 医疗视频筛选 — 通过 LLM(如 qwen3:30b-instruct)进行医疗保健视频过滤
- 元数据提取与转录获取 — 获取 YouTube 自动字幕(SRT)并提取医学标签、专科等派生元数据
- 转录解析 — 使用 Gemini 3 Flash Preview 将 SRT 字幕解析为结构化对话
- 下游数据集生成 — 分别生成 Medical NER、Triage 和 Advice Safety 数据集
- 数据划分 — 组织为 80/10/10 的训练/验证/测试集
支持模型与基线
封闭源 LLM
- GPT-4O(OpenAI)
- Gemini 2.5 Flash(Google)
- Gemini 3 Flash Preview(Google)
开源 LLM
- Qwen3-32B(32B 参数)
- Qwen3-30B-Instruct(30B 参数)
BERT 类与嵌入模型
| 模型 | HuggingFace ID | 参数量 | 适用任务 |
|---|---|---|---|
| BanglaBERT | csebuetnlp/banglabert |
~110M | NER, Triage |
| mmBERT | jhu-clsp/mmBERT-base |
~307M | NER, Triage |
| multilingual-MiniLM | sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 |
紧凑 | Triage, Advice Safety |
| multilingual-E5-small | intfloat/multilingual-e5-small |
紧凑 | Triage, Advice Safety |
推理与评估
支持零样本(zero-shot)、少样本(few-shot)、**思维链(CoT)及微调(finetuned)**四种推理模式,可同时运行多个任务和多个模型进行批量推理。
评估脚本包括:
- 分诊分类指标(每类 + 宏/微 F1)
- NER 评估(BIO 格式,seqeval 兼容)
- 建议安全性指标
未来工作
团队正在开发 建议生成(Advice Generation) 任务,该任务将仅基于患者档案生成自由文本医学建议,并计划采用 LLM-as-a-judge 评估以及自动评估指标(BLEU、token 重叠)。