saraiki-linguistic-super-dataset
收藏资源简介:
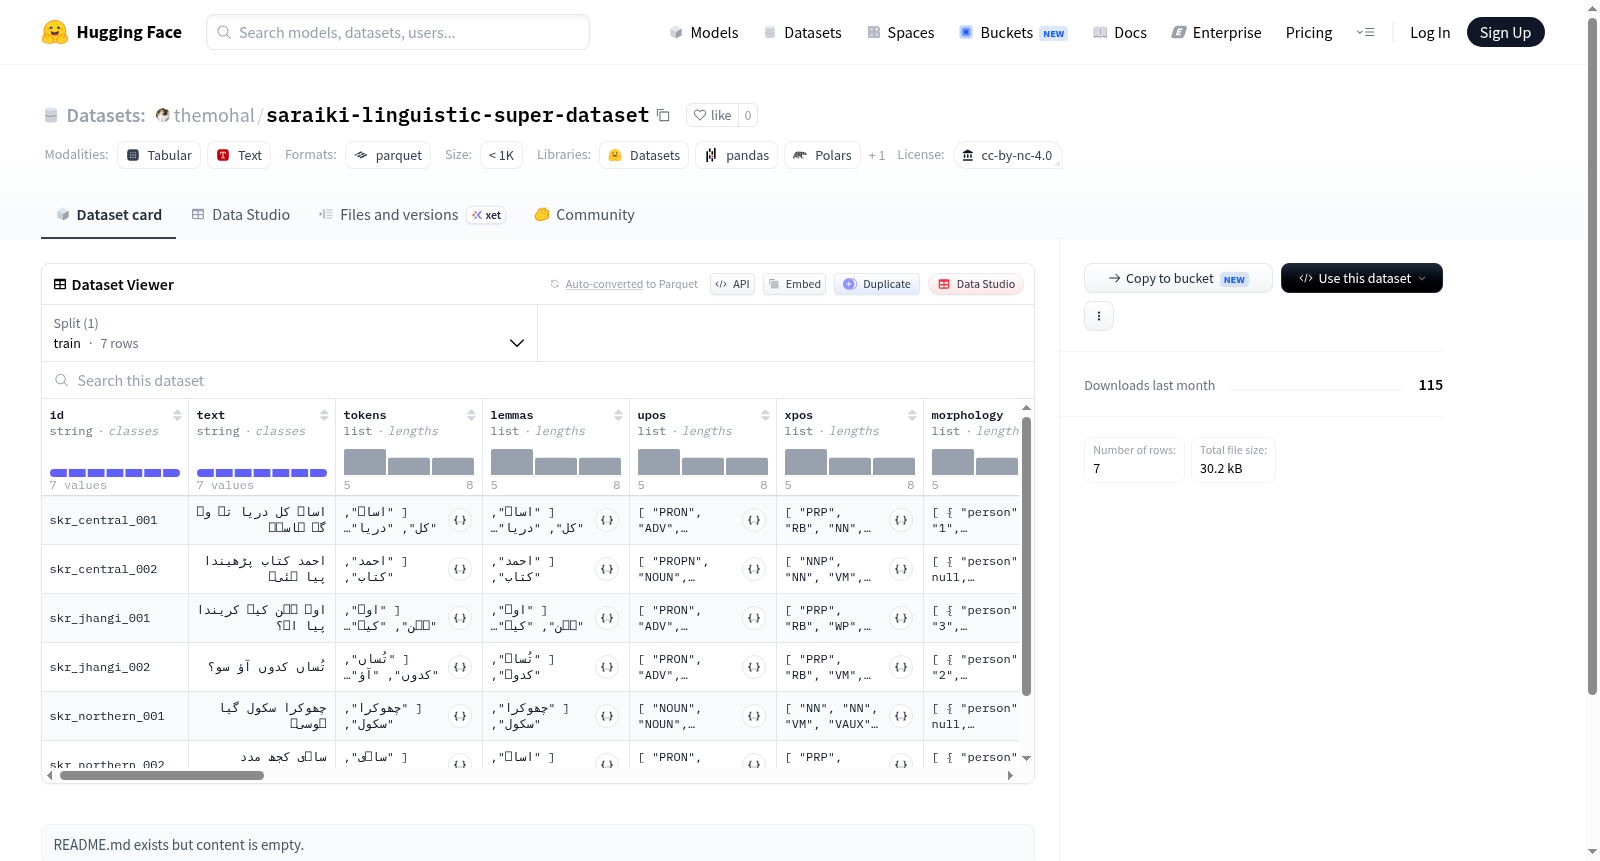
该数据集是一个多语言/方言的语料库,包含 7 个训练样本。每个样本包含文本(text)及其对应的词性标注(upos, xpos)、词形还原(lemmas)、依存关系(dependency_heads, dependency_relations)、命名实体标签(ner_tags)、多词表达式标签(mwe_tags)、形态特征(morphology,包括人称、数、性、格、时态、体、语气、语态)、语义角色(semantic_roles)、指代(coreference)等信息。此外,还提供了方言信息(macro_dialect, local_variety, dialect_region, dialect_confidence, dialect_basis)、代码切换(code_switch, matrix_language, token_languages)、语域(register)、语言(language)和文字(script)等元数据。数据集基于 CC-BY-NC-4.0 许可证发布,适用于语言学分析、词性标注、命名实体识别、依存分析、语义角色标注、指代消解、方言识别等自然语言处理任务。
This dataset is a multilingual/dialectal corpus containing 7 training samples. Each sample includes text and its corresponding part-of-speech tags (upos, xpos), lemmas, dependency relations (dependency_heads, dependency_relations), named entity tags (ner_tags), multi-word expression tags (mwe_tags), morphological features (morphology, including person, number, gender, case, tense, aspect, mood, voice), semantic roles (semantic_roles), and coreference (coreference). Additionally, it provides metadata such as dialect information (macro_dialect, local_variety, dialect_region, dialect_confidence, dialect_basis), code-switching (code_switch, matrix_language, token_languages), register, language, and script. The dataset is released under the CC-BY-NC-4.0 license and is suitable for linguistic analysis, part-of-speech tagging, named entity recognition, dependency parsing, semantic role labeling, coreference resolution, dialect identification, and other natural language processing tasks.
Saraiki 语言超级数据集 (saraiki-linguistic-super-dataset)
数据集概述
这是一个面向萨莱基语(Saraiki) 的多层级语言资源数据集,旨在为自然语言处理任务提供丰富的语言学标注信息。数据集包含7个训练样本,总大小约7KB。
许可与授权
- 许可证:CC BY-NC 4.0(知识共享-非商业使用-相同方式共享4.0国际版),仅允许非商业用途。
数据特征
数据集包含25个特征字段,覆盖从词汇到句法、语义、语篇等多维度标注:
| 类别 | 特征 |
|---|---|
| 基础文本 | id、text、tokens、lemmas |
| 词法标注 | upos(通用词性)、xpos(特定词性)、morphology(形态标注:人称、数、性、格、时态、体、语气、语态) |
| 句法标注 | dependency_heads(依存头)、dependency_relations(依存关系) |
| 命名实体 | ner_tags(命名实体标注) |
| 多词表达 | mwe_tags(多词表达式标签) |
| 方言信息 | macro_dialect(宏观方言)、local_variety(本地变体)、dialect_region(方言区域)、dialect_confidence(方言置信度)、dialect_basis(方言判定依据) |
| 语码混合 | code_switch(语码切换)、matrix_language(主语言)、token_languages(词元语言) |
| 语义标注 | semantic_roles(语义角色:谓词索引、跨度起止、角色标签) |
| 指代消解 | coreference(指代簇:簇ID、提及的token起止) |
| 语域与语言 | register(语域)、language(语言)、script(文字系统) |
| 来源与验证 | source_type(来源类型)、generation_model(生成模型)、prompt_version(提示词版本)、research_grounded(研究依据)、verified(验证状态)、verification_score(验证评分) |
数据拆分
- 单一训练集:共7个样本,序列化大小为7083字节。
技术说明
- 下载总大小:25,654字节(约25KB)
- 数据文件路径:
data/train-*(通配符匹配) - 包含完整的形态学、依存句法、语义角色、指代消解等深度语言学标注工具链信息。