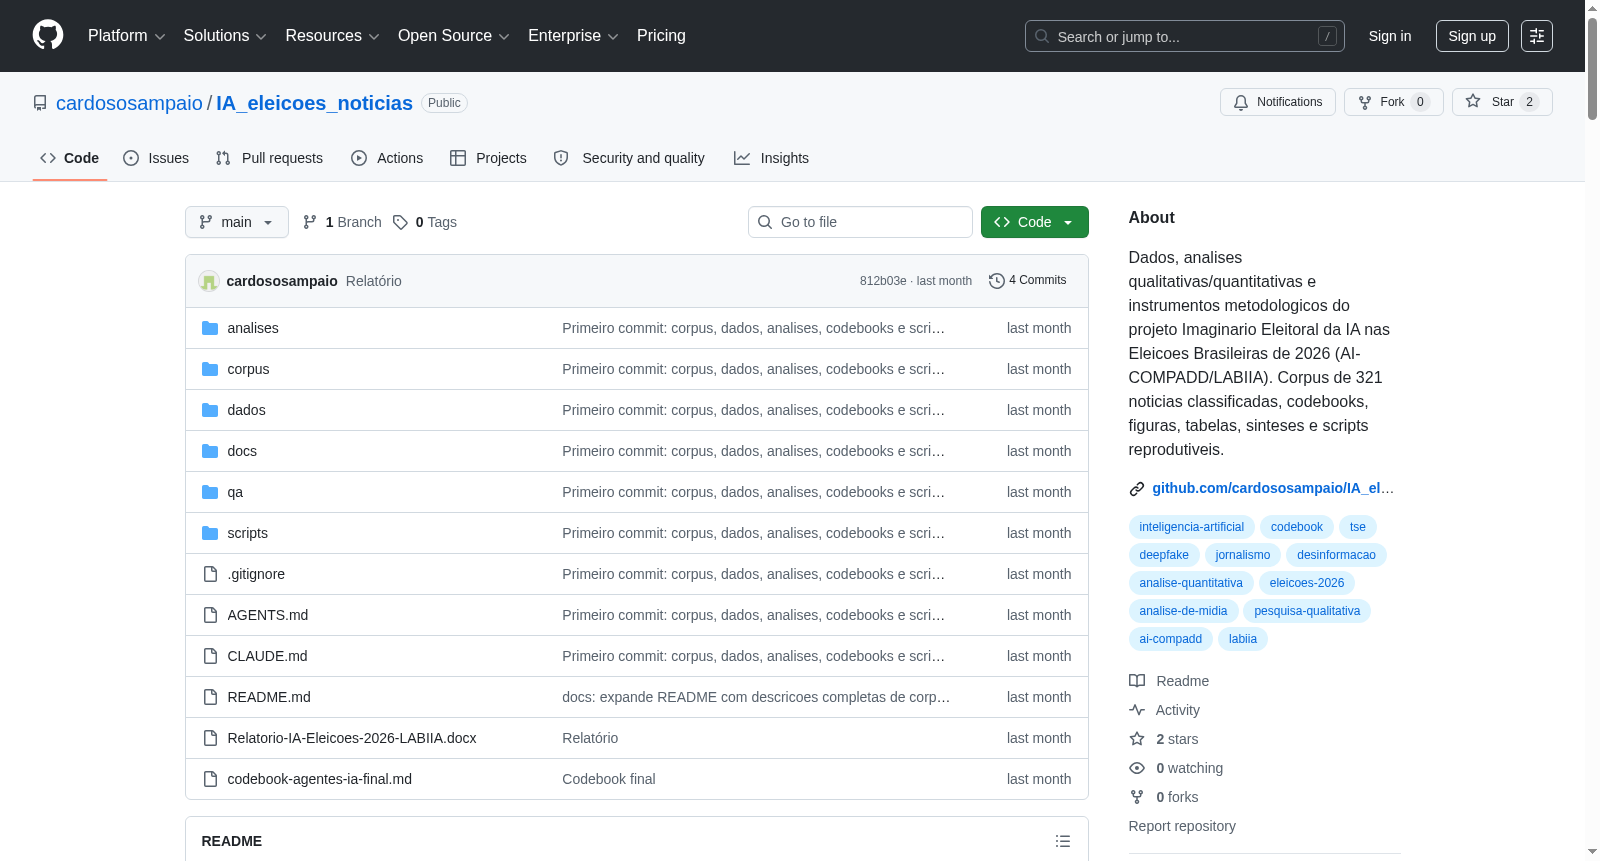
IA_eleicoes_noticias
收藏资源简介:
该数据集包含321篇巴西新闻文章,涉及2026年巴西选举中人工智能(AI)的使用、风险和监管报道。数据集经过人工和AI辅助分类,涵盖22个字段,包括媒体来源、叙事框架、AI机制、平台、叙事效价、证据水平和监管响应等维度。数据集提供结构化数据文件(如CSV和JSON格式),并附有分类语料、证据文本和可视化分析结果。
This dataset contains 321 Brazilian news articles focusing on coverage of the utilization, risks, and regulatory oversight of artificial intelligence (AI) in the 2026 Brazilian general election. The dataset underwent manual and AI-aided classification, and includes 22 fields covering dimensions such as media source, narrative framework, AI mechanisms, platforms, narrative valence, evidence level, and regulatory responses. It provides structured data files in formats including CSV and JSON, alongside classified corpora, evidence texts, and visual analysis results.
数据集概述
该数据集(IA_eleicoes_noticias)来自研究项目 “Imaginário Eleitoral da Inteligência Artificial nas Eleições Brasileiras de 2026”(2026年巴西选举中人工智能的选举想象),由 AI-COMPADD / LABIIA 实验室开发,旨在研究巴西媒体如何报道2026年选举中的人工智能话题,重点关注叙事框架、技术机制、国家监管回应及政治媒体想象形象。
数据规模与组成
- 规模:经过筛选和分析后,数据集包含 321篇 新闻报道。
- 时间范围:覆盖2026年1月至6月,主要是预选期和巴西高等选举法院(TSE)监管期。
- 采集来源:来自巴西各大新闻媒体,通过 Google News RSS 和 Playwright 等方式采集,部分来源可能涉及付费墙。
- 筛选标准:原始采集编号从
BR-2026-0001到BR-2026-0425,存在空缺编号,对应被排除的无效或内容不合格的材料。
数据内容与分类维度
数据集包含一个专用的编码手册(codebook),涵盖 8个分析维度,共 22个字段,所有文章经过人工及监督式AI代理的共同分类。主要维度包括:
- 媒体/发布者
- 文章体裁
- 主要叙事主体(例如:国家/TSE、平台、候选人等)
- AI机制/技术(如:深度伪造、机器人等)
- 数字平台(如:Meta等)
- 叙事价值倾向
- 证据级别
- 监管回应
- 巴西特有标志
存储结构
corpus/ — 分类语料
- 321个文件(
BR-2026-XXXX.md),每篇新闻包含:原始URL、摘要、详细分类字段、文本证据、质量审查备注。
dados/ — 结构化数据库
base_classificacao.csv:最终规范分类(321行)。manifesto_corpus.csv:筛选过程记录。dataset/dataset.csv:解析后的标准格式(321行,29列)。dataset/dataset_long.csv:标准化行格式,便于交叉分析。dataset/evidencias.csv:3,999条 文本证据,含源文件标记。dataset/parse_report.json:解析诊断报告。dados/indices/quantitativo_resumo.json:关键量化指标索引。
analises/ — 分析结果
analises/figuras/:8张高分辨率可视化图表,包括:机制分布、平台分布、叙事价值×证据级别、机制共现、叙事主体分布、媒体类型×价值、时间序列、综合指数。analises/tabelas/:21个CSV表格,含单变量、双变量、共现、时间序列等统计。analises/sintese/:定性综合材料,包括:- 9个选举想象形象(如:审判官/警长、诽谤性深度伪造、不负责任的平台、口袋里的神谕、群机器人等)。
- 词汇词典:按语义场分组。
- 意外发现:跨批次重复出现的定性发现。
- 13篇锚定文章:涵盖5种叙事框架。
- 编码异常报告。
analises/notas/:11个批次的定性阅读笔记。
docs/ — 方法文档
- 编码手册(
codebook-agentes-ia-final.md、livro-codigos-final.md)及JSON Schema。 - 操作指南与采集经验教训(
aprendizados.md、GUIA-OPERACAO-CLASSIFICACAO.md)。 - 分类AI代理提示模板(
prompt-classificador-agente-ia.md)。 - 报告撰写支持材料(证据矩阵、主题综合等)。
scripts/ — 可复现脚本
- 采集脚本:PDF下载、批量下载、采集波次审查。
- 分类/解析脚本:编码管道、验证器、语料解析器(
.md→ CSV)。 - 分析脚本:生成量化图表、阅读笔记、定性综合、报告草稿。
qa/ — 最终审计
qa-final.md:包含数据审计、解释锚定、确认偏误测试及最终结论的审查报告。
主要发现摘要
- 国家/制度中心主义:85% 以上文章的主要叙事主体是 国家/TSE;监管中心指数(IR)高达 0.963。
- 高具体性:80% 的文章基于有证据文献的事实;具体性指数(IC)为 0.769。
- 主导AI机制:深度伪造(deepfake) 出现在 68.5% 提及AI机制的文章中。
- 最常提及平台:Meta(占提到平台文章的39%)。
- 主导叙事框架:AI可监管,其次是 AI威胁 和 AI神谕。
- 最强选举想象形象:审判官/警长、诽谤性深度伪造、不负责任的平台、口袋里的神谕、群机器人。
使用说明
- 快速导航:建议从
corpus/BR-2026-0001.md开始了解格式,然后查看dados/base_classificacao.csv获取全貌。 - 统计分析:主要使用
dados/dataset/dataset.csv及dados/dataset/evidencias.csv。 - 复现分析:需要 Python 3.11+ 及
pandas、matplotlib、seaborn、numpy库。运行脚本scripts/analises/gerar_quantitativos.py等可直接生成结果。 - 验证分类:可使用
docs/codebooks/schema-codebook-final.json对分类数据进行校验。
重要局限性
- 字段覆盖不完整:部分字段如
plataforma(57%)和marcadores_brasileiros(40%)未完全填充,使用时应参考有效分母。 - 分析单元:新闻文章本身,而非选举事件,不推断AI与选举结果间的因果关系。
- 时间窗口:主要集中在2026年3月至6月(预选及TSE监管期),非涵盖整个选举周期。
- 原始PDF缺失:受版权和文件大小限制,未提供原始新闻PDF,但
.md文件已保留核心信息。