
africa-ilo-emp-temp-sex-age-geo-nb-employment-by-sex-age-and-rural-urban-areas-thousa
收藏数据链接:
官方服务:
资源简介:
本数据集名为按性别、年龄和城乡区域划分的就业人数(千人)| 非洲(ILOSTAT),是一个针对非洲地区的劳动力市场统计数据集,由Electric Sheep Africa从国际劳工组织(ILOSTAT)官方数据库重新打包发布,旨在为机器学习和研究提供标准化、可直接使用的非洲数据。数据包含36,113个观测值,覆盖47个非洲国家,时间跨度为1994年至2025年,核心指标为按性别、年龄和城乡区域划分的就业人数(以千人为单位)。数据通过ILOSTAT REST API获取,并经过国际劳工统计学家会议(ICLS)定义标准化处理,确保国际可比性。数据集采用表格形式,包含22个结构化字段,如国家代码、性别分类(总计、男性、女性)、年龄/教育分类、城乡分类、观测年份、观测数值等,适用于表格分类、回归分析和时间序列预测等机器学习任务,可用于研究非洲劳动力市场动态、就业结构变化、性别差异和城乡分布。数据为年度频率,采用CC-BY-4.0许可,使用时需引用国际劳工组织和Electric Sheep Africa。
创建时间:
2026-05-25
原始信息汇总
数据集概述
- 数据集名称: Employment by sex, age and rural / urban areas (thousands) | Africa (ILOSTAT)
- 数据集规模: 36,113 条观测数据
- 地理覆盖: 47 个非洲国家
- 时间范围: 1994–2025 年
- 指标数量: 1 个指标
- 许可证: cc-by-4.0
- 语言: 英语
数据来源
- 来源机构: 国际劳工组织 (ILO)
- 数据源名称: ILOSTAT
- 原数据链接: ILOSTAT 批量数据浏览器
- 数据收集方法: 数据从 ILOSTAT REST API 直接拉取,基于国家劳动力调查、住户收入调查、机构调查和行政记录,依据国际劳工统计学家会议(ICLS)定义进行协调。
指标说明
- 唯一指标:
EMP_TEMP_SEX_AGE_GEO_NB— 按性别、年龄和城乡区域划分的就业人数(单位:千人)
数据结构与模式
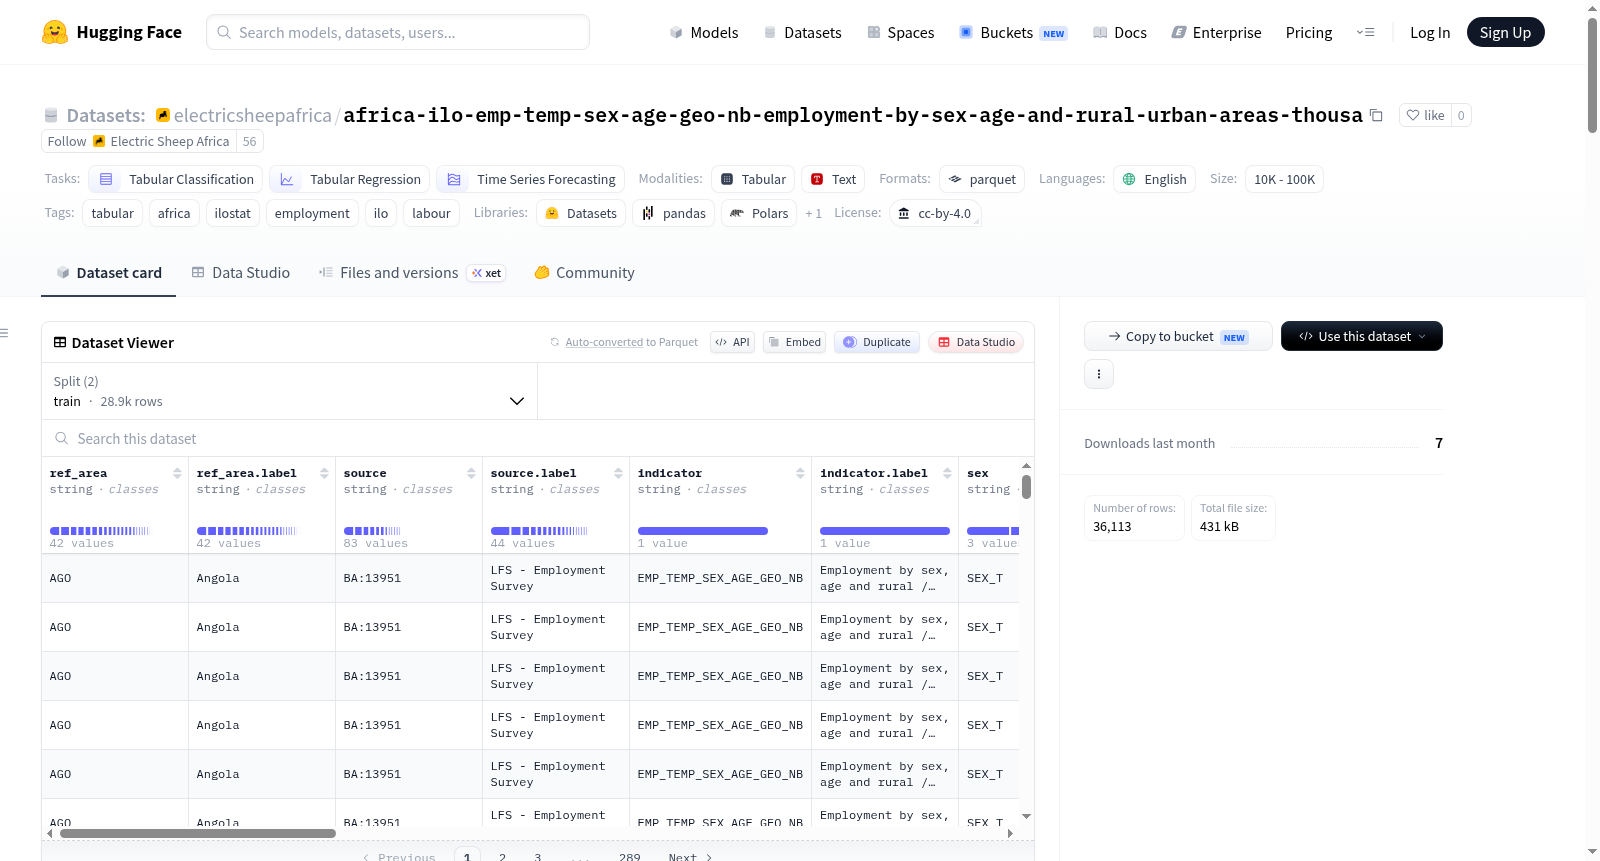
| 列名 | 类型 | 描述 | 示例 |
|---|---|---|---|
ref_area |
string | ISO 3166-1 alpha-3 国家代码 | AGO |
ref_area.label |
string | 英文国家名称 | Angola |
source |
string | ILOSTAT 来源代码 | BA:13951 |
source.label |
string | 来源英文名称 | LFS - Employment Survey |
indicator |
string | ILOSTAT 指标代码 | EMP_TEMP_SEX_AGE_GEO_NB |
indicator.label |
string | 指标英文名称 | Employment by sex, age and rural / ur… |
sex |
string | 性别分类 | SEX_T |
sex.label |
string | — | Total |
classif1 |
string | 第一分类变量(如年龄、教育等) | AGE_YTHADULT_YGE15 |
classif1.label |
string | — | Age (Youth, adults): 15+ |
classif2 |
string | 第二分类变量 | GEO_COV_NAT |
classif2.label |
string | — | Area type: National |
time |
int64 | 观测年份 | 2025 |
obs_value |
float64 | 观测指标值 | 13984.984 |
obs_status |
string | 观测状态标志 | U |
obs_status.label |
string | — | Unreliable |
note_classif |
string | — | C6:1058 |
note_classif.label |
string | — | Nonstandard age group: Excluding age 15 |
note_indicator |
string | — | I11:264 |
note_indicator.label |
string | — | Break in series: Methodology revised |
note_source |
string | — | R1:3513 |
note_source.label |
string | — | Repository: ILO-STATISTICS - Micro da… |
分类维度
- 性别 (sex): 3 个唯一值 —
SEX_T(总计)、SEX_M(男性)、SEX_F(女性)
主要国家覆盖(按行数排序)
| 国家 | 行数 | 起始年份 | 结束年份 |
|---|---|---|---|
| 南非 (ZAF) | 2,496 | 2008 | 2024 |
| 埃及 (EGY) | 2,448 | 2008 | 2024 |
| 突尼斯 (TUN) | 2,304 | 2006 | 2023 |
| 安哥拉 (AGO) | 1,622 | 2004 | 2025 |
| 马里 (MLI) | 1,593 | 2007 | 2024 |
| 卢旺达 (RWA) | 1,458 | 2002 | 2025 |
| 加纳 (GHA) | 1,440 | 2000 | 2024 |
| 赞比亚 (ZMB) | 1,347 | 2008 | 2024 |
| 坦桑尼亚 (TZA) | 1,170 | 2001 | 2020 |
| 塞内加尔 (SEN) | 1,152 | 2011 | 2024 |
| 乌干达 (UGA) | 1,032 | 2002 | 2021 |
| 津巴布韦 (ZWE) | 1,017 | 2004 | 2024 |
| 纳米比亚 (NAM) | 1,008 | 1994 | 2018 |
| 尼日利亚 (NGA) | 1,008 | 2011 | 2024 |
| 布基纳法索 (BFA) | 888 | 1994 | 2024 |
数据质量与注意事项
- 数据为年度频率,不包含月度或季度序列。
- 对于同一国家×年份存在多个来源时,采用 ILO 选择的“最佳来源”。
- 分类列(sex、classif1、classif2)仅在指标发布该分类时非空。
搜集汇总
数据集介绍
构建方式
该数据集基于国际劳工组织(ILO)的ILOSTAT核心统计数据库构建,通过REST API接口直接提取指标代码为EMP_TEMP_SEX_AGE_GEO_NB的数据,并依据非洲ISO3国家代码进行地理范围过滤。ILOSTAT本身通过整合各国劳动力调查、家庭收支调查、机构调查及行政记录等原始微观数据,并采用国际劳工统计学家会议(ICLS)定义进行标准化处理,确保跨国家、跨年份的数据可比性。数据集中每一条观测均附带source.label字段,以追溯具体的数据来源。
使用方法
用户可通过HuggingFace Datasets库的load_dataset函数一键加载该数据集,并轻松转换为Pandas DataFrame进行后续分析。支持按国家代码筛选特定国家的子集,或基于时间列进行单指标的时间序列分析与可视化。用户还可利用pivot_table等方法将数据重塑为国家×年份的矩阵形式,便于进行跨国的横向对比研究。该数据集直接兼容tabular-classification、tabular-regression及time-series-forecasting等多种机器学习与统计分析任务。
背景与挑战
背景概述
非洲大陆长期面临劳动力数据碎片化与统计口径不一致的困境,严重制约了区域劳动力市场政策制定与可持续发展目标(SDGs)的监测。在此背景下,国际劳工组织(ILO)于2025年通过其核心统计数据库ILOSTAT发布了涵盖47个非洲国家、1994至2025年间的就业数据集,并由Electric Sheep Africa进行标准化重包装。该数据集包含36113条观测记录,核心指标为按性别、年龄与城乡划分的就业人数,旨在为非洲劳动力市场提供统一的、机器学习友好的结构化数据基础。其影响力体现在填补了非洲区域高分辨率劳动统计的空白,为面板数据分析、时序预测及社会政策评估提供了可靠的数据源。
当前挑战
该数据集所面临的挑战首先来自于领域问题的复杂性:非洲劳动力市场存在大量非正规就业和统计缺失,不同国家间调查标准、年龄分组与城乡定义差异显著,且部分来源标注为‘不可靠’或存在方法修订导致的序列断裂,直接影响模型在时间序列预测与分类任务中的泛化能力。其次,在数据集构建过程中,ILOSTAT需对来自多个国家的劳动调查、行政记录等异构数据源进行国际劳工统计学家会议(ICLS)定义下的统一协调,并筛选同一国家—年份组合下的‘最佳来源’,这一过程不可避免地引入样本选择偏差与口径变动带来的系统性误差。此外,部分国家数据覆盖稀疏,如纳米比亚仅覆盖至2018年,限制了跨时期与跨国家比较的稳健性。
常用场景
经典使用场景
该数据集汇集了国际劳工组织ILOSTAT数据库中非洲47国1994年至2025年间按性别、年龄及城乡地域划分的就业人数统计数据,共计36,113条观测记录。在劳动经济学与区域发展研究领域,研究者常将其用于构建面板数据模型,剖析非洲大陆异质性劳动力市场的时空演变规律。其经典应用包括基于时间序列的就业趋势预测、性别与地域维度的就业差异分解分析,以及用于训练机器学习模型以估算缺失年份的就业数据,从而弥补非洲国家统计体系的不完整性。
解决学术问题
该数据集有效回应了非洲劳动经济学研究中长期面临的数据碎片化与可比性不足的难题。它使得学者能够系统性地探究性别就业差距在城乡间的动态变化、人口年龄结构转型对劳动力参与率的影响,以及宏观经济政策冲击在不同地域的传导效应。通过提供标准化的分类体系与可靠的时间序列,数据集为验证关于非洲劳动力市场双元结构、女性劳动参与率上升趋势等理论假说提供了实证基础,显著推动了区域劳动经济学的发展。
实际应用
在实际政策与商业场景中,该数据集是国际发展机构与非洲各国统计局制定就业促进战略的核心依据。基于不同性别与城乡维度的就业模式分析,决策者可精准识别弱势群体,设计针对性技能培训与就业帮扶项目。跨国企业与投资咨询公司则利用该数据评估非洲各国劳动力禀赋,优化产业布局与用工策略。同时,非政府组织可据此监测可持续发展目标中体面工作指标的进展,评估减贫与城镇化政策的实际效力。
数据集最近研究
最新研究方向
当前,该数据集的前沿研究方向聚焦于利用长时序面板数据(1994–2025年)解析非洲劳动力市场的结构性变迁,尤其是性别、年龄与城乡维度的交叉效应。在“体面劳动”与可持续发展目标(SDG 8)的全球议程推动下,研究者借助ILOSTAT的标准化指标,量化非正规就业转型、青年失业危机及女性劳动参与率的地域异质性。该数据的深度涉猎也支撑着基于机器学习的就业预测模型,通过时空分层与缺失值补全技术,铺就非洲劳动经济学的实证创新之路。
以上内容由遇见数据集搜集并总结生成


