indro-3B-corpus
收藏资源简介:
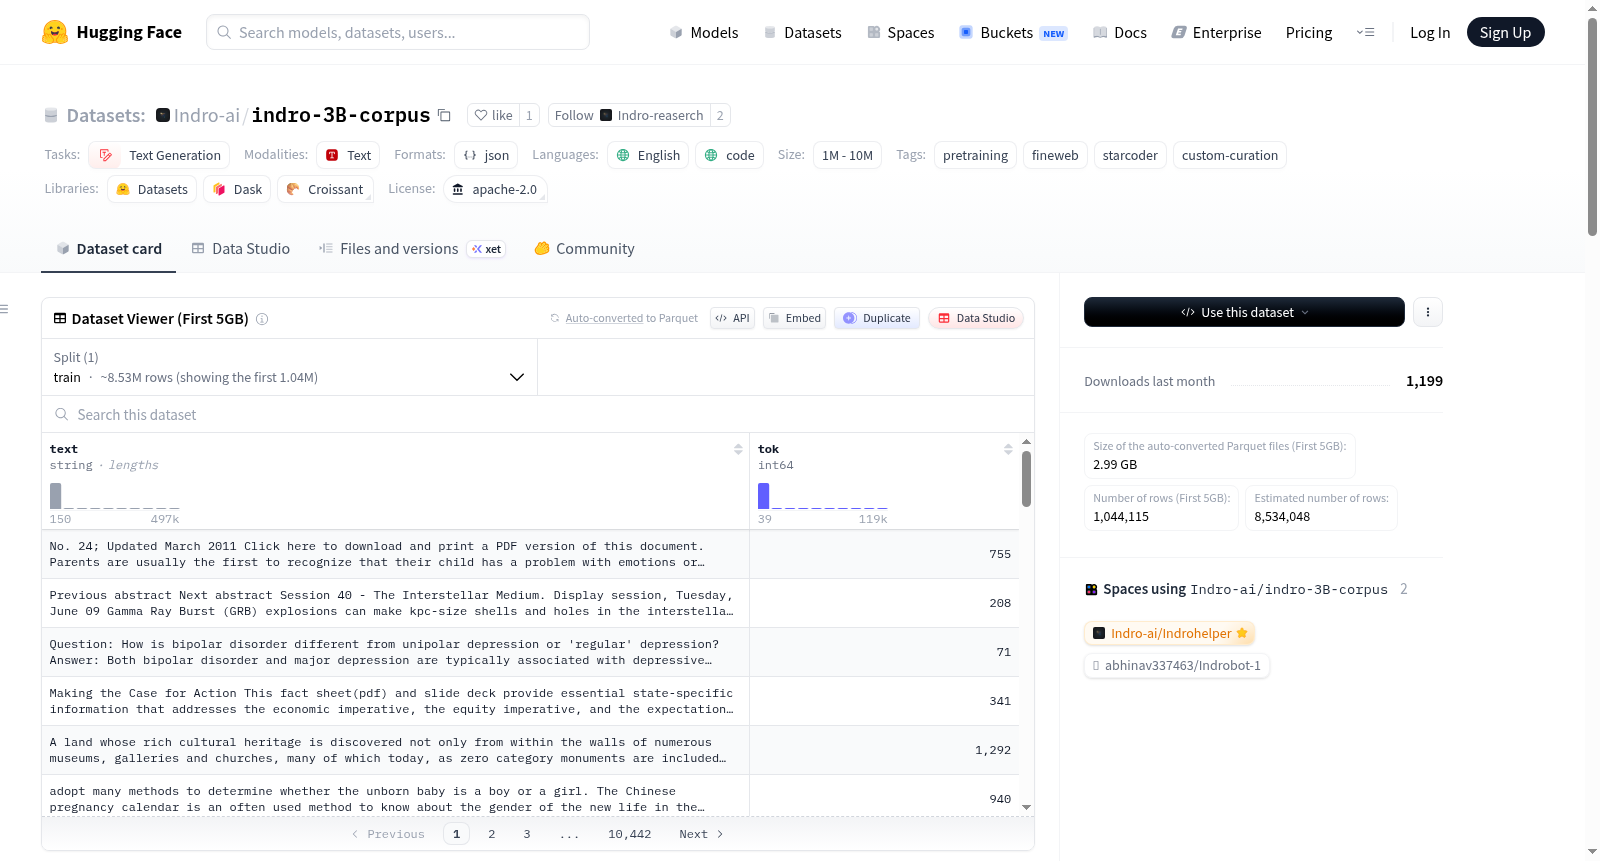
Indro-3B-Corpus 是一个经过高度筛选、去重和数学验证的数据集,专为训练30亿参数的大型语言模型而设计。该数据集由 Indro AI 构建和维护,旨在从互联网中提取最高质量的标记数据。数据集分为两个主要部分:Silver Data(文本/世界知识)和 StarCoder Clean(逻辑推理/代码)。Silver Data 来源于 FineWeb-Edu,目标标记为390亿,专注于学术、教育和高价值信息文本。StarCoder Clean 来源于 StarCoderData(Python 子集),目标标记为120亿,专注于纯可编译代码,并通过 AST 语法验证确保代码可执行。数据集采用 Zstandard 压缩的 JSON 行格式(.jsonl.zst),语言主要为英语和编程语言(主要是 Python)。数据集处理使用了先进的分布式检查点系统、加密去重技术和异步 I/O 管道,确保数据的高效性和完整性。
Indro-3B-Corpus 数据集概述
基本信息
- 数据集名称: Indro-3B-Corpus
- 维护者: Indro AI
- 语言: 英语、代码
- 许可证: Apache-2.0
- 规模类别: 10B<n<100B
- 任务类别: 文本生成
- 标签: 预训练、fineweb、starcoder、自定义精选
数据集概览
- 总目标规模: 约510亿个词元
- 格式:
.jsonl.zst(采用Zstandard压缩的JSON行格式,以实现极高的I/O速度) - 主要语言: 英语和编程语言(主要为Python)
- 设计目的: 用于训练一个30亿参数的大型语言模型,是一个经过超精选、去重和数学验证的数据集。
子数据集构成
数据集包含两个主要数据流,经过精心筛选以平衡高级推理(代码)和深度世界知识(网络文本)。
1. Silver Data(文本/世界知识)
- 来源: FineWeb-Edu
- 目标词元: 390亿个
- 处理引擎: Titan v12.0 (The Singularity)
- 精选重点: 学术、教育和高价值信息文本。SEO垃圾、微型存根和重复网页被数学化地清除。
2. StarCoder Clean(逻辑推理/代码)
- 来源: StarCoderData(Python子集)
- 目标词元: 120亿个
- 处理引擎: CodeForge v3.0 (The Apex)
- 精选重点: 纯粹、可编译的代码。移除自动生成的样板文件、冗长的许可证,并运行AST语法验证,以确保模型仅从实际可执行的代码中学习。
数据处理架构 (Indro-Nexus Architecture)
数据集采用定制的高级摄取脚本进行处理,主要特性包括:
- 持久化状态同步: 分布式检查点系统,将本地处理与云端
master_ledger.json关联。如果服务器崩溃或重启,引擎会从精确的行恢复,不丢失任何词元。 - 加密去重: 使用MinHash LSH(局部敏感哈希)和超严格的可扩展布隆过滤器进行双层防御,确保零数据泄漏,防止AI记忆重复文本。
- AST语法剪裁: (CodeForge专用)每个Python脚本都通过抽象语法树解析器。如果代码损坏或包含致命语法错误,则会被完全丢弃。
- 异步I/O流水线: 多线程流式处理允许引擎同时下载、解压、清理、重新压缩(ZSTD级别3)和上传250MB的数据分片,无I/O瓶颈。
使用方法
由于数据使用Zstandard高度压缩,可以直接以最小的RAM占用将其流式传输到分词器或训练循环中。
python from datasets import load_dataset
加载教育文本数据
text_data = load_dataset("Indro-ai/Indro-3B-Corpus", data_dir="silver_data", split="train", streaming=True)
加载已验证的代码数据
code_data = load_dataset("Indro-ai/Indro-3B-Corpus", data_dir="starcoder_clean", split="train", streaming=True)
示例迭代
for item in text_data: print(item["text"]) # 注意:词元数量已预先计算,以在流式传输时节省CPU! print(f"Token Count: {item[tok]}") break