
遇见数据集

DykeF/NCTCRCHE100K

收藏
Hugging Face2023-10-04 更新2024-03-04 收录
官方服务:

资源简介:

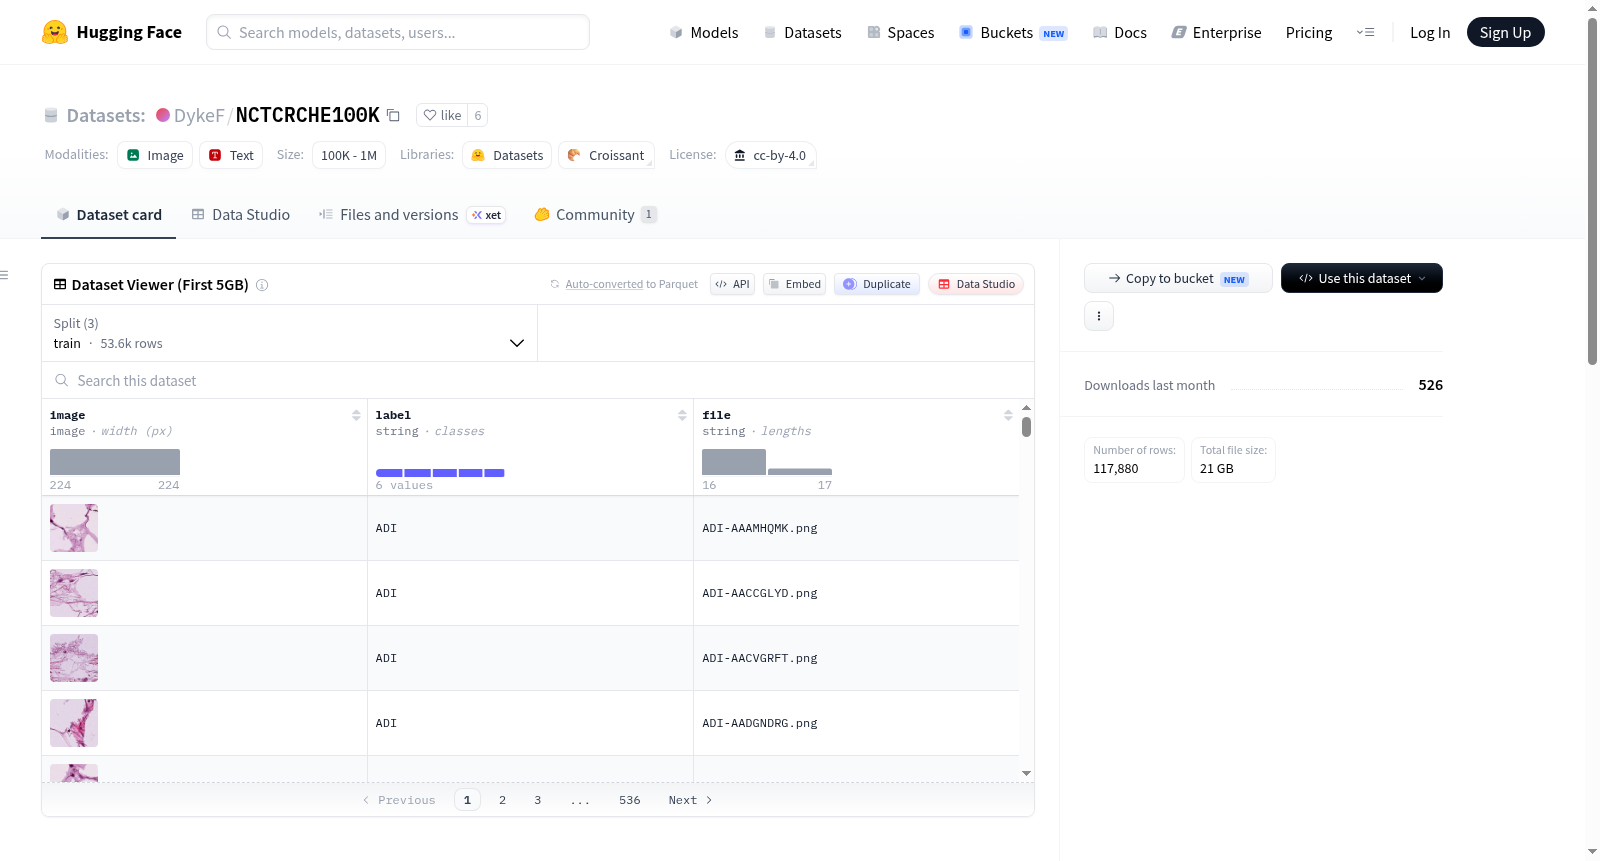
这是一个包含100,000个非重叠图像块的数据集,这些图像块来自人类结直肠癌和正常组织的H&E染色组织学图像。所有图像均为224x224像素,每个像素代表0.5微米,并使用了Macenko方法进行颜色归一化。组织类别包括:脂肪组织(ADI)、背景(BACK)、碎片(DEB)、淋巴细胞(LYM)、粘液(MUC)、平滑肌(MUS)、正常结肠粘膜(NORM)、癌症相关基质(STR)、结直肠腺癌上皮(TUM)。这些图像是从N=86个H&E染色的人类癌症组织切片中手动提取的,这些切片来自NCT生物库(德国海德堡国家肿瘤疾病中心)和UMM病理档案(德国曼海姆大学医学中心)。组织样本包括CRC原发肿瘤切片和CRC肝转移肿瘤组织;正常组织类别通过增加非肿瘤区域的胃切除标本以增加变异性。数据集分为训练集(100,000个“train”和100,000个“train_nonorm”样本)以及验证集(7,180个样本)。

This is a dataset comprising 100,000 non-overlapping image patches derived from H&E-stained histology images of human colorectal cancer and normal tissues. All images are sized at 224×224 pixels, with each pixel corresponding to 0.5 micrometers, and color normalization was performed using the Macenko method. The tissue categories are as follows: adipose tissue (ADI), background (BACK), debris (DEB), lymphocytes (LYM), mucus (MUC), smooth muscle (MUS), normal colonic mucosa (NORM), cancer-associated stroma (STR), and colorectal adenocarcinoma epithelium (TUM). These patches were manually extracted from 86 H&E-stained human cancer tissue sections sourced from the NCT Biobank (National Center for Tumor Diseases, Heidelberg, Germany) and the UMM Pathology Archives (University Medical Center Mannheim, Germany). Tissue samples include CRC primary tumor sections and CRC liver metastatic tumor tissues; the normal tissue category was augmented with non-tumor regions from gastrectomy specimens to increase variability. The dataset is split into a training set (100,000 "train" samples and 100,000 "train_nonorm" samples) and a validation set (7,180 samples).

提供机构:
DykeF
原始信息汇总

NCTCRCHE100K 数据集卡片

描述

这是一个包含100,000张非重叠的从人源结直肠癌(CRC)和正常组织中提取的苏木精和伊红(H&E)染色组织学图像的集合。所有图像的尺寸为224x224像素,分辨率为0.5微米每像素(MPP)。所有图像均使用Macenko方法进行颜色归一化。

组织类别包括:脂肪(ADI)、背景(BACK)、碎片(DEB)、淋巴细胞(LYM)、粘液(MUC)、平滑肌(MUS)、正常结肠粘膜(NORM)、癌相关基质(STR)、结直肠腺癌上皮(TUM)。

这些图像是从N=86张H&E染色的人源癌症组织切片中手动提取的,这些切片来自甲醛固定石蜡包埋(FFPE)样本,来自NCT生物库(国家肿瘤疾病中心,海德堡,德国)和UMM病理档案(曼海姆大学医学中心,曼海姆,德国)。组织样本包含CRC原发性肿瘤切片和来自CRC肝转移的肿瘤组织;正常组织类别通过增加来自胃切除标本的非肿瘤区域来增加变异性。

数据结构

数据集分为训练集(100,000个“train”和100,000个“train_nonorm”样本)以及7180个样本的验证集。
搜集汇总
数据集介绍
DykeF/NCTCRCHE100K 数据集图片
构建方式
在计算病理学领域,高质量标注的组织病理学图像数据集对于推动结直肠癌的自动诊断研究至关重要。NCTCRCHE100K数据集源自NCT生物样本库与UMM病理学档案,从86张福尔马林固定石蜡包埋的人类结直肠癌及正常组织苏木精-伊红染色切片中,手动提取了100,000张无重叠的图像块。每张图像尺寸为224×224像素,分辨率达0.5微米每像素。为消除染色差异带来的偏差,所有图像均采用Macenko方法进行颜色归一化处理。数据集的构建涵盖了脂肪、背景、碎片、淋巴细胞、黏液、平滑肌、正常结肠黏膜、癌相关间质及结直肠腺癌上皮等九种组织类别,并纳入胃癌切除术标本中的非肿瘤区域以增强正常组织的多样性。
特点
该数据集的核心特点在于其规模与精细的类别划分。100,000张图像块提供了充足的训练样本,支持深度学习模型对结直肠癌组织病理学特征的稳健学习。九种组织类别的标注覆盖了结直肠癌微环境中的关键成分,从正常结构到肿瘤上皮及间质反应,为多分类任务奠定了坚实基础。此外,数据集提供了包含颜色归一化(train)与未归一化(train_nonorm)两种训练子集,便于研究者评估染色标准化对模型性能的影响。验证集包含7,180个样本,确保了模型评估的可靠性。这种设计兼顾了数据质量与实验灵活性,使研究者能够深入探索组织形态学差异。
使用方法
使用NCTCRCHE100K数据集时,研究者可通过HuggingFace的datasets库便捷加载。推荐采用PyTorch的DataLoader进行数据管道构建,首先利用ToTensor转换将图像转化为张量格式,再通过set_transform方法应用于数据集。例如,从训练集加载图像时,可指定split参数为'train'、'train_nonorm'或'validation',以适应不同实验需求。该数据集适用于图像分类任务,特别是结直肠癌组织类型的自动识别。研究者可基于此开发卷积神经网络或Transformer架构的模型,并通过交叉验证优化超参数。加载后的数据可直接用于训练循环,简化了从数据预处理到模型迭代的工作流程。
背景与挑战
背景概述
在计算病理学领域,组织病理学图像的自动分析对于癌症诊断与预后评估具有深远意义。结直肠癌作为全球高发恶性肿瘤,其组织病理学亚型的精准识别是临床决策的关键环节。2018年,由德国国家肿瘤疾病中心与曼海姆大学医学中心的研究团队,包括Jakob Nikolas Kather等学者,发布了NCTCRCHE100K数据集。该数据集包含10万张来自86例结直肠癌患者苏木精-伊红染色组织切片的非重叠图像块,涵盖脂肪、淋巴、肿瘤上皮等九类组织,图像经颜色归一化处理以确保一致性。这一大规模标注资源为深度学习模型在组织病理学分类任务中的训练与验证提供了坚实基础,显著推动了计算病理学在肿瘤微环境解析与自动化诊断中的发展。
当前挑战
该数据集所解决的领域核心挑战在于实现结直肠癌组织病理学图像的高精度多分类,以辅助临床病理学家从复杂组织形态中区分正常与癌变区域。在构建过程中,研究人员面临多重困难:首先,从福尔马林固定石蜡包埋样本中手动提取86例患者的组织切片,需确保肿瘤样本与正常组织(如胃切除标本)的多样性,避免类别不平衡;其次,图像块需在0.5微米每像素分辨率下切割为224×224像素的非重叠区域,并应用Macenko方法进行颜色归一化,以消除染色差异带来的噪声;此外,确保10万张图像块的标注质量,需依赖病理学专家的精细判别,尤其在区分癌相关间质与正常粘膜等易混淆类别时,标注一致性成为关键瓶颈。
常用场景
经典使用场景
NCTCRCHE100K数据集作为计算病理学领域的标志性资源,其经典使用场景聚焦于组织病理学图像的自动分类与分割任务。该数据集包含10万张来自结直肠癌及正常组织的H&E染色图像块,涵盖脂肪、淋巴细胞、肿瘤上皮等九类精细组织类别,为监督学习模型提供了大规模、标准化且经过颜色归一化的训练素材。研究者常利用该数据集训练卷积神经网络(如ResNet、EfficientNet)以区分癌性与非癌性组织,或作为基准测试平台评估不同架构在组织病理学多分类任务中的泛化能力。其224×224像素的标准化尺寸与0.5微米/像素的分辨率,确保了跨实验的可重复性与公平比较。
解决学术问题
该数据集有效解决了结直肠癌组织病理学分析中两大核心学术难题:一是缺乏大规模、高质量且类别均衡的标注图像数据,二是传统人工阅片在肿瘤微环境评估中的主观性与低通量问题。通过提供涵盖九种组织类别的10万张标注图像,NCTCRCHE100K使研究者能够训练出高精度的深度学习模型,自动识别肿瘤上皮、癌相关间质及免疫细胞浸润等关键病理特征。这不仅推动了全切片图像(WSI)的自动化分析算法发展,还为探索肿瘤异质性、微环境免疫状态与预后关联提供了量化工具,显著提升了计算病理学研究的可重复性与统计效力。
衍生相关工作
NCTCRCHE100K数据集衍生了一系列推动计算病理学发展的经典工作。最显著的是,它作为基础训练集催生了多种弱监督学习框架,如CLAM和ABMIL,这些方法利用注意力机制从全切片图像中学习关键区域特征,实现了无需精细标注的肿瘤分级与生存预测。此外,该数据集还被用于预训练领域自适应的病理图像基础模型(如CTransPath和Phikon),通过大规模对比学习提取通用组织形态学表征,显著降低了下游任务(如肺癌亚型分类、胃癌微卫星不稳定性检测)对标注数据的依赖。这些衍生工作共同构建了从图像块到全切片的多尺度分析范式,深刻影响了数字病理学的技术演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

