
electricsheepasia/asia-ilo-how-xees-age-ec2-nb-mean-weekly-hours-actually-worked-per-employee-by
收藏数据链接:
官方服务:
资源简介:
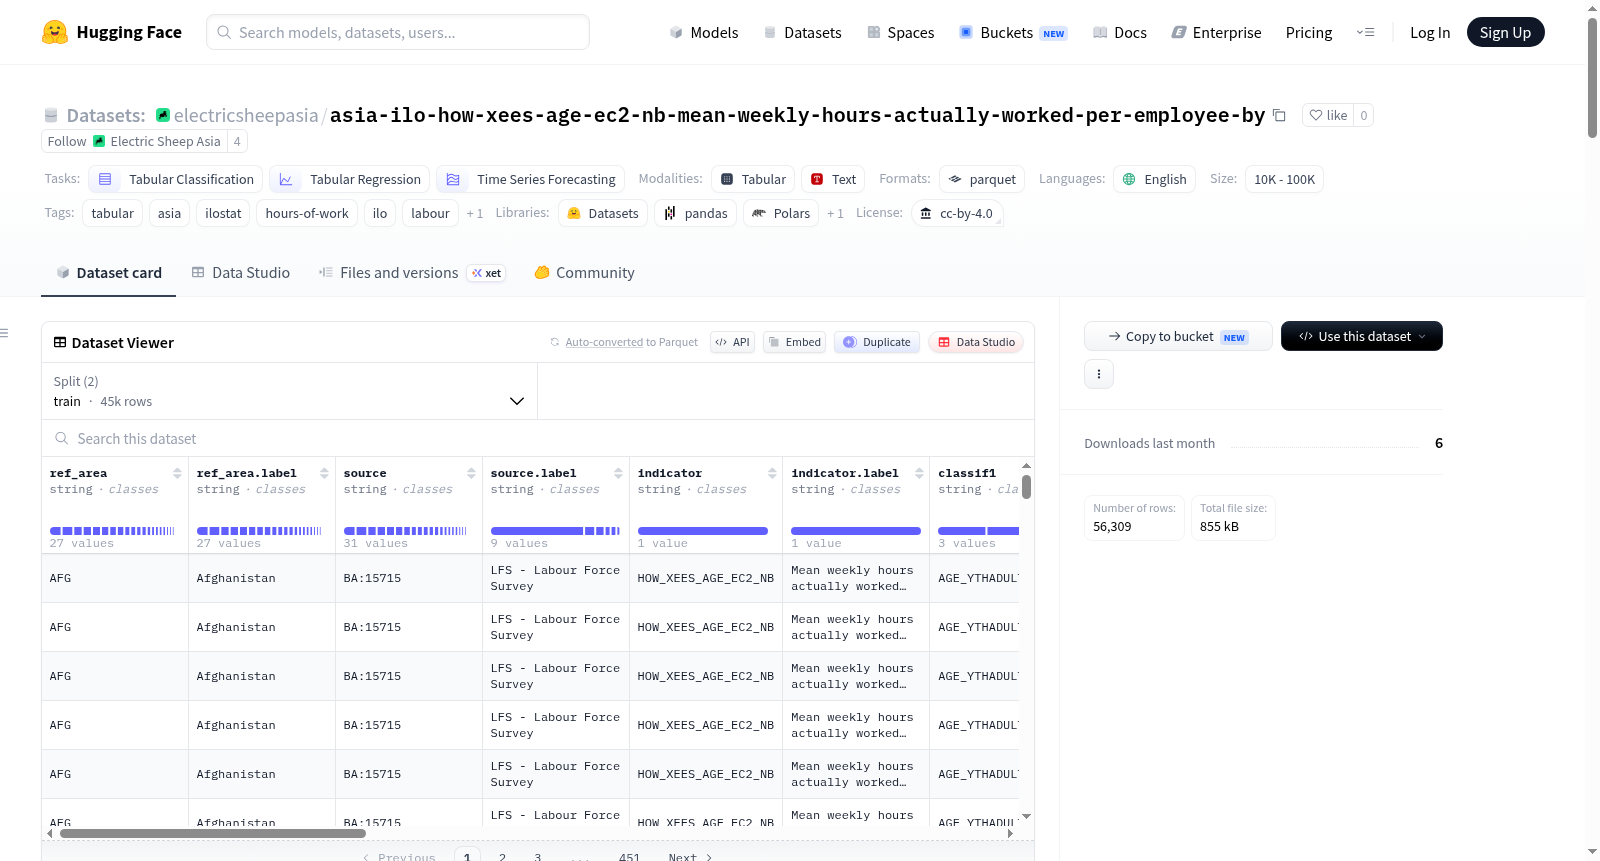
该数据集包含亚洲32个国家1997年至2025年间员工实际每周平均工作小时数的56,309个观测值,具体指标为HOW_XEES_AGE_EC2_NB(按年龄和经济活动划分的员工实际每周平均工作小时数,使用ISIC 2级经济活动分类)。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,涵盖年龄和经济活动的细分分类,并包括国家、数据来源、时间、观测值状态等详细信息。
This dataset contains 56,309 observations of mean weekly hours actually worked per employee across 32 Asia countries from 1997 to 2025, with the indicator HOW_XEES_AGE_EC2_NB (Mean weekly hours actually worked per employee by age and economic activity - ISIC level 2). Data is sourced from the International Labour Organizations ILOSTAT database, including breakdowns by age and economic activity, and details on country, source, time, observation status, and more.
提供机构:
electricsheepasia搜集汇总
数据集介绍
构建方式
本数据集源自国际劳工组织(ILO)的ILOSTAT核心统计数据库,其构建过程严谨而系统。数据通过ILOSTAT提供的REST API直接从官方接口获取,并依据国际劳工统计学家会议(ICLS)的定义对原始调查微观数据进行统一协调。为聚焦亚洲区域,数据集进一步依据ISO 3166-1 alpha-3国家代码筛选出32个亚洲国家的观测值。最终,该数据集由Electric Sheep Asia团队进行重新封装与标准化处理,形成了包含56,309条记录的整洁数据集,涵盖1997年至2025年间的年度工时数据。
特点
该数据集的核心特点在于其精细的多维分类结构与权威的数据溯源能力。它不仅提供了‘雇员实际周平均工时’这一核心指标,还通过‘年龄’和‘经济活动(ISIC第二级)’两个分类维度进行了深入拆分,使得研究人员能够进行交叉分析。此外,每个观测值都附带了数据来源(如劳动力调查)、观测状态标志以及详尽的注释信息(如系列中断、方法论修订),极大地增强了数据的透明度和可靠性,为精确的劳动经济学研究提供了坚实基础。
使用方法
数据集的调用极为便捷,用户可通过Hugging Face的`datasets`库一行代码加载:`load_dataset('electricsheepasia/asia-ilo-how-xees-age-ec2-nb-mean-weekly-hours-actually-worked-per-employee-by')`,并直接转换为Pandas DataFrame进行深入分析。用户可轻松按国家代码(如`ref_area == 'IDN'`)筛选特定国家数据,或针对单一指标按时间序列进行排序与可视化。同时,通过数据透视表功能,可快速构建以年份为行、国家为列的矩阵,便于进行跨国比较与面板数据分析。
背景与挑战
背景概述
该数据集由国际劳工组织(ILO)统计部门创建,并由Electric Sheep Asia于2025年重新整理发布,聚焦于亚洲32个国家1997至2025年间不同年龄及经济活动类别下雇员实际每周平均工作小时数。基于ILOSTAT这一全球劳动统计权威数据库,数据集整合了各国劳动力调查、家庭收支调查及行政记录等多种来源的微观数据,经国际劳工统计学家会议(ICLS)定义统一标准化处理。作为亚洲区域首个大规模、细粒度的工作时间面板数据,它系统揭示了亚洲劳动力市场中年龄结构、产业类型与工作时长之间的复杂关系,为劳动经济学、发展经济学及区域比较研究提供了关键量化基础,尤其弥补了亚洲发展中经济体劳动时间微观证据的不足。
当前挑战
数据集面临的核心挑战在于长期跨国的数据可比性与质量控制。一方面,亚洲各国经济发展水平悬殊,统计基础设施与定义规范差异巨大,加之部分观测被标记为“不可靠”(obs_status=U),使得跨国家、跨时期的工作时间比较分析充满偏差风险。另一方面,构建过程中需应对多来源数据整合困难,不同调查样本框架和“最优来源”选取规则可能引入非随机缺失,同时年度频率无法捕捉季节性波动,而方法修订造成的断点(如note_indicator中标识的断点)更使时间序列分析雪上加霜。此外,分类变量(如年龄、经济活动)的缺失和粒度不一致性也制约了多维度建模的精度。
常用场景
经典使用场景
在劳动经济学与区域发展研究领域,该数据集被广泛用于分析亚洲各国雇员的周均实际工作时长,揭示不同年龄段及经济活动类别下的劳动供给特征。研究者可利用其丰富的分类变量,如年龄组别与ISIC二级行业代码,构建面板数据模型,深入探讨亚洲地区劳动力市场的结构性变化、人口转型对工作时长的影响,以及经济周期中工时调整的异质性模式。
实际应用
在实际应用中,该数据集助力国际组织与各国劳动部门进行政策模拟与监测,例如评估最低工资政策对工时的实际影响、预测自动化替代效应下不同职业群体的劳动强度变化。企业雇主可借助其洞察区域劳动市场供需动态,优化跨国人力资源配置;公众健康研究亦可利用工时数据探讨过长劳动时间与职业安全、心理健康之间的关联。
衍生相关工作
基于该数据集,衍生出多项标志性工作,包括构建亚洲国家工时收敛性检验的面板单位根模型、开发多维度劳动供给弹性估计的计量框架,以及将ILO工时指标融入生活质量跨国民调的综合指数。此外,数据已被用于训练预测劳动参与率的机器学习模型,并与企业生产率面板数据联合,揭示工时与产出的非线性关系,显著丰富了计算社会科学与劳动法交叉研究的工具箱。
以上内容由遇见数据集搜集并总结生成


