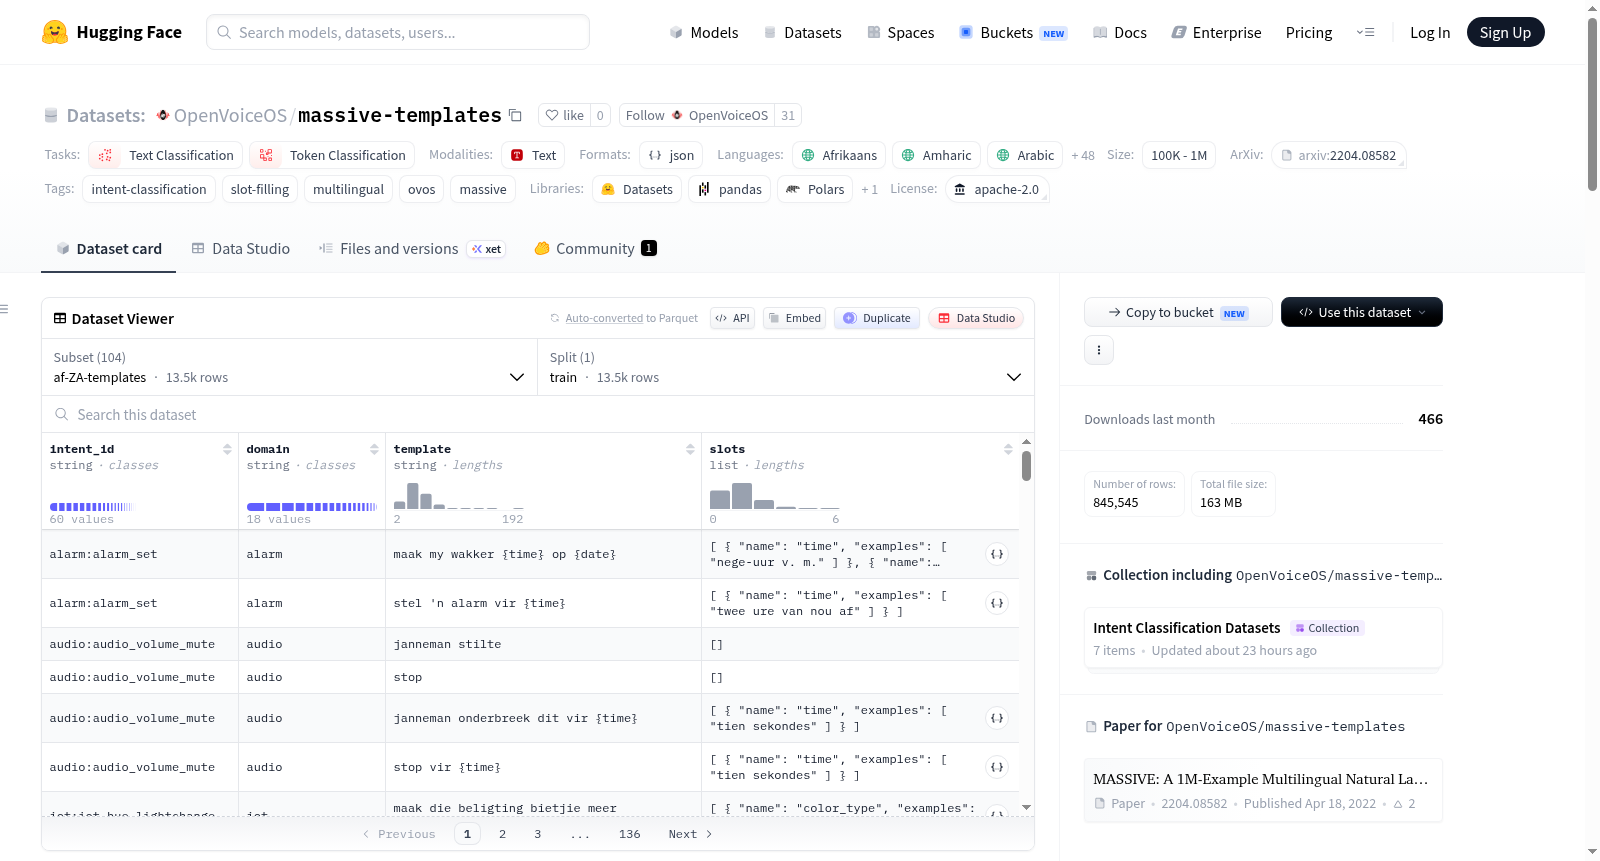
OpenVoiceOS/massive-templates
收藏资源简介:
MASSIVE Templates数据集是AmazonScience/massive数据集的机械转换版本,格式与OpenVoiceOS/intents-for-eval数据集兼容。该转换通过单一正则表达式处理MASSIVE的annot_utt字段,将每个话语转换为一个训练行,包含带槽位占位符(如{slot})的模板以及仅从该话语中提取的槽位示例列表。数据集涵盖52种语言/地区(包括英语、中文、西班牙语等),训练集每语言约13,500行(总计约704,000行),测试集每语言2,974行(总计约155,000行)。数据用于意图分类和槽位填充任务,支持多语言自然语言理解研究。数据集采用Apache-2.0许可证,转换工具和加载方法在OpenVoiceOS/ovos-intent-benchmark仓库中提供。
MASSIVE Templates is a mechanical re-cast of the AmazonScience/massive dataset into the same row shape as OpenVoiceOS/intents-for-eval. The conversion uses a single regex pass over MASSIVEs annot_utt field to transform each utterance into a training row with a bracket template (containing {slot} placeholders) and a list of slot examples drawn only from that single utterance. The dataset covers 52 BCP-47 locales (including English, Chinese, Spanish, etc.), with approximately 13.5k train rows per locale (~704k total) and 2,974 test rows per locale (~155k total). It is designed for intent classification and slot-filling tasks, supporting multilingual natural language understanding research. The dataset is licensed under Apache-2.0, and conversion tools and loading methods are available in the OpenVoiceOS/ovos-intent-benchmark repository.
数据集概述:OpenVoiceOS/massive-templates
- 任务类型: 文本分类、Token 分类。
- 数据模态: 纯文本。
- 数据格式: JSON (具体为 JSON Lines 格式)。
- 数据集规模: 总计约 100K - 1M 条样本。
- 语言: 覆盖 52 个 BCP-47 区域设置(包括南非荷兰语、阿姆哈拉语、阿拉伯语等 48 种以上语言)。
- 标签: 意图分类 (intent-classification), 槽位填充 (slot-filling), 多语言 (multilingual), OVOS, MASSIVE。
- 许可证: Apache-2.0。
- 相关论文: arXiv: 2204.08582 (MASSIVE 论文)。
数据集来源与目的
该数据集是 AmazonScience/massive 数据集的一个机械重构版本,旨在与 OpenVoiceOS/intents-for-eval 数据集的行格式保持一致。其核心目的是用于 意图解析器的基准测试,以评估 OVOS 意图插件的泛化能力,而非记忆能力。
数据分割与构成
- 训练集: 每个区域设置约 13,500 行(由原始训练集和开发集合并而成),总计约 704,000 条。
- 测试集: 每个区域设置 2,974 行,总计约 155,000 条。
- 子集: 每个语言区域都包含
-templates和-test两个子集。训练数据中仅包含train分片。
数据转换方法
转换过程未使用任何大语言模型,仅通过一个正则表达式从 MASSIVE 数据集的 annot_utt 字段中提取信息:
- 模板 (Template): 将原始标注中的
[slot : value]替换为{slot}占位符得到。 - 槽位 (Slots): 每个槽位的
examples列表仅包含该条具体语句中的值,不会跨语句聚合。
数据示例 (训练集行结构)
一个典型的数据行包含以下字段:
intent_id: 意图标识符 (如alarm:alarm_set)。domain: 领域 (如alarm)。template: 带槽位占位符的模板 (如wake me up at {time} on {date})。slots: 槽位列表,每个槽位包含name和examples字段。
文件布局
<locale>/train_templates.jsonl: 训练数据。<locale>/test.jsonl: 测试数据。- 不包含
train_keywords.jsonl文件。
加载方式
-
通过 OVOS 基准测试加载器: python from benchmark.datasets import get ds = get("massive_templates") train, test = ds.load("en-US")
-
直接通过
datasets库加载: python from datasets import load_dataset templates = load_dataset("OpenVoiceOS/massive-templates", "en-US-templates", split="train") test = load_dataset("OpenVoiceOS/massive-templates", "en-US-test", split="test")
许可证与引用
- 许可证: Apache-2.0 (继承自 MASSIVE 数据集)。
- 引用: 使用该数据集时,请引用原始的 MASSIVE 论文 (arXiv: 2204.08582)。