Qev-train
收藏资源简介:
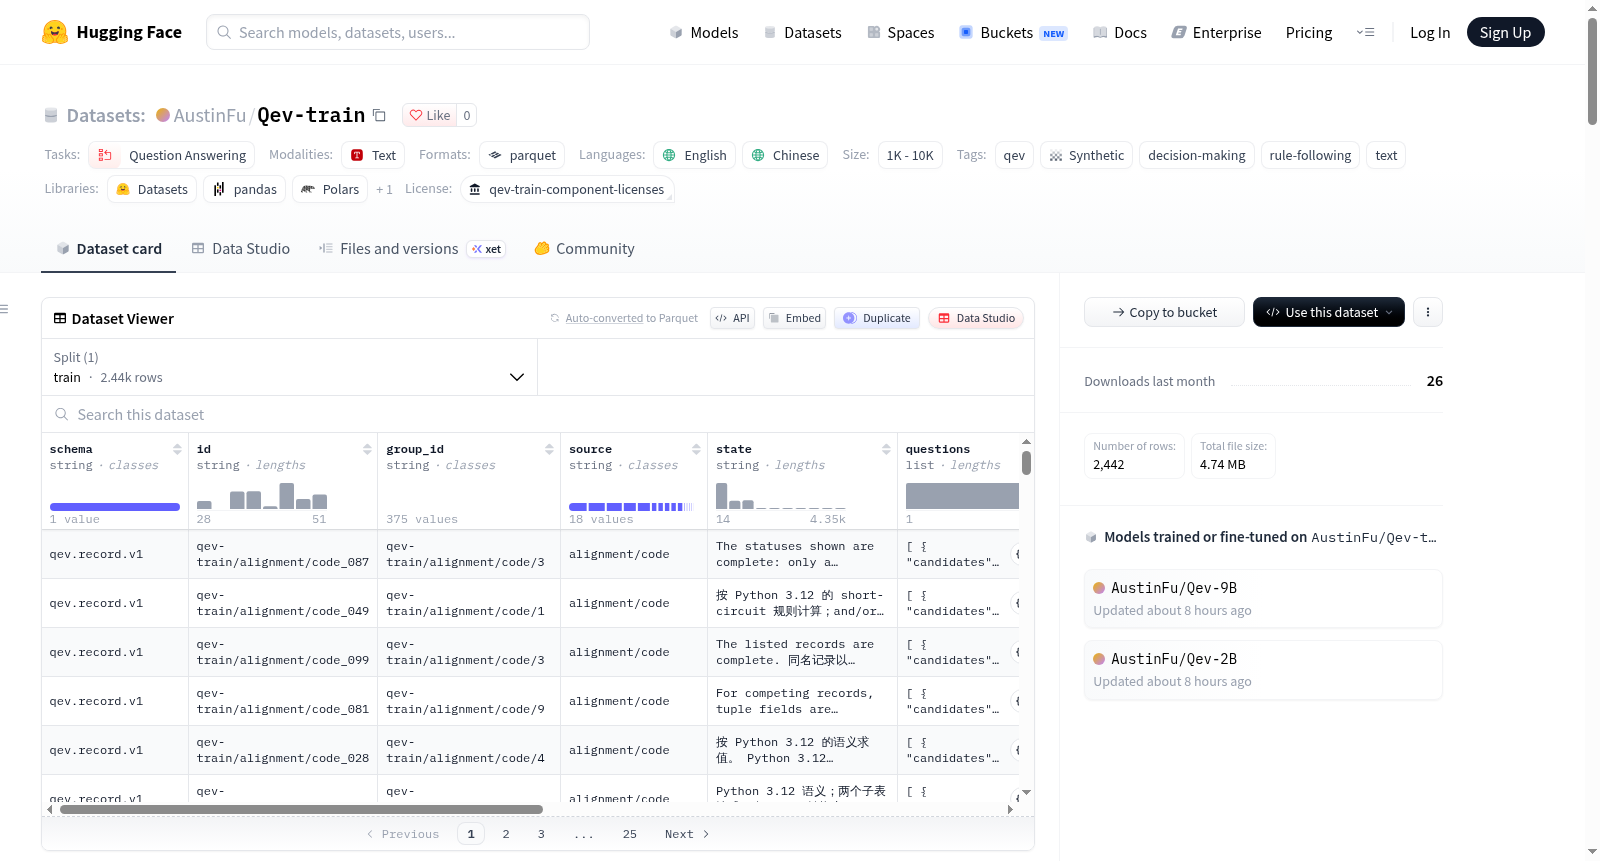
Qev-train是一个包含2,442个合成训练样本的数据集,专门用于训练Qev决策模型。每个样本均提供一个上下文(context)、一个问题(question)、明确的答案选项以及经过审核的硬标签(hard label),不支持教师概率或蒸馏数据。数据集由四个组件构成:对齐任务(1,170例,涵盖金融决策、虚构规则、Python表达式和安全授权操作,遵循Apache-2.0许可证)、规则合规(364例,要求根据文档判断单一规则,共182个正/反例对,同样为Apache-2.0)、世界知识(308例,基于维基百科引用的事实、概念区分和简短应用,采用CC BY-SA 4.0许可证)以及HelpSteer3边界任务(600例,涵盖格式/事实、数字/时间、证据、规则/异常和表格操作,每个种子有五个受控变体,采用CC BY 4.0许可证)。所有样本均为训练集(split为train),无独立的评估验证集。数据字段包括稳定的示例ID和组ID、人类可读的来源和组件、领域、上下文、问题列表(含问题ID、类型、指令、候选项、标签和目标)、语言(英语、中文或中英混合)、生成阶段、训练分区以及适用的许可证信息。该数据集适用于问答、决策制定、规则遵循等任务。
Qev-train is a dataset containing 2,442 synthetic training samples, specifically designed for training Qev decision models. Each sample provides a context, a question, explicit answer options, and reviewed hard labels, without teacher probabilities or distillation data. The dataset consists of four components: alignment tasks (1,170 cases covering financial decisions, fictional rules, Python expressions, and security authorization operations, licensed under Apache-2.0), rule compliance (364 cases requiring judgment of a single rule based on documents, with 182 positive/negative pairs, also Apache-2.0), world knowledge (308 cases based on Wikipedia references for facts, concept distinctions, and brief applications, licensed under CC BY-SA 4.0), and HelpSteer3 boundary tasks (600 cases covering format/facts, numbers/time, evidence, rules/exceptions, and table operations, with five controlled variants per seed, licensed under CC BY 4.0). All samples are in the train split, with no separate evaluation/validation set. Data fields include stable example ID and group ID, human-readable source and component, domain, context, question list (with question ID, type, instruction, candidates, label, and target), language (English, Chinese, or Chinese-English mixed), generation stage, training partition, and applicable license information. The dataset is suitable for tasks such as question answering, decision making, and rule following.
Qev-train 数据集概述
基本信息
- 数据集名称:Qev-train
- 数据集地址:https://huggingface.co/datasets/AustinFu/Qev-train
- 语言:英语(en)、中文(zh)
- 许可证:other(qev-train-component-licenses),详见 LICENSE.md
- 任务类别:问答(question-answering)
- 数据集规模:1K < n < 10K
- 标签:qev、synthetic、decision-making、rule-following、text
数据集内容
- 包含 2,442 条合成训练样本,用于 Qev 决策模型。
- 每条样本提供上下文(context)、问题(question)、明确的答案选项以及经过审核的硬标签(hard label)。
- 本版本在原 1,842 条样本基础上新增了 600 条受控边界问题。
- 数据集仅包含 原始硬标签,不含教师概率缓存、响应目标或蒸馏配对数据,且为完整混合训练语料的一个子集。
- 所有样本均位于
train划分中,无留出的评估划分。
数据组成
| 组成 | 样本数 | 教学内容 | 许可证 |
|---|---|---|---|
| Alignment(对齐) | 1,170 | 财务决策、虚构规则、简短 Python 表达式及安全授权操作 | Apache-2.0 |
| Rule compliance(规则合规) | 364 | 根据文档判断一项明确要求;182 对正/负样本 | Apache-2.0 |
| World knowledge(世界知识) | 308 | 基于 Wikipedia 参考的事实、概念区分及简短应用 | CC BY-SA 4.0 |
| HelpSteer3 boundary tasks(边界任务) | 600 | 格式/事实、数值/时间、证据、规则/例外及表格;每个种子五个受控变体 | CC BY 4.0 |
| 合计 | 2,442 | 每条记录一个问题 | 见组件许可证 |
使用方法
使用 Hugging Face Datasets 库:
bash python -m pip install datasets
python from datasets import load_dataset
train = load_dataset("AustinFu/Qev-train", split="train") rules = train.filter(lambda row: row["component"] == "rule_compliance") print(train[0]["state"]) print(train[0]["questions"])
JSONL 副本与训练清单可由 Qev 直接加载:
bash hf download AustinFu/Qev-train --repo-type dataset --local-dir data/qev-train
Run from an installed Qev checkout, on a suitable CUDA GPU.
python -m qev.train --config configs/qev-9b-finetune.json --data data/qev-train --out runs/qev-train-finetune --init-checkpoint AustinFu/Qev-9B
- 对于 2B 模型,使用
configs/qev-2b-finetune.json和AustinFu/Qev-2B。 - 这些是进一步训练的示例,并非仅凭此子集复现原始基准分数的配方。
- 如需选择本版本,可在下载命令中添加
--revision v1.1.0,或在load_dataset中添加revision="v1.1.0"。
样本合成方式
- 初始 1,842 条样本:使用
gpt-6-sol搭配xhigh推理进行生成,并通过 Codex 进行模型辅助审核。 - 新增 600 条边界任务:使用
gpt-6-sol和gpt-6-astra(均为xhigh推理)进行规划与独立审核,标签由确定性程序计算。 - 规划在生成前固定目标技能、语言和变体;审核者收到新请求时不显示标签和生成解释。
- 生成与审核由同一模型家族完成,因此一致性并非独立专家认证。
Alignment:351 条初始样本 + 819 条变体
- 初始生成覆盖 4 个领域和 44 个技能族。
- 从 440 个候选中,经模式检查、两轮盲答、质量审核及针对性跟进,选出 351 条合成样本。
- 每个技能族获得 20 个变体计划,共 880 个新候选。
- 有意义的变体必须改变推理相关条件、范围、阈值、时机、证据要求或程序结构;仅重命名实体或改写不足够。
- 保留 819 条变体。代码问题还通过受限 Python 3.12 表达式评估检查:包含 100 条初始和 235 条变体代码样本。
| 领域 | 初始 | 变体 | 合计 |
|---|---|---|---|
| 金融与商业 | 69 | 191 | 260 |
| 虚构规则 | 82 | 178 | 260 |
| Python 代码 | 100 | 235 | 335 |
| 安全授权操作 | 100 | 215 | 315 |
- 相关的原始样本与变体共享
group_id,代表其技能族。 - 规则和政策在问题中提供,不代表现行法律或真实组织政策。
Rule compliance:400 个候选,保留 364 条
- 计划结合 50 个场景 × 四个文档长度区间 × 两个标签。
- 每对描述一个具名案例,询问是否满足一项明确要求;一个版本明确满足,另一个明确违反。
- 缺失证据不被视为否定答案。
- 文档包括邮件、交接说明、报告和日志。
- 保留完整的正/负配对,涵盖全部 50 个场景,共 182 对。
- 保留上下文在准备期间使用的 Qwen 分词器下跨度为 80–827 个 token。
- 标签平衡:182 个
true,182 个false;同一场景的所有长度和配对版本共享一个group_id。
World knowledge:600 个候选,保留 308 条
- 生成从版本化的 Wikipedia 参考卡片开始,覆盖 8 个领域 × 25 个主题 × 三种问题风格:事实识别、概念区分和简短应用。
- 生成器使用这些参考;模型输入包含生成的问题和选项,而非源段落。
- 候选经过盲答、反转选项顺序的另一次盲检,以及单独的来源接地和问题质量审核。
- 发布包含跨 161 个主题的 308 道四选一问题。
- 每条知识样本链接到其文章版本和贡献者,记录于 ATTRIBUTION.jsonl,保留原始 CC BY-SA 4.0 条款。
HelpSteer3 boundaries:120 个父上下文,600 条受控样本
- 种子来自 NVIDIA 的 HelpSteer3 Preference 子集,固定于修订版
f6d145777bcbde96137596340fab89793acd1031。 - 生成器接收上下文和两个源响应,不含其偏好标签,构建与源任务相关的虚构有限规范。
- 不继承原始偏好获胜者和软分数。
- 五个家族各贡献 24 个父组和 120 条样本:分离输出格式与事实正确性;精确数值和时间区间;证据充分性;规则与例外;以及表格过滤、排序和聚合。
- 每个父组产生五个具有已知关系的受控版本;硬标签由精确算术、布尔枚举、显式规则和表格操作计算。
- 准备过程检查了 253 个种子上下文,编制了 163 个父组(815 条样本),最终选出 120 个组(600 条样本)。
- 最终增量包含 360 道多选题和 240 道二元题,每个家族 120 条记录;所有五个变体共享源上下文的
group_id。 - HELPSTEER3_ATTRIBUTION.jsonl 记录每条样本的谱系和 CC BY 4.0 归属。
- 这些是新的硬标签任务,而非 Preference 排序监督或教师概率蒸馏数据。
- 训练时,在
training.none_insert_exempt_sources中保留synthetic/hs3_preference_boundary/,以免在线选项增强改变已审核的候选集。当前 Qev 微调配置已包含此豁免。
格式与元数据
train.jsonl和data/train.parquet包含相同记录。JSONL 格式为qev.record.v1:
| 字段 | 含义 |
|---|---|
id、group_id |
稳定样本 ID 及相关的场景/技能/主题组 |
source、component、domain |
人类可读的来源类别和主题 |
state |
展示给模型的上下文 |
questions |
问题 ID/类型、指令、有序候选、标签和目标 |
language |
生成计划或受控渲染器语言:en、zh 或 en-zh |
generation_stage |
初始对齐、对齐变体、配对规则、来源接地或受控边界生成 |
training_partition |
在原始混合训练配方中的位置:main 或 late |
license |
适用于此记录的条款 |
- 问题标签为候选 ID,包括二元判断的字符串
true和false。 - 目标为按候选顺序的独热向量,是硬标签编码,而非蒸馏的教师概率。
- 语言元数据反映生成计划,并非独立语言识别结果。
- statistics.json 包含精确计数。
- 在 Qev-9B v0.2.0 中,308 条知识样本和 600 条边界样本出现在 main 划分中。
- 完整 main 划分有 39,605 条记录,包括来自上游数据集的 4,459 条额外 HelpSteer3 Principle 判断。
- 原始对齐和文档规则样本保留在 1,783 条记录的 late 划分中,混入训练后半段并重复三次。
- 每条样本在此发布一次;重复是训练计划的选择。
质量与局限性
- 导出检查每条样本出现在发布模型的原始训练配方中,并保留其输入和标签。
- 检查模式、候选/目标一致性、重复输入,以及与现有开发、校准和测试划分的精确输入/组重叠。
- 早期准备还检查了本地外部评估输入,但未将这些输入提供给生成器。
- 数据仍为合成数据,可能包含模型共有的错误或措辞捷径。
- 精确重叠检查不能确立不存在语义近重复或预训练暴露。
- 组内样本相关。若为新模型构建新验证划分,应按
group_id划分;此类划分对 Qev-9B v0.2.0 并非未见评估数据。 - 这些样本与更大的现有数据池一起使用,其孤立贡献未建立。
- 完整原始训练混合、未选生成草稿和蒸馏数据未包含在内。
许可证与归属
- Qev 的原始对齐和规则合规样本在版权适用处依据 Apache-2.0 提供。
- Wikipedia 接地组件保留 CC BY-SA 4.0 及其每条样本归属。
- 600 条 HelpSteer3 衍生的边界样本使用 CC BY 4.0 及每条样本来源谱系。
- 发布在单一仓库不改变这些组件条款,详见 LICENSE.md。
bibtex @misc{qev_train_2026, author = {Fu, Qiqian and Qev contributors}, title = {Qev-train: Synthetic Training Examples for Decision Models}, year = {2026}, url = {https://huggingface.co/datasets/AustinFu/Qev-train} }