dev_set_v2_a3_rl_DCAgent_inferredbugs_sandboxes_verifier_55_8B_20260827_092854
收藏资源简介:
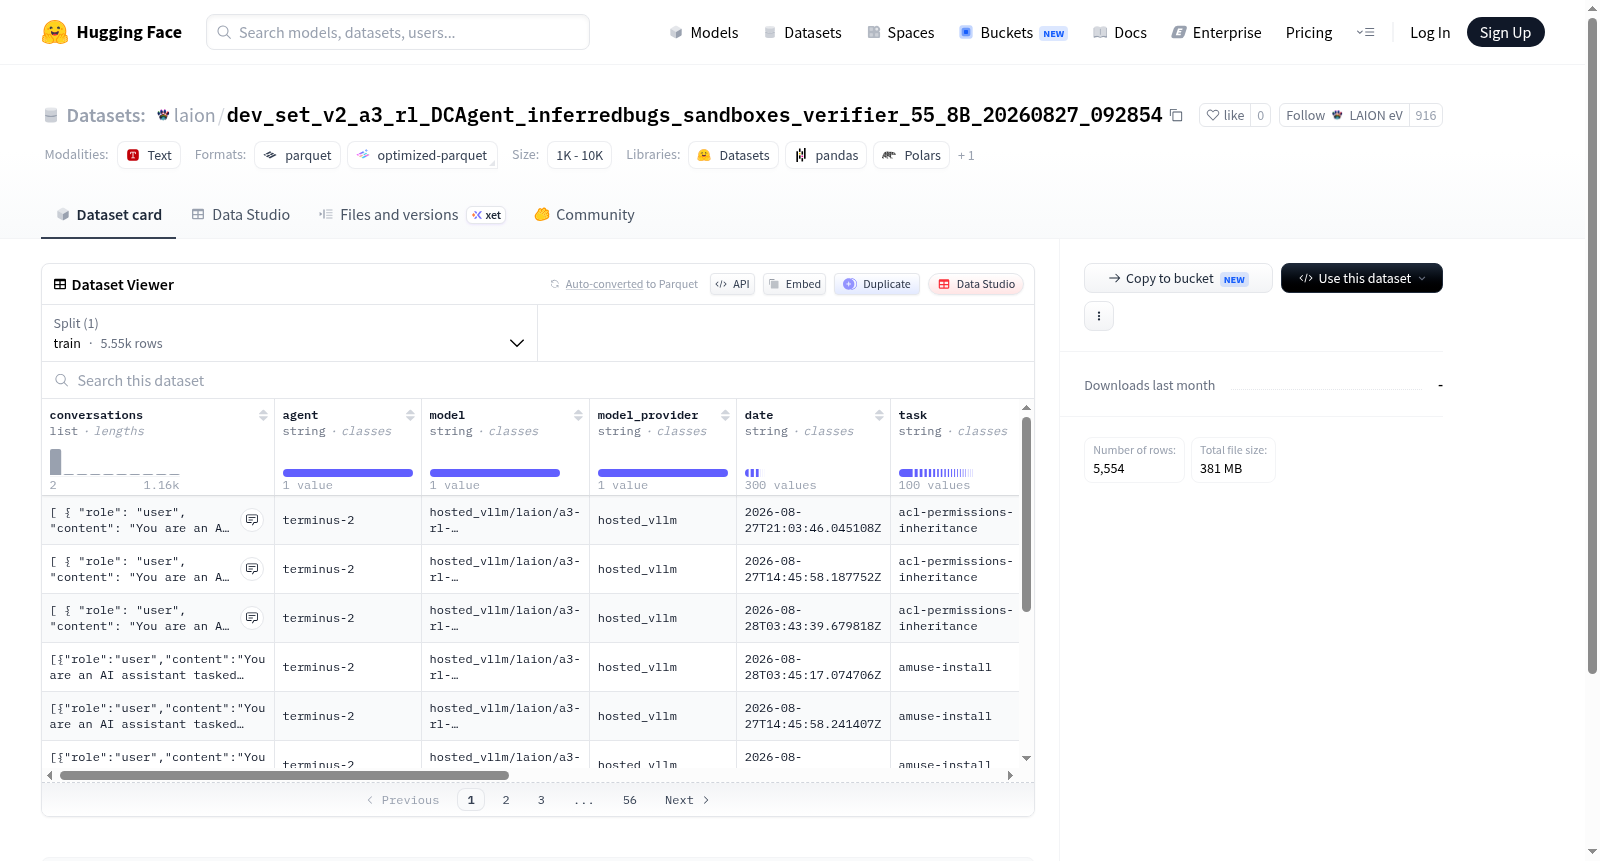
该数据集包含多轮对话记录及其相关元数据,每条样本包括一个conversations字段(对话列表,每条对话包含角色role和内容content),以及agent(智能体名称)、model(使用的模型)、model_provider(模型提供商)、date(日期)、task(任务)、episode(回合)、run_id(运行ID)、trial_name(试验名称)、result(结果)、verifier_output(验证器输出)、trace_source(追踪来源)等字段。数据集共包含5554个训练样本,总大小约438MB。该数据集适用于对话系统的训练、评估与分析,尤其是涉及智能体交互、模型验证和任务执行的场景。
This dataset contains multi-turn dialogue records and their associated metadata. Each sample includes a conversations field (a list of dialogues, each containing role and content), as well as fields such as agent, model, model_provider, date, task, episode, run_id, trial_name, result, verifier_output, and trace_source. The dataset contains a total of 5554 training samples, with a total size of approximately 438MB. It is suitable for training, evaluation, and analysis of dialogue systems, especially in scenarios involving agent interaction, model verification, and task execution.
数据集概述:laion/dev_set_v2_a3_rl_DCAgent_inferredbugs_sandboxes_verifier_55_8B_20260827_092854
该数据集是一个用于训练和评估AI代理(DCAgent)在沙盒环境中修复推断错误(inferred bugs)的强化学习(RL)数据集,其名称中包含了版本、模型规模及日期等信息。
基本信息
- 数据集名称:
laion/dev_set_v2_a3_rl_DCAgent_inferredbugs_sandboxes_verifier_55_8B_20260827_092854 - 数据集提供商: laion
- 数据集大小: 下载大小为380,539,245字节(约363 MB),总数据集大小为438,637,041字节(约418 MB)
- 数据分割: 仅包含一个训练集(train),共5,554个样本
数据特征 (Features)
数据集包含以下特征字段:
| 特征名 | 数据类型 | 描述 |
|---|---|---|
conversations |
列表(包含 role 和 content 字段,均为字符串) |
代理与环境的对话记录,role 表示角色(如用户或助手),content 表示对话内容 |
agent |
字符串 | 使用的代理名称或配置 |
model |
字符串 | 底层模型标识 |
model_provider |
字符串 | 模型提供商 |
date |
字符串 | 数据生成日期 |
task |
字符串 | 任务描述或标识 |
episode |
字符串 | 训练或交互的集数标识 |
run_id |
字符串 | 运行ID |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 任务结果 |
verifier_output |
字符串 | 验证器输出(用于结果验证) |
trace_source |
字符串 | 追踪来源 |
数据用途
该数据集主要服务于强化学习场景,其设计意图包含以下关键要素:
- 代理(DCAgent): 用于执行代码修复或错误定位任务的AI代理。
- 推断错误(inferred bugs): 数据集中包含的是通过自动化方式推断出的错误样本。
- 沙盒环境(sandboxes): 代理在隔离的沙盒环境中执行操作,以提高安全性和可控性。
- 验证器(verifier): 使用验证器(
verifier_output字段)来评估代理动作的正确性或任务完成情况。 - 模型规模: 名称中的“55_8B”暗示模型可能涉及55亿或80亿参数规模的架构,具体取决于模型命名约定。
数据格式
数据文件存储在 data/train-* 路径下,使用默认配置(default),支持按需加载。整个数据集以JSON或类似格式的组织方式存储,便于直接用于训练循环或评估流程。
总结
该数据集是一个面向 RL训练 的高质量开发集(dev_set_v2),专注于AI代理在沙盒环境中对推断错误进行修复的过程,并配有验证器输出以辅助监督学习或奖励建模。适合用于训练代码修复代理、评估代理在复杂任务中的表现,以及研究强化学习在软件开发自动化中的应用。