
NearID dataset
收藏资源简介:
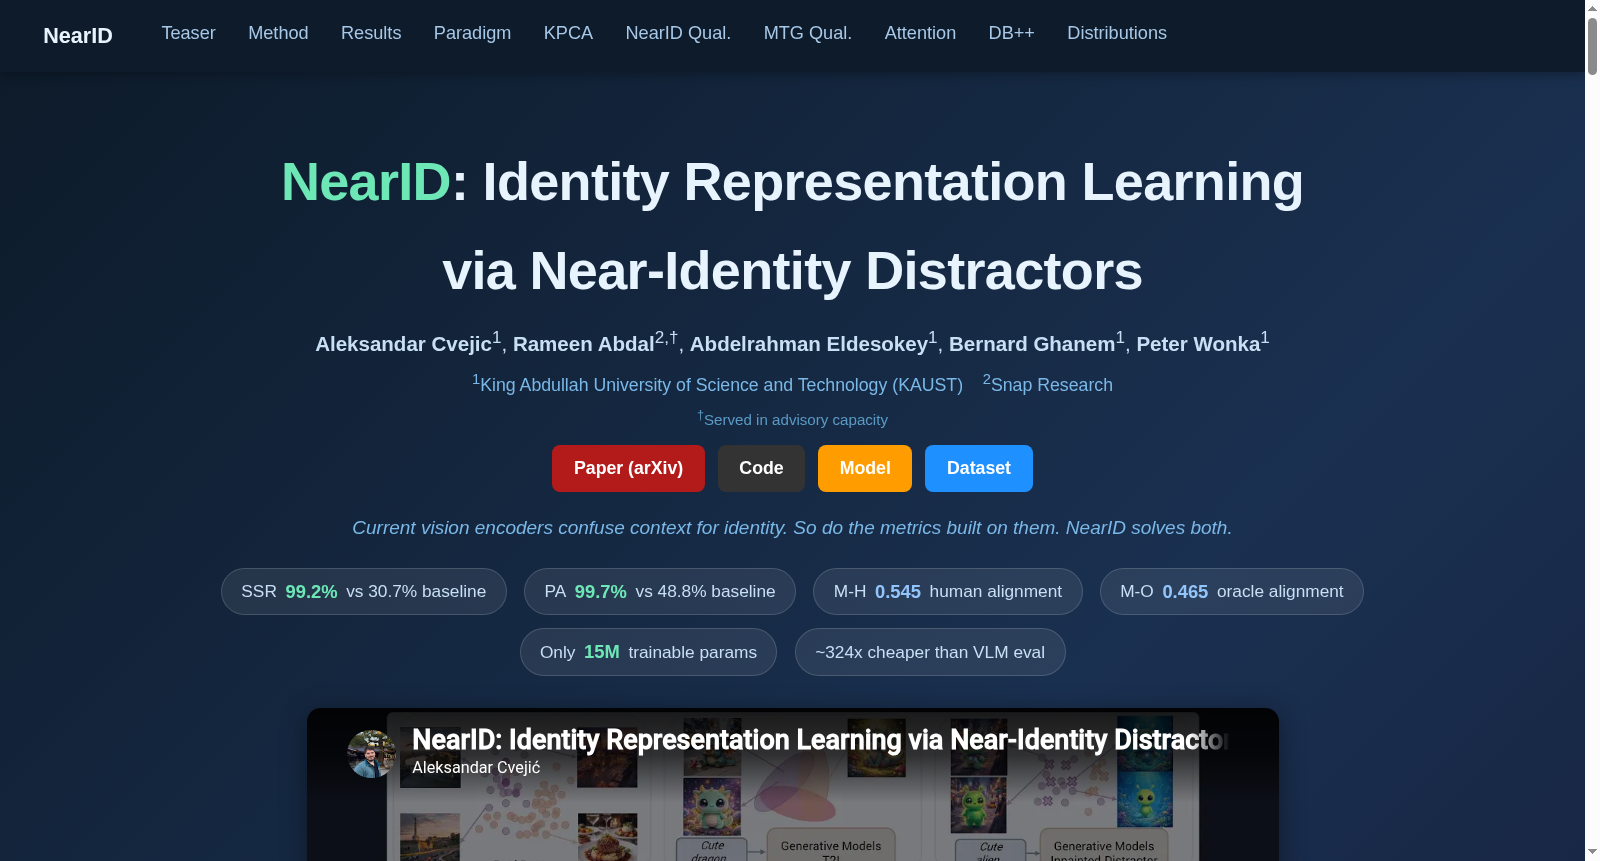
NearID数据集由阿卜杜拉国王科技大学和Snap研究院联合构建,旨在解决视觉编码器中对象身份与背景上下文纠缠的问题。该数据集包含19,000个对象身份和316,000个经过匹配上下文处理的近身份干扰项,数据通过四种生成模型合成。其创新性地将语义相似但不同的实例置于相同背景中,以隔离纯粹的身份信号。数据集主要应用于个性化生成、图像编辑等身份敏感任务的评估与模型训练,显著提升了身份表示的 discriminative 能力。
The NearID dataset was jointly constructed by King Abdullah University of Science and Technology (KAUST) and Snap Research, aiming to address the issue of entanglement between object identity and background context in visual encoders. This dataset contains 19,000 object identities and 316,000 near-identity distractors processed with matched context, and the data is synthesized using four generative models. It innovatively places semantically similar but distinct instances within identical backgrounds to isolate pure identity signals. The dataset is primarily used for the evaluation and model training of identity-sensitive tasks such as personalized generation and image editing, and it significantly enhances the discriminative capability of identity representations.
NearID 数据集概述
数据集基本信息
- 数据集名称: NearID
- 核心目标: 解决视觉编码器将上下文与身份混淆的问题,并改进基于这些编码器的评估指标。
- 关键方法: 通过引入匹配上下文的干扰项(近身份干扰项)来消除上下文捷径,并隔离内在的身份信号。
核心方法
- 框架: 对比学习框架,使用显式结构化的近身份干扰项。
- 正样本: 通过深度条件生成和跨视图特征扭曲从 Objaverse 3D 资产(SynCD 流程)生成的同一对象身份的 3D 一致多视图图像。
- 负样本(近身份干扰项): 一个不同但视觉上相似的实例,被修复到与锚点完全相同的背景中。
- 模型架构: 冻结的 SigLIP2 骨干网络 + 15M 参数的 MAP 头,用于重塑相似性几何结构。
主要性能结果
- SSR(身份检索成功率): 99.17%(相比 SigLIP2 基线提升 +68.43%)。
- PA(配对准确率): 99.71%(相比 SigLIP2 基线提升 +50.90%)。
- MTG Oracle 对齐(M-O): 0.465(相比 SigLIP2 基线提升 +0.285)。
- DB++ 人类对齐(M-H): 0.545(相比 SigLIP2 基线提升 +0.029)。
- 训练参数量: 仅 15M 可训练参数。
- 评估成本: 比 VLM 评估便宜约 324 倍。
对比基准
在近身份协议下,与现有嵌入方法和 VLM 方法对比:
- Qwen3VL 30B: SSR 49.73%, PA 69.20%, M-O 0.219。
- CLIP: SSR 10.31%, PA 20.92%, M-O 0.239, M-H 0.493。
- DINOv2: SSR 20.43%, PA 34.55%, M-O 0.324, M-H 0.492。
- VSM*: SSR 32.13%, PA 46.70%, M-O 0.394, M-H 0.190。
- SigLIP2: SSR 30.74%, PA 48.81%, M-O 0.180, M-H 0.516。
- NearID: 在 SSR、PA、M-O 和 M-H 指标上均达到最佳或前列性能。
训练过程可视化(KPCA演化)
- 初始状态(SigLIP2 基线): 正样本和近身份干扰项交织在一起,无法区分。
- 训练过程(步骤 100-2500): 身份集群开始形成,干扰项逐渐被排斥。
- 最终状态(步骤 3300): 形成紧密的正样本集群,干扰项被清晰地推离。
定性评估
- 身份区分: NearID 能正确抑制与锚点共享相同背景的干扰项,并为正样本分配更高的相似性分数。
- 局部编辑识别: 在 MTG 数据集的局部编辑任务中,NearID 能捕捉部分级别的身份差异。
- 注意力聚焦: 训练后,MAP 头的注意力重新聚焦于身份判别区域。
在 DreamBench++ 上的表现
- 按类别 M-H: NearID 在 Object 类别上领先(0.549),在 Animal、Human 和 Style 类别上具有竞争力。
- 效率: 以 15M 参数的 MAP 头实现可比性能,每个嵌入计算时间 <1 ms。
分数分布
- MTG 测试集 ECDF: NearID 的分数分布与 Oracle(参考标准)紧密跟踪,表明其分数与实际部分编辑严重程度相关。
- 1NearID: Identity Representation Learning via Near-identity Distractors阿卜杜拉国王科技大学; Snap研究院 · 2026年



