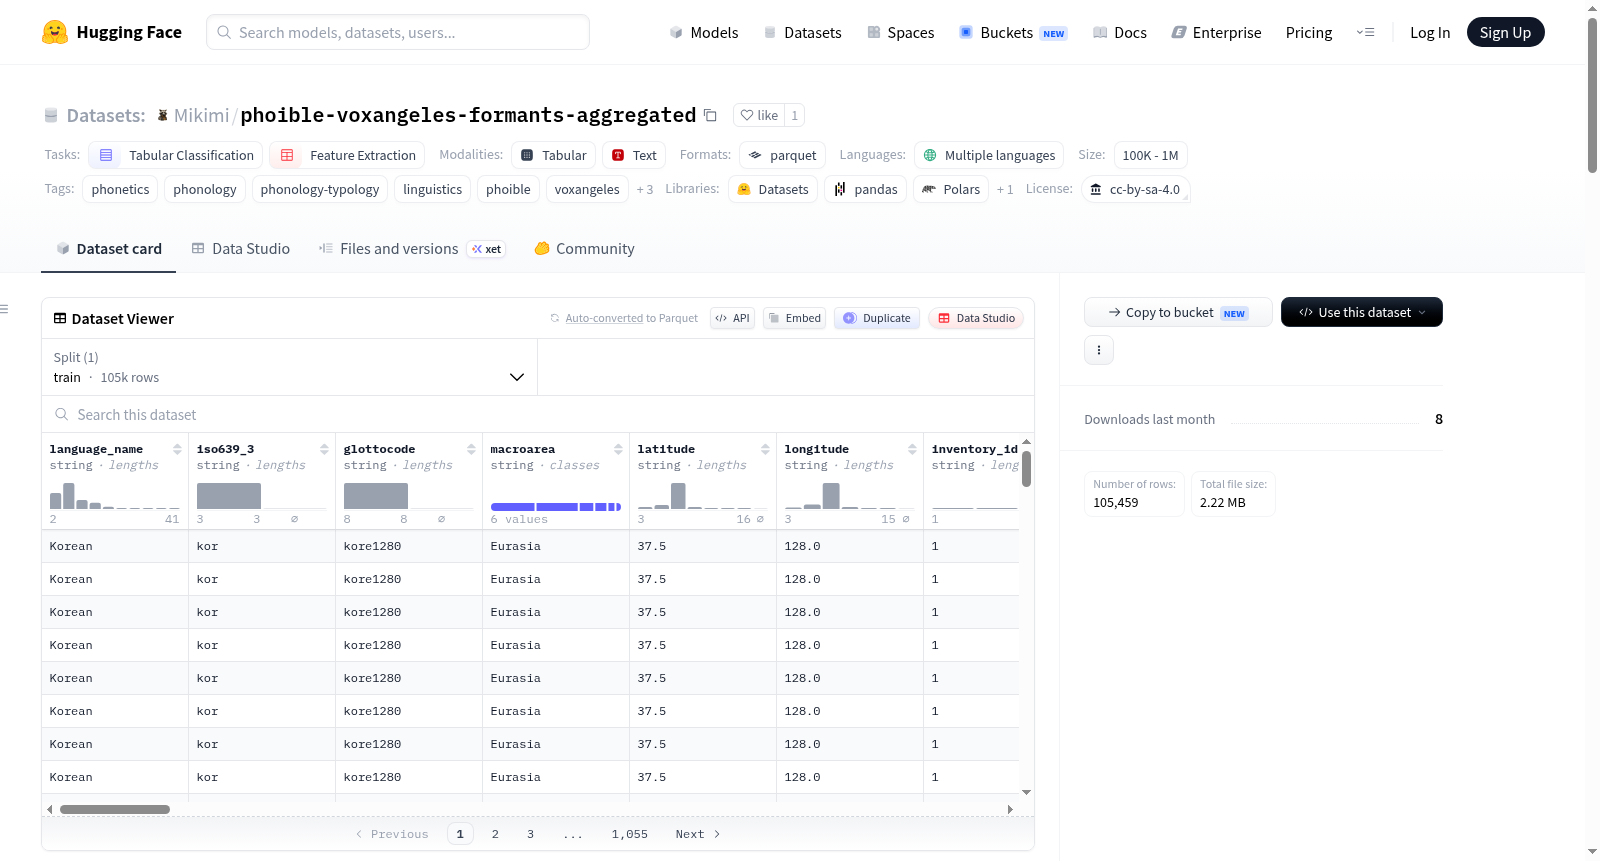
phoible-voxangeles-formants-aggregated
收藏资源简介:
PHOIBLE × VoxAngeles 音位清单与共振峰(聚合版)数据集是一个跨语言的表格数据集,核心目标是将世界语言的音位清单信息与真实语音录音的声学特征相结合。它整合了来自PHOIBLE数据库的音位清单及其区别性特征矩阵,以及来自VoxAngeles语料库(基于UCLA语音实验室档案)的经过语音学审核和音段对齐的共振峰数据(F1-F5)。数据集以“一个语言清单中的一个音位”为基本单位(每一行),提供语言元数据(如语言名称、ISO 639-3代码、Glottocode、地理区域、经纬度)、音位信息(IPA符号、音段类别:辅音、元音或声调)、以及约37个区别性特征(如feat_syllabic、feat_nasal等,值为+, -, 0)。对于VoxAngeles语料库覆盖的语言(约95种),数据集通过(语言,IPA符号)匹配,附上基于所有可用录音计算的平均共振峰频率(F1-F5),并通过has_audio布尔标志和n_segments计数标识有音频数据的音位;无匹配音频的音位共振峰列显示为NA。此外,数据集包含指向“实现版”配套数据集的realization_ids字段,后者存储每个单独录音的详细数据。数据集适用于语音学、音系学类型学研究,以及需要结合音系特征和声学特征的机器学习任务(如表格分类或特征提取),但需注意其局限性:音频覆盖不完整、共振峰值是对具体语音实现的平均、匹配基于精确音标、以及测量设置的影响。数据集基于PHOIBLE(CC-BY-SA)和VoxAngeles(CC-BY-NC 4.0)构建,并以CC-BY-SA-4.0许可发布。
数据集概述:PHOIBLE × VoxAngeles — 聚合音素清单与共振峰数据
这是一个跨语言的表格数据集,将世界语言的音素清单(来自 PHOIBLE)与真实音频录制的声学共振峰测量值(F1–F5,来自 VoxAngeles 语料库)进行配对。每一行对应一种语言清单中的一个音素,并标注了 PHOIBLE 的完整区别性特征集,以及(在存在匹配音频的情况下)该音素的平均共振峰频率。
构建逻辑
- 基础数据:PHOIBLE 提供纯符号的音素清单和区别性特征;VoxAngeles 提供带有音段级别标注的音频及其预计算的 F1–F3 共振峰测量(由 Praat 用 Burg 方法测量)。
- 匹配与聚合:通过(语言代码,IPA 符号)对将 VoxAngeles 中的每个发音实现(realization)与 PHOIBLE 音素条目链接。在聚合数据集中,同一音素的所有发音实现的共振峰值被平均。
- 处理缺失:使用左连接保留所有 PHOIBLE 音素。对于 VoxAngeles 未覆盖的音素,共振峰字段设为
NA,并通过has_audio标志明确记录。
数据字段
| 字段名 | 类型 | 描述 |
|---|---|---|
language_name |
字符串 | 语言名称(来自 Glottolog) |
iso639_3 |
字符串 | ISO 639-3 语言代码 |
glottocode |
字符串 | Glottolog 语言代码 |
macroarea |
字符串 | 宏观区域(如 Eurasia, Africa 等) |
latitude |
字符串 | 语言纬度 |
longitude |
字符串 | 语言经度 |
inventory_id |
字符串 | PHOIBLE 清单标识符 |
phoneme_ipa |
字符串 | 音素的 IPA 符号 |
segment_class |
字符串 | 音段类别:consonant、vowel 或 tone |
has_audio |
布尔值 | 在 VoxAngeles 中是否存在匹配音频 |
n_segments |
整数 | 用于计算共振峰均值的音频实现数量(无音频时为 0) |
F1 – F5 |
浮点数 | 平均共振峰频率(Hz),若缺失则为 NA |
feat_* |
字符串 | PHOIBLE 区别性特征(约 37 列,如 feat_tone、feat_syllabic 等,取值 +、-、0) |
realization_ids |
字符串列表 | 在配套实现数据集中对应单个实现记录的 ID |
NA 规则
- 若音素无匹配音频:
F1–F5全部为NA(has_audio = false,n_segments = 0)。 - 若音频存在但仅测得 k 个共振峰(k < 5):保留 k 个数值,其余
5 - k个为NA。 - CSV 导出中
NA以文本NA表示;Parquet/Hugging Face 版本中为真正的空值。
使用示例
python from datasets import load_dataset ds = load_dataset("Mikimi/phoible-voxangeles-formants-aggregated", split="train")
仅筛选有共振峰数据的音素
with_audio = ds.filter(lambda r: r["has_audio"])
仅筛选元音
vowels = ds.filter(lambda r: r["segment_class"] == "vowel")
主要局限
- 音频覆盖不完整:仅 VoxAngeles 覆盖的约 95 种语言拥有共振峰数据。
- 共振峰是实现的属性:数值基于可用发音实现的平均值,不应被视为音素的规范属性。
- 匹配基于符号:通过精确的(语言,IPA 符号)对匹配,转写差异可能导致匹配遗漏。
- 测量设置影响:Praat 的固定上限频率设置无法对所有说话者最优。
数据规模
- 行数范围:100,000 < n < 1,000,000。
- 任务类别:表格分类、特征提取。
许可与来源
- PHOIBLE 2.0:CC-BY-SA 许可。
- VoxAngeles(基于 UCLA 语音学实验室档案):CC-BY-NC 4.0 许可。
- 本数据集:CC-BY-SA-4.0 许可(注意:底层音频受 CC-BY-NC 4.0 约束,非商业用途)。