
LiteFold/IEDB
收藏官方服务:
资源简介:
IEDB是一个经过整理的实验表征免疫表位数据库,包括感染、过敏、自身免疫和移植背景下的B细胞、T细胞和MHC结合数据。
IEDB is a curated database of experimentally characterized immune epitopes, including B cell, T cell, and MHC-binding data across infectious, allergic, autoimmune, and transplant contexts.
提供机构:
LiteFold搜集汇总
数据集介绍
构建方式
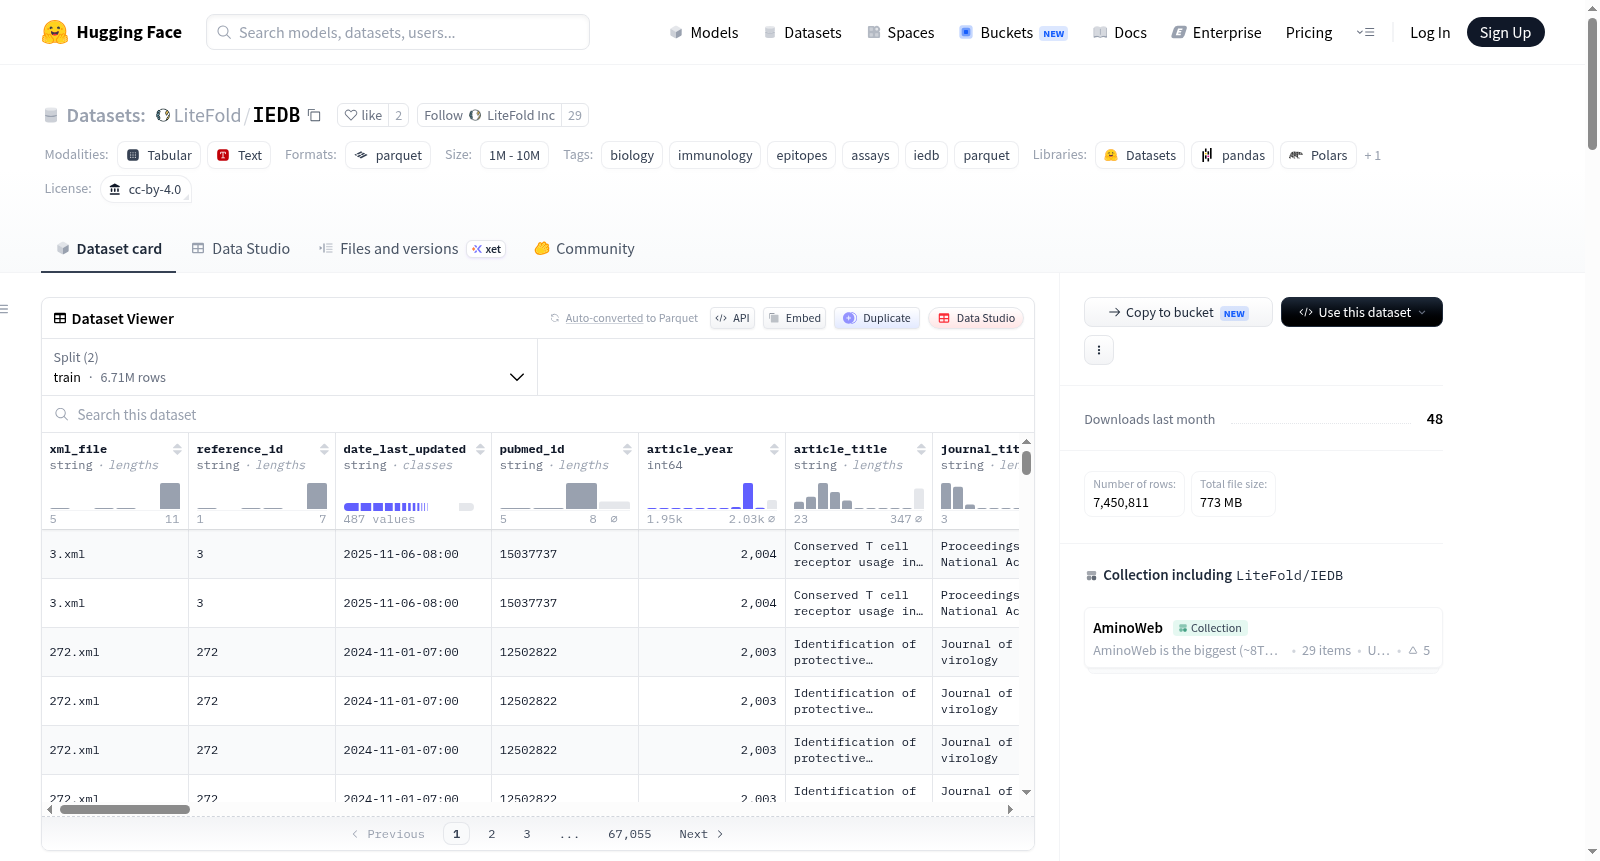
免疫表位数据库(IEDB)是一个经过精心整理的实验性免疫表位数据集,涵盖感染、过敏、自身免疫及移植等情境下的B细胞、T细胞及MHC结合数据。其构建方式基于对26,785个XML文件的系统解析,通过确定性且表位感知的分裂策略进行数据划分:利用SHA-256哈希算法对表位ID进行运算,取模10后余数为0的归入测试集(共745,344行),其余1至9则作为训练集(共6,705,467行)。当缺失表位ID时,系统依次回退至参考ID、实验ID或XML文件名。最终数据集包含超过745万行实验数据,源自26,785篇参考文献,涵盖2,320,500个独特表位,涵盖MHC配体洗脱、B细胞、MHC结合及T细胞四大实验类别。
特点
该数据集的核心特点在于其规模庞大、来源权威且结构丰富。数据总量达7,450,811行,其中MHC配体洗脱实验数据占据主导地位(4,635,502行),其次为B细胞(1,419,468行)、MHC结合(825,450行)及T细胞(570,391行)实验。定性测量结果以阳性为主(5,239,946行),阴性结果亦达1,967,175行。表位化学类型中,蛋白质来源肽段最为常见(6,773,619行),同时包含非天然肽段、不连续蛋白残基等特殊类型。每条记录均包含丰富的元数据列,如来源XML文件、文献引用信息、表位序列与结构类型、实验条件(宿主、MHC等位基因、细胞类型)及定量测量值等,为免疫学深度分析提供了全面的数据基础。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,基本用法为`load_dataset("LiteFold/IEDB")`,即可直接访问训练集与测试集。支持按需加载单个划分(如`split="train"`或`split="test"`),并可通过设置`streaming=True`实现流式读取,避免大规模数据完全下载至本地。利用`filter`方法可高效筛选特定实验类型,例如筛选阳性T细胞实验数据。对于大规模计算任务,推荐采用流式处理或直接操作底层的Parquet文件,借助DuckDB、PyArrow、Polars或Apache Spark等列式引擎进行高效查询与分析,从而充分挖掘该数据集的科学价值。
背景与挑战
背景概述
免疫表位数据库(Immune Epitope Database, IEDB)于2004年由美国国立过敏与传染病研究所(NIAID)资助建立,旨在系统收集和整理实验验证的免疫表位数据,覆盖B细胞、T细胞以及主要组织相容性复合体(MHC)结合等多样化的免疫学检测类型。该数据库由拉霍亚免疫学研究所(LJI)主导维护,其核心研究问题包括揭示病原体、过敏原、自身抗原及移植抗原的免疫应答机制,并为疫苗设计与免疫治疗提供关键数据支持。作为全球免疫表位领域最具权威性的资源之一,IEDB广泛应用于基础免疫学、转化医学及计算生物学研究,有力推动了表位预测算法的发展与免疫原性评估标准的建立。
当前挑战
该数据集所面临的挑战主要体现在两大层面。在领域问题方面,免疫表位数据具有高度异质性,包括实验条件、检测方法、宿主因素等多种变量,使得跨实验整合与标准化分析极其困难。此外,大量非肽类表位(如碳水化合物片段)及不连续蛋白残基表位的数据稀疏,模型泛化能力受限。在数据集构建方面,原始数据来源于26,785个XML文件,总大小超过26 GB,解析过程中需处理复杂的嵌套结构、缺失现象及不一致的命名体系,确保无解析错误的同时还须维持表位与实验间的层级关联。基于表位ID的确定性划分策略虽兼顾可复现性,但测试集仅占10%,且需为无表位ID的条目设计优雅的回退分桶规则,增加了数据拆分工程复杂度。
常用场景
经典使用场景
在免疫信息学与计算疫苗学的前沿领域,IEDB数据集作为免疫表位实验数据的权威宝库,其经典使用场景集中于表位预测模型的构建与基准测试。研究者可借助其涵盖B细胞、T细胞及MHC结合实验的海量标注数据,训练深度学习或机器学习算法以精准识别线性、构象型表位,并评估模型在跨病原体、过敏原及自身免疫背景下的泛化能力。数据集中超过740万条检测记录,结合明确的阴阳性标签与MHC等位基因信息,为开发高精度、低假阳性的表位预测工具提供了无可替代的训练与验证基石,从而加速免疫原性区域的系统性发现。
衍生相关工作
围绕IEDB数据集衍生出的一系列开创性工作,构成了计算免疫学发展的核心脉络。早期里程碑包括NetMHC与NetMHCpan系列工具,它们利用IEDB的MHC结合数据训练人工神经网络,实现了对多种等位基因结合肽段的精准预测。随后,基于该数据集的深度学习模型如DeepTCR和TITAN,通过整合T细胞受体与表位配对的实验记录,推动了免疫组库分析范式的变革。大型语言模型时代,研究界更利用其表位序列与检测标签,微调蛋白质语言模型以生成具有高免疫原性的新型肽段,从而在合成生物学与疫苗设计领域开辟了全新的推理路径。
数据集最近研究
最新研究方向
在免疫信息学领域,IEDB数据集的持续扩充与精细化整合正推动着表位预测与疫苗设计的前沿研究。随着2024年更新版本收录超过745万条实验测定数据、涵盖232万个独特表位及26,785篇文献,该资源已成为解析B细胞、T细胞及MHC结合表位免疫应答的核心基石。当前热点聚焦于利用其海量阳性与阴性测定值(如近524万条阳性记录)训练深度学习模型,以实现高精度表位筛选与免疫原性预测;同时,结合MHC等位基因多态性、宿主疾病状态等元数据,研究正朝跨病原体、个性化免疫治疗方向延伸。这一集成式数据库不仅加速了传染病疫苗与自身免疫病干预靶点的发掘,更通过标准化化学类型与测定分类,为基于人工智能的免疫组学交叉验证提供了可靠基准。
以上内容由遇见数据集搜集并总结生成


