
vlite25-148M-dataset
收藏官方服务:
资源简介:
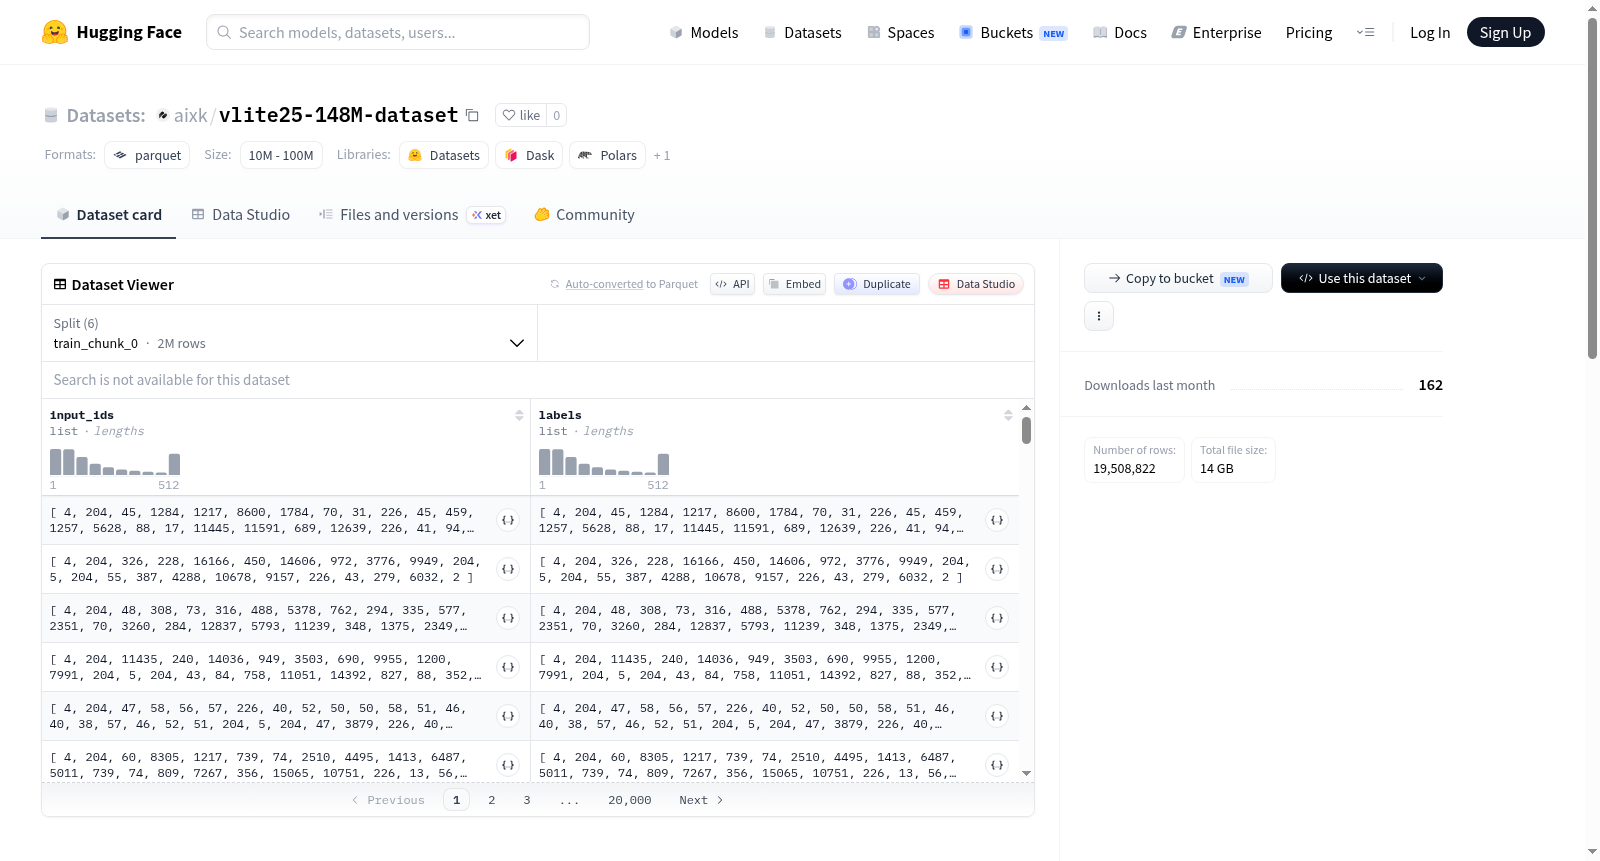
该数据集包含约975万个样本,总大小约为31.56 GB。数据被组织为5个分块(train_chunk_0至train_chunk_4)以及一个合并的训练集(train)。每个样本由两个字段构成:`input_ids`和`labels`,两者均为int32类型的列表。该数据集由ISAI(이사이)项目的独立开发者创建和维护,该项目涵盖从模型开发到数据集准备的全流程。
This dataset contains approximately 9.75 million samples, with a total size of about 31.56 GB. The data is organized into 5 chunks (train_chunk_0 to train_chunk_4) and a merged training set (train). Each sample consists of two fields: `input_ids` and `labels`, both of which are lists of int32 type. The dataset is created and maintained by an independent developer of the ISAI (이사이) project, which covers the entire process from model development to dataset preparation.
创建时间:
2026-06-05
原始信息汇总
数据集概述:vlite25-148M-dataset
- 数据集名称:vlite25-148M-dataset
- 数据集提供者:aixk
- 数据集大小:
- 下载大小:约 13.98 GB (13977541204 bytes)
- 数据集总大小(硬盘占用):约 31.56 GB (31562727792 bytes)
- 总样本数:9,754,411 条
数据集划分
数据集包含一个主要的训练集(train),该训练集进一步划分为 5 个子块(chunk),所有子块均已包含在总训练集中。
| 数据划分 | 样本数 | 数据大小(bytes) |
|---|---|---|
train (总) |
9,754,411 | 15,781,363,896 |
train_chunk_0 |
2,000,000 | 3,232,310,104 |
train_chunk_1 |
2,000,000 | 3,236,013,064 |
train_chunk_2 |
2,000,000 | 3,234,714,272 |
train_chunk_3 |
2,000,000 | 3,237,623,160 |
train_chunk_4 |
1,754,411 | 2,840,703,296 |
特征(Features)
数据集包含两个特征,均为整数列表(list[int32]):
- input_ids:输入序列的 token ID 列表。
- labels:用于训练或评估的标签序列 token ID 列表。
数据格式与加载
- 配置文件:
default - 数据文件路径:数据以分片文件的形式存储,路径格式为
data/{split}-*,例如data/train_chunk_0-*、data/train-*。 - 加载建议:该数据集设计用于语言模型训练,可直接使用 Hugging Face
datasets库进行加载。
搜集汇总
数据集介绍
构建方式
vlite25-148M-dataset 是一个面向语言模型预训练任务的大规模文本数据集,其构建方式体现了对数据规模与结构完整性的审慎考量。该数据集将全部样本划分为五个训练分块(train_chunk_0 至 train_chunk_4),其中前四个分块各包含约两百万条样本,最后一个分块包含约一百七十五万条样本,合计超过九百七十五万条训练实例。每个样本由 input_ids 和 labels 两个字段构成,字段类型均为整型列表,这种设计便于直接用于基于自回归损失的语言模型训练。数据集总大小约为 31.5 GB,经压缩下载后约为 14 GB,既保证了数据量的充足,也在一定程度上兼顾了传输与存储的便捷性。
特点
该数据集的核心特点在于其纯粹的架构设计与规模化配置。每一条样本均以“输入-标签”的对应形式呈现,input_ids 和 labels 的长度对齐,恰好契合因果语言模型(如 GPT 系列)的标准训练范式。数据集不以特定领域或语言为限,具备良好的通用性,可作为预训练语料适配多种模型与下游任务。数据被均匀地切分为多个分块,不仅便于分布式加载与训练,也降低了单次内存占用的压力。此外,数据集由 ISAI 项目独立维护,并配有清晰的许可证与引用指引,具备良好的透明度和可复现性。
使用方法
在应用层面,该数据集可通过 Hugging Face 的 datasets 库进行便捷加载。用户只需指定数据集名称 vlite25-148M-dataset,并利用 load_dataset 函数即可按需加载不同分块的数据。默认配置 config_name 为 default,提供了从 train_chunk_0 到 train_chunk_4 以及整合后的 train 分片路径,数据文件以分块形式存储并支持流式读取。建议在模型训练之前,依据硬件环境选择加载全部数据或部分分块,并可配合 tokenizer 对 input_ids 进行解码以进行数据预览。数据集的使用流程简洁高效,与主流 NLP 框架兼容良好,能快速融入现有的预训练或微调流程。
背景与挑战
背景概述
vlite25-148M-dataset 是由独立开发者 ISAI(이사이)于近期构建的大规模预训练语料库,旨在为轻量级语言模型提供高质量的 token 序列训练数据。该数据集聚焦于降低模型部署门槛,通过提供约 1.48 亿条(总样本数 9,754,411 条,每条包含 input_ids 与 labels)的紧凑型数据,支撑参数量在 148M 左右的模型高效学习。其核心研究问题在于,如何在减少数据冗余的同时,保持下游任务所需的语义丰富性。作为个人开发者主导的项目,该数据集体现了开源社区中‘小而精’的数据构建趋势,对资源受限场景下的模型研发具有重要参考价值。
当前挑战
vlite25-148M-dataset 所面临的挑战主要体现为两点。其一,在领域问题层面,该数据集服务于轻量级语言模型的预训练,其核心挑战在于如何确保压缩后的 token 序列仍能蕴含充分的上下文语义,避免因数据规模缩减导致模型泛化能力下降。其二,在构建过程中,作为独立开发者项目,数据清洗、去重与 token 化等环节缺乏大规模团队支持,需通过自动化流程平衡效率与质量;此外,数据集分片为 5 个训练块,如何保证各分片间的数据分布一致性以避免训练偏差,也是一项技术难题。
常用场景
经典使用场景
在大规模语言模型预训练的征程中,数据是塑造模型能力的基石。vlite25-148M-dataset作为一款精心整理的高质量预训练语料库,其经典使用场景聚焦于下一代轻量级语言模型的基础训练。该数据集包含约975万条样本,以统一的input_ids和labels格式呈现,便于直接接入主流的自回归语言建模框架。研究者可将其用于从零开始训练参数量在1.5亿左右的紧凑型Transformer模型,或作为持续预训练与领域自适应微调的数据源,帮助模型习得流畅的语法结构与丰富的语义表征。
解决学术问题
在学术研究层面,vlite25-148M-dataset致力于攻克小型语言模型训练中数据质量与规模难以兼得的困境。该数据集解决了轻量化模型在有限参数下如何高效捕获语言规律的关键问题,为探索模型压缩、知识蒸馏以及小模型在资源受限场景下的表现提供了可靠的数据基准。通过提供经过预处理的token序列,它消除了研究者清洗与编码文本的重复劳动,使得对比不同架构、优化策略或训练范式时的实验结果更具可比性与可复现性,从而推动高效自然语言处理研究的前行。
衍生相关工作
围绕vlite25-148M-dataset已经衍生出一系列富有启发性的研究工作与衍生资源。研究者常将其作为基线数据,对比不同分词器(Tokenizer)对轻量模型性能的影响,或探索课程学习、数据去重策略对训练效率的提升。此外,该数据集促成了一系列关于小模型微调策略的实证分析,包括适配器(Adapter)模块的有效性、参数高效微调方法在紧凑模型上的表现等。社区还基于此构建了多种量化后的高效推理版本,为实时应用场景提供了即用型解决方案。
以上内容由遇见数据集搜集并总结生成


