ChatterjeeLab/PeptiVerse_data
收藏资源简介:
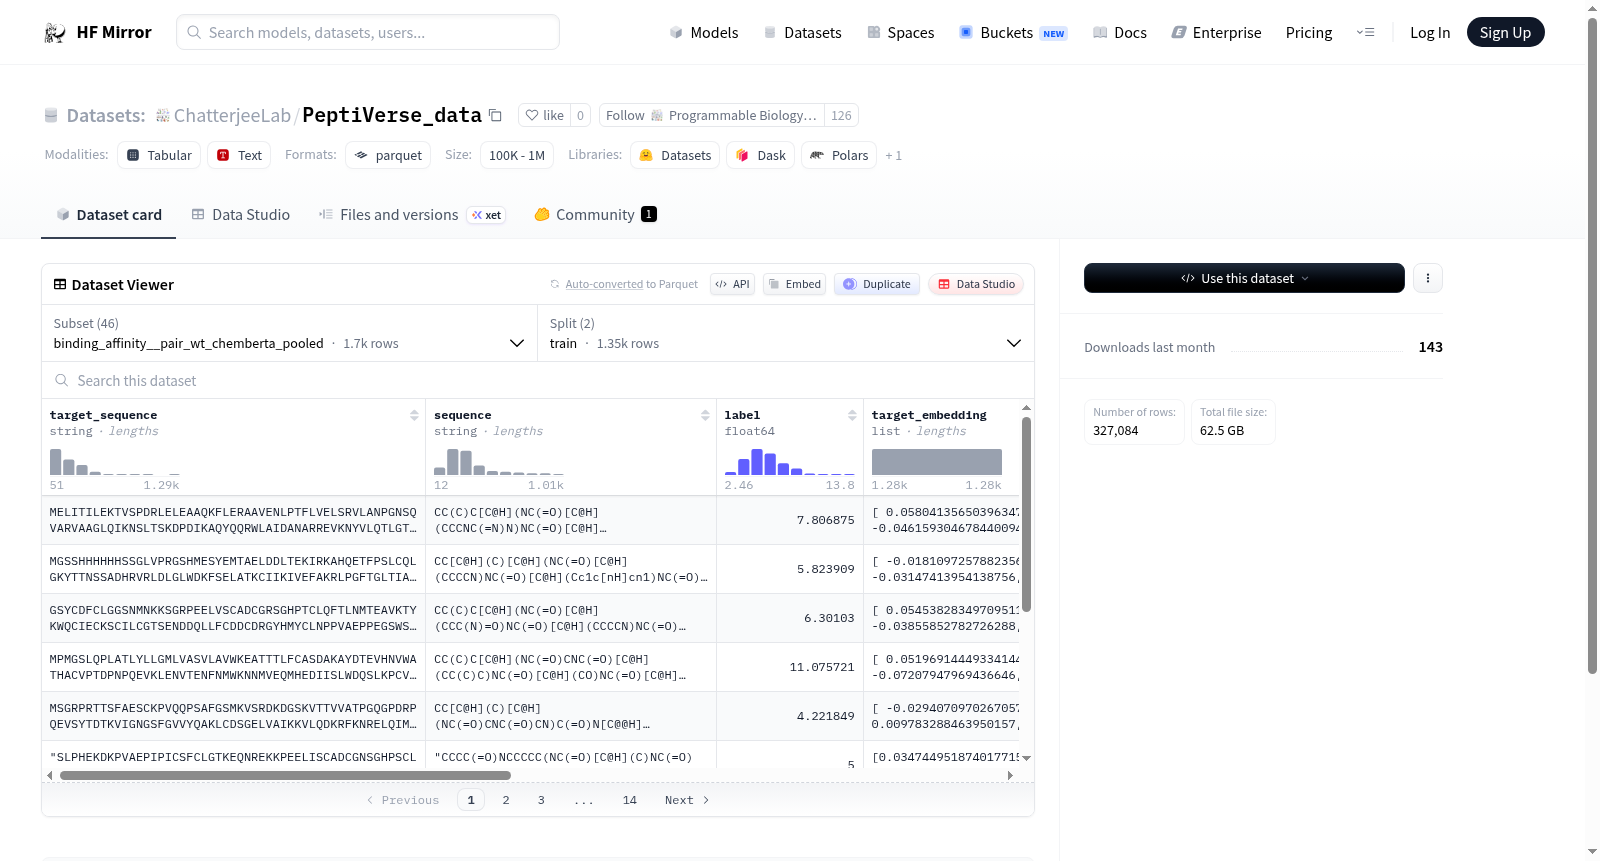
该数据集是一个多任务生物医学数据集,专注于肽和蛋白质相关性质预测。它包含多个子数据集,涵盖结合亲和力、半衰期、溶血性、非折叠性、渗透性(Caco2、PAMPA、渗透性穿透性)、溶解性和毒性等任务。每个子数据集提供序列数据(如目标序列、肽序列、SMILES字符串)和相应的标签(如连续值、分类标签),并集成了从不同预训练模型(包括ChemBERTa、PeptideCLM和WT模型)生成的嵌入特征。数据集分为训练集和验证集,部分配置提供池化(pooled)和未池化(unpooled)的嵌入表示,适用于机器学习模型训练和评估。
This dataset is a multi-task biomedical dataset focused on peptide and protein property prediction. It includes multiple sub-datasets covering tasks such as binding affinity, half-life, hemolysis, non-folding, permeability (Caco2, PAMPA, penetrance), solubility, and toxicity. Each sub-dataset provides sequence data (e.g., target sequences, peptide sequences, SMILES strings) and corresponding labels (e.g., continuous values, categorical labels), and incorporates embedding features generated from different pre-trained models (including ChemBERTa, PeptideCLM, and WT models). The dataset is split into training and validation sets, with some configurations offering both pooled and unpooled embedding representations, suitable for machine learning model training and evaluation.