
tasksource/seahorse_summarization_evaluation
收藏官方服务:
资源简介:
SEAHORSE是一个多语言、多方面的数据集,专门用于摘要评估。它支持德语、英语、俄语、土耳其语和越南语,涵盖了测试、训练和验证三个分割。数据集包含文章、摘要、问题和答案等特征,旨在评估摘要的可理解性、重复性、语法正确性、信息归因、主要思想捕捉和简洁性等方面。
SEAHORSE是一个多语言、多方面的数据集,专门用于摘要评估。它支持德语、英语、俄语、土耳其语和越南语,涵盖了测试、训练和验证三个分割。数据集包含文章、摘要、问题和答案等特征,旨在评估摘要的可理解性、重复性、语法正确性、信息归因、主要思想捕捉和简洁性等方面。
提供机构:
tasksource原始信息汇总
数据集概述
数据集名称
- SEAHORSE
数据集描述
- SEAHORSE 是一个用于摘要评估的多语言、多方面数据集。
数据集作者
- 作者包括:Elizabeth Clark, Shruti Rijhwani, Sebastian Gehrmann, Joshua Maynez, Roee Aharoni, Vitaly Nikolaev, Thibault Sellam, Aditya Siddhant, Dipanjan Das, Ankur P. Parikh。
发布年份
- 2023年
数据集语言
- 德语 (de)
- 英语 (en)
- 俄语 (ru)
- 土耳其语 (tr)
- 越南语 (vi)
任务类别
- 摘要生成
许可协议
- 采用CC许可协议
搜集汇总
数据集介绍
构建方式
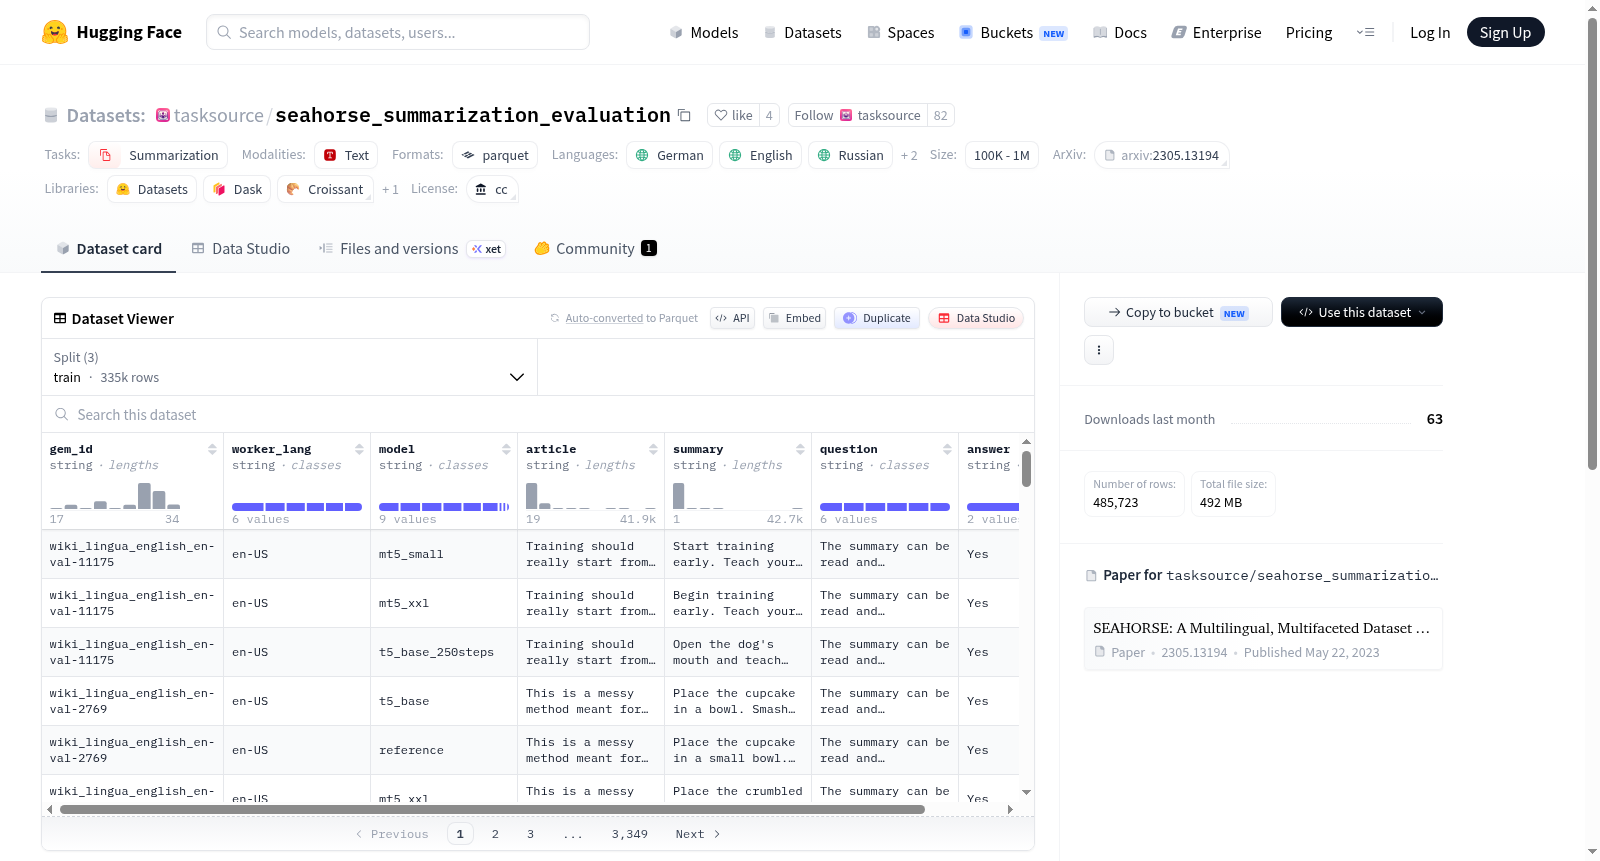
在自动文本摘要评估领域,多语言、多维度的人工评估数据集尤为稀缺。SEAHORSE数据集应运而生,其构建基于大规模众包流程,覆盖德语、英语、俄语、土耳其语和越南语五种语言。数据来源涵盖多种摘要模型生成的摘要及对应的源文章,每个样本均包含gem_id、worker_lang、model、article、summary、question和answer字段。评估维度由六项关键指标构成:可理解性、无冗余、语法正确性、信息可归因性、主旨涵盖度以及简洁性,每个问题均以二值形式记录答案,从而构建起一个结构化的多维评估体系。
特点
该数据集的核心特点在于其多语言与多维度的双重属性。与仅关注单一语言或单一评估维度的传统数据集不同,SEAHORSE提供了跨越五种语言、六项细粒度评估指标的丰富标注,使其能够全面反映摘要质量的不同侧面。数据规模庞大,训练集包含334,806个样本,测试集与验证集分别有101,652和49,265个样本,确保了统计可靠性与模型泛化能力。此外,其评估逻辑采用级联式设计——若摘要不可理解,则后续问题自动跳过,有效提升了标注效率与数据质量。
使用方法
该数据集主要用于训练和评估自动摘要质量评估模型。研究人员可将其划分为训练、验证和测试三部分,利用article、summary和question字段作为输入,以answer字段作为监督标签,训练一个能够预测各维度评估结果的分类模型。具体而言,可针对每个评估问题独立建模,或构建多任务学习框架同时预测所有维度。由于数据已预定义分割,用户可直接通过HuggingFace Datasets库加载使用,无需额外处理。评估时,可依据模型在各维度上的预测准确率或F1分数来量化其评估能力。
背景与挑战
背景概述
文本摘要自动评估是自然语言处理领域长期存在的核心难题,传统基于参考摘要的自动指标(如ROUGE)往往无法捕捉语义忠实性与内容覆盖度的细微差异。在此背景下,由Google Research团队Elizabeth Clark、Shruti Rijhwani等学者于2023年创建的SEAHORSE数据集应运而生。该数据集以多语言、多维度评估为研究核心,涵盖德语、英语、俄语、土耳其语、越南语五种语言,构建了包含超过48万条人工标注样本的评估基准。其创新之处在于提出六项细粒度评估标准——可理解性、重复性、语法正确性、归因准确性、主旨捕捉度及简洁性,为超越传统单维度评分体系提供了全新范式。该数据集已对摘要评估领域产生深远影响,不仅推动了更可靠的自动评估模型研究,也为多语言场景下的生成质量评价树立了标杆。
当前挑战
SEAHORSE数据集面临的挑战具有双重性。在领域问题层面,文本摘要评估长期受困于指标与人类判断之间的低相关性,现有自动评估方法难以准确识别摘要中的事实错误、冗余信息或主旨偏离,而SEAHORSE通过细粒度多维标注试图弥合这一鸿沟,但如何将六项人类评估标准有效转化为可训练的自动化模型仍是关键难点。在构建过程中,跨语言一致性成为突出挑战,五种语言的标注者需对相同的评估维度保持理解对齐,文化差异与语言特异性可能导致标注偏差;此外,每篇摘要需回答六道问题的高标注成本,使得在有限预算下平衡数据规模与标注质量变得极为困难,最终训练集、验证集与测试集的样本分配(33万、4.9万、10万)即是这一权衡的直接体现。
常用场景
经典使用场景
在自然语言处理与文本摘要领域,SEAHORSE数据集作为一项多语言、多维度的人工评估基准,为摘要质量评估提供了系统化的评测框架。该数据集涵盖德语、英语、俄语、土耳其语和越南语五种语言,包含超过48万条样本,每条样本均基于六项细粒度指标——可理解性、无重复性、语法正确性、信息归因性、主旨捕捉度以及简洁性——进行标注,使得研究者能够从多维度精准衡量自动摘要的生成质量。这一经典使用场景尤其适用于对比不同摘要模型在跨语言环境下的表现差异,为多语言摘要系统的公平性评估奠定了坚实的数据基础。
解决学术问题
SEAHORSE数据集的核心学术价值在于解决了摘要评估领域中长期存在的两个关键问题:一是缺乏大规模、多语言、多维度的人工标注评估数据集,二是传统自动评估指标(如ROUGE)与人类判断之间存在显著偏差。通过提供涵盖六项细粒度评价维度的跨语言标注数据,该数据集使研究者能够深入剖析自动摘要模型在可理解性、信息归因等具体方面的优劣,从而推动更符合人类认知的评估方法的发展。其意义在于,它不仅为多语言摘要研究提供了标准化的评估基准,还促进了从单一指标评价向多维质量分析的范式转变,对提升摘要系统的鲁棒性和跨语言泛化能力具有深远影响。
衍生相关工作
SEAHORSE数据集的发布催生了多项具有影响力的衍生工作。一方面,研究者基于其多维度标注框架,开发了如SummaEval和BARTScore等新型自动评估指标,这些指标通过模拟人类对可理解性与信息归因的判断,显著提升了评估结果与人工评价的一致性。另一方面,该数据集被用于训练多语言摘要质量预测模型,直接推动了跨语言摘要系统的迭代优化。此外,SEAHORSE的细粒度设计启发了后续如TrueTeacher和UniEval等统一评估体系的工作,这些研究进一步将评估维度扩展至忠实性、相关性等更广泛的属性,使得摘要评估从单一维度迈向全面化、系统化的新阶段。
以上内容由遇见数据集搜集并总结生成


