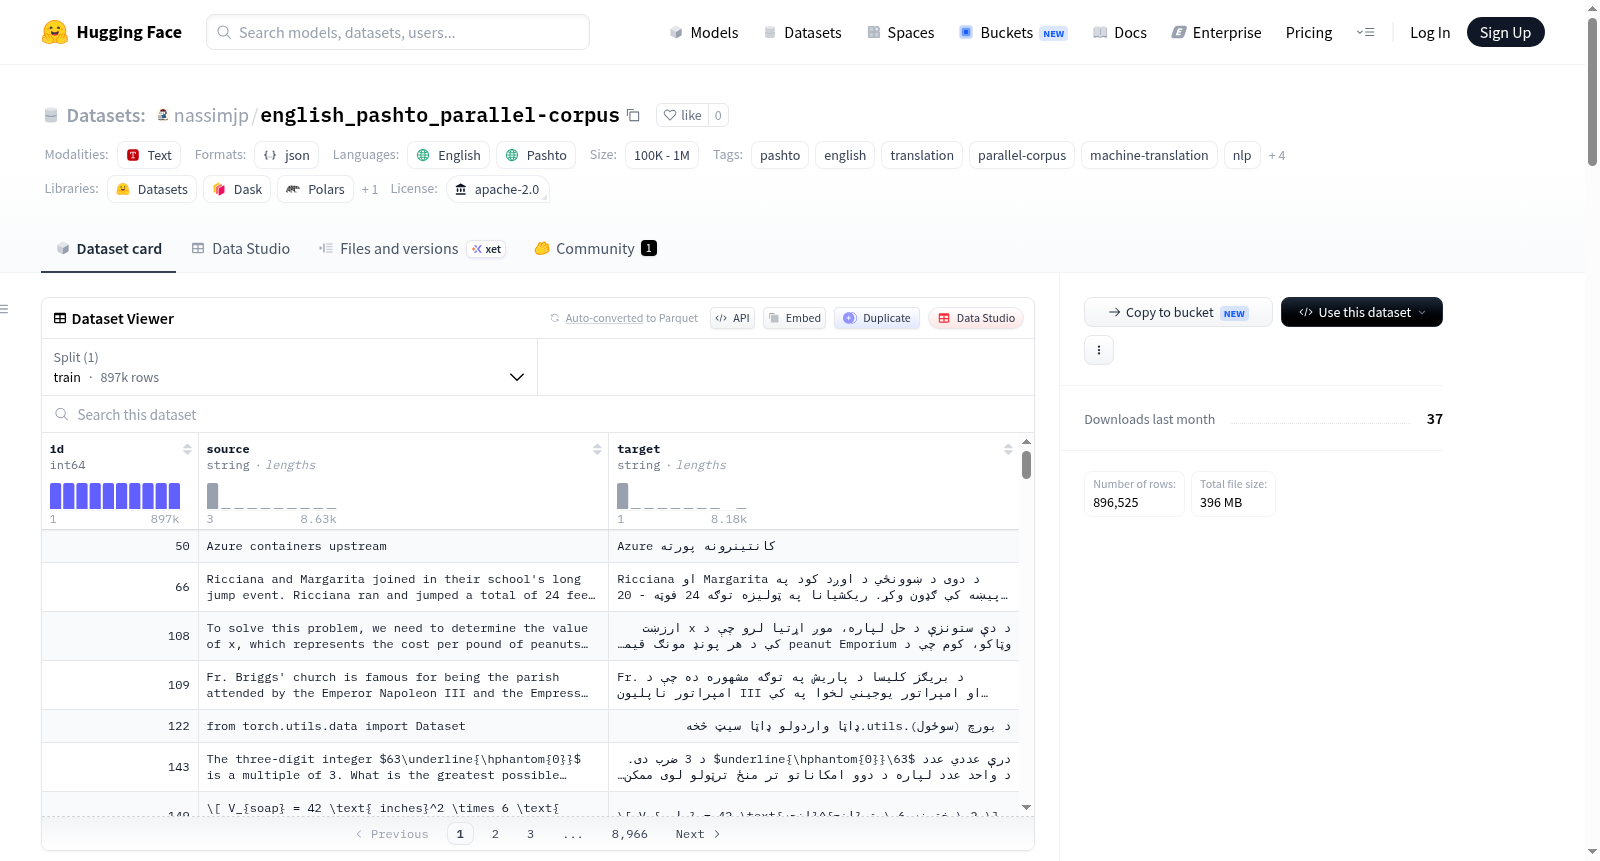
english_pashto_parallel-corpus
收藏资源简介:
English–Pashto Parallel Corpus 是一个高质量的英语-普什图语平行语料库,专为机器翻译、监督微调、普什图语大语言模型训练以及语料库质量研究而设计。该数据集包含两个主要部分:高质量的平行数据(`translation_clean.jsonl`)和异常数据(`translation_anomalies.jsonl`)。高质量数据适用于机器翻译、监督微调、指令调优和推理对齐等任务,每条记录包含唯一ID、英语原文和普什图语译文。异常数据包含在自动检测中识别的记录,如词汇故障、重复标记、误译、英语泄露、格式错误和幻觉生成的普什图语等,对语料库调试、自动校正、质量基准测试和异常检测研究有价值。数据集总计830,879条记录,其中高质量记录713,429条(占85.86%),异常记录117,450条(占14.14%)。数据集经过了多阶段质量处理流程,包括JSON合并验证、翻译缓存合并、去重、普什图语提取、基于长度的过滤、标记重复检测、英语泄露检测、词汇异常检测、质量评分以及干净与异常数据集分割。适用于英语↔普什图语机器翻译、普什图语LLM预训练、监督微调、指令调优、推理对齐、语料库质量研究、异常检测基准测试和数据清洗管道开发等多种应用场景。
English–Pashto Parallel Corpus 数据集概述
基本信息
- 数据集名称: English–Pashto Parallel Corpus
- 语言: 英语(en)、普什图语(ps)
- 许可证: Apache-2.0
- 标签: pashto, english, translation, parallel-corpus, machine-translation, nlp, llm-training, pashto-ai, anomalies, clean-corpus
- 数据集规模: 100K < n < 1M
数据集结构
数据集包含两个子集文件:
1. translation_clean.jsonl
- 高质量平行语料,适用于机器翻译、监督微调(SFT)、普什图语大语言模型训练、指令微调、推理对齐等任务。
- 数据格式: json { "id": 12345, "source": "English sentence...", "target": "Pashto translation..." }
2. translation_anomalies.jsonl
- 包含在自动异常检测过程中识别的记录。
- 典型异常类别包括:词汇故障、重复标记、误译、英语泄漏、格式错误、幻觉式普什图语。
- 适用于语料库调试、自动校正流程、质量基准测试、异常检测研究。
数据集统计
| 指标 | 数值 |
|---|---|
| 总记录数 | 830,879 |
| 干净记录数 | 713,429 |
| 异常记录数 | 117,450 |
| 干净比例 | 85.86% |
| 异常比例 | 14.14% |
用例
- 英语 ↔ 普什图语机器翻译
- 普什图语大语言模型预训练
- 监督微调(SFT)
- 指令微调
- 推理对齐
- 语料库质量研究
- 异常检测基准测试
- 数据清洗流程开发
数据清洗流程
语料库经过多阶段质量管道处理,包括:
- JSON合并验证
- 翻译缓存合并
- 去重
- 普什图语提取
- 基于长度的过滤
- 标记重复检测
- 英语泄漏检测
- 词汇异常检测
- 质量评分
- 干净数据集与异常数据集拆分
作者
- 作者: Nassim Nasibullah
- 机构: Spinzar Enterprises Inc. (Yūgen Kaisha), Japan
引用信息
bibtex @dataset{english_pashto_parallel_corpus_2026, author = {Nassim Nasibullah}, title = {English--Pashto Parallel Corpus}, year = {2026}, publisher = {Hugging Face}, journal = {Hugging Face Datasets}, url = {https://huggingface.co/datasets/nassimjp/english_pashto_parallel-corpus} }