遇见数据集

logicwaver-reasoning-v1

收藏
Hugging Face2026-08-19 更新2026-08-20 收录
官方服务:

资源简介:

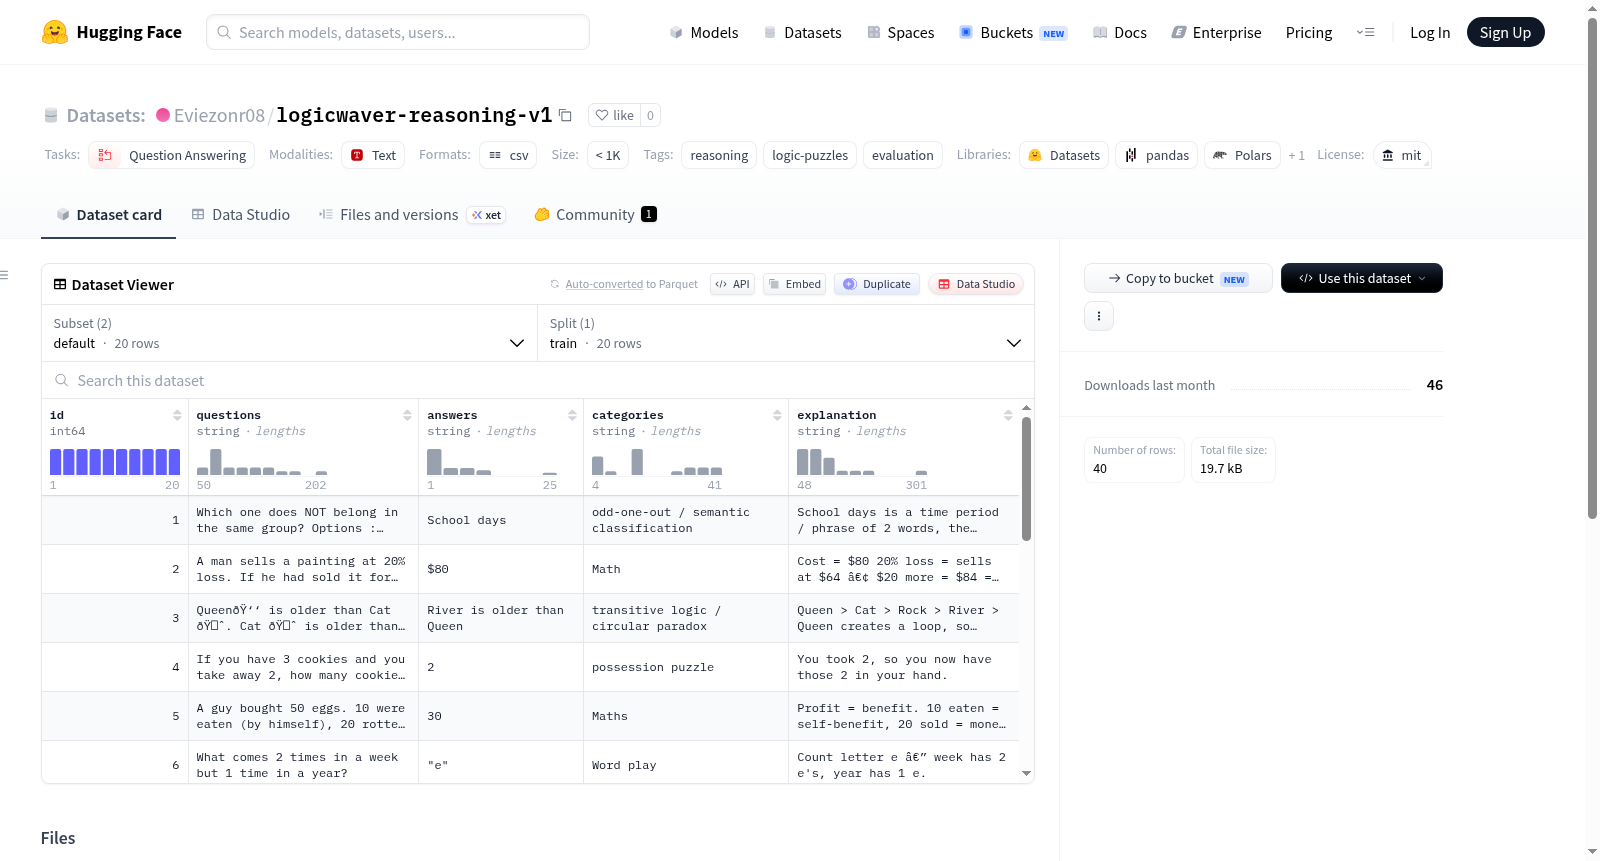
LogicWaver Reasoning v1 是一个精心策划和验证的逻辑谜题数据集,包含 20 个谜题。每个谜题都配有手动编写的解释和推理轨迹,旨在用于评估大型语言模型(LLM)的推理能力。数据集提供了两个 CSV 文件:一个仅包含谜题(用于评估),另一个包含相同的谜题并附有推理轨迹(用于分析推理过程)。谜题类型为“找出不属于同一组”的逻辑分类问题,涉及词汇、概念等。该数据集适用于问答、逻辑推理评估等任务。

LogicWaver Reasoning v1 is a carefully curated and validated logical puzzle dataset containing 20 puzzles. Each puzzle is accompanied by manually written explanations and reasoning traces, designed to evaluate the reasoning capabilities of large language models (LLMs). The dataset provides two CSV files: one containing only the puzzles (for evaluation) and another containing the same puzzles with reasoning traces (for analyzing the reasoning process). The puzzle type is a logical classification problem of find the one that does not belong to the same group, involving vocabulary, concepts, etc. This dataset is suitable for tasks such as question answering and logical reasoning evaluation.

创建时间:
2026-08-15
原始信息汇总

数据集概述

LogicWaver Reasoning v1 是一个专为评估大语言模型(LLM)推理能力而设计的高质量逻辑谜题数据集,包含 20 个经过人工筛选与验证的谜题,并配有手动编写的解释与推理轨迹。


数据集内容

文件路径 描述
Reasoning_Puzzle_without_proline.csv 20 个用于评估的谜题(无推理轨迹)
with_proline/Reasoning_Puzzle_proline.csv 相同的 20 个谜题,附加 pro_line 推理轨迹

数据示例

问题: 以下哪一项不属于同一类?
Cookies / School-days / Rock / Queen / Freezer

答案: School days
解释: 其余四项均为单字名词,而 "School days" 是由两个词组成的时间段。


使用方式

可通过 Hugging Face datasets 库直接加载:

python from datasets import load_dataset ds = load_dataset("Eviezonr08/logicwaver-reasoning-v1")


数据集属性

  • 许可协议: MIT License
  • 标签: reasoning、logic-puzzles、evaluation
  • 任务类型: 问答(question-answering)
搜集汇总
数据集介绍
logicwaver-reasoning-v1 数据集图片
构建方式
该数据集精心构筑于逻辑推理与谜题解答的交叉领域,其构建过程融合了认知科学与自然语言处理的先进理念。基础版本收录了20个精挑细选的推理谜题,每个谜题均以自然语言提问形式呈现,并附有标准答案及简明扼要的解析说明。为深化推理过程的透明度,数据集增设了扩展配置,对同一组谜题补充了逐步推理轨迹(pro_line),形成对照版本。这种设计使得数据集既可用于直接评估模型的终局答案正确性,亦能探究模型在推理路径上的逻辑连贯性。
特点
该数据集的核心特质在于其双重结构设计,兼顾了评估的简洁性与诊断的深度。基础配置聚焦于20个独立的逻辑分类难题,如从一组词语中甄别异类,考验模型的模式识别与语义理解能力。扩展配置则引入分步推理链,为每个问题提供细粒度的思维过程样本,便于研究者剖析模型决策依据。此外,数据集采用MIT许可协议,彻底开放使用权限,配合标准化的HuggingFace加载接口,使其成为逻辑推理评测与可解释性研究的理想基准。
使用方法
使用者可通过HuggingFace datasets库一键加载,默认配置直接获取无推理轨迹的训练集,适用于快速基准测试。若需深入研究推理机制,可指定with_proline配置以获取包含逐步推理过程的数据版本。该数据集设计为评估集,现成的示例格式(问题、答案、解释)允许直接将其输入至问答系统或语言模型,通过比较模型输出与标准答案及解释,可量化推理准确性与解释质量。借助其简洁的数据结构与开源的许可证,研究者亦能灵活扩展或定制数据集以适应特定实验需求。
背景与挑战
背景概述
逻辑推理作为人工智能的核心能力之一,其评估与提升一直是自然语言处理领域的关键课题。logicwaver-reasoning-v1数据集由研究人员Eviezonr08于近期构建,旨在为逻辑谜题提供标准化的评测基准。该数据集包含20个精心设计的推理问题,覆盖分类、类比等多种逻辑类型,并附有详细的推理轨迹(pro_line),为模型的可解释性分析提供了宝贵资源。其发布填补了小型、高难度逻辑推理数据集的空白,对推动推理模型的发展具有重要意义。
当前挑战
该数据集所应对的领域挑战在于,现有推理数据集多集中于常识问答或简单逻辑,难以有效区分模型的真实推理能力与表面记忆。本数据集通过设计具有高区分度的谜题,迫使模型进行深层次语义分析与逻辑归纳,从而暴露其在抽象推理上的不足。构建过程中,挑战在于确保谜题的严谨性与唯一解性,同时避免语言歧义和常识偏置,此外还需提供清晰且多样化的推理链,以支持后续的推理过程评估与鲁棒性研究。
常用场景
经典使用场景
logicwaver-reasoning-v1数据集作为一项精心构筑的推理评估基准,其经典使用场景聚焦于检验和强化语言模型的抽象逻辑推理能力。该数据集涵盖20道匠心独运的谜题,每题要求模型在纷繁选项中辨识出不符合既定归类的条目,并辅以简洁的语义解释,从而驱动模型超越表面词汇匹配,深入概念层级进行类比与排除。这种任务设计旨在模拟人类在日常生活与学术探究中所倚重的发散性思维,为衡量模型在非结构化推理路径上的表现提供了严谨的标尺。研究者和开发者常借此数据集对预训练模型进行零样本或少样本的推理测试,亦或作为微调阶段的验证集,以透视模型在逻辑一致性上的短板与潜力。
衍生相关工作
围绕logicwaver-reasoning-v1,研究者已衍生了若干富有启发性的工作脉络。首要方向是将该数据集融入多任务学习框架,与因果推理、常识问答等基准联合训练,催生了可迁移的思维链提示优化方案。其次,基于其谜题结构,出现了若干探究模型注意力分布与解释一致性关系的实证研究,这些工作揭示了注意力权重与推理路径间的潜在耦合,并提出了注意力蒸馏以强化可解释性。再者,该数据集的以谜题形式,也激发了对抗性样本生成与鲁棒性增强的研究,衍生出自动构造语义扰动以测试模型盲区的工具链。这些衍生工作共同构筑了围绕逻辑评估的学术生态,进一步验证了该数据集的基准价值与拓展潜力。
数据集最近研究
最新研究方向
该数据集聚焦于逻辑推理与常识判断的评估,其最新研究动向体现在对非典型分类任务的深度剖析上。通过引入'proline'推理轨迹,研究者正探索将隐式思维链显性化,以强化模型在复杂语义迷宫中的解释性。这一方向与当前大语言模型可解释性研究的热点不谋而合,旨在揭示模型在应对反常识逻辑陷阱时的内在决策机制。数据集的精巧设计,如对词语间抽象关系的考察,不仅为夯实推理基准提供了微妙的试金石,更推动了从静态问答向动态认知模拟的范式转型,其影响辐射至教育评估、认知科学仿真及下一代AI的稳健性验证,意义深远。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务