kazakh-instruction-v2
收藏资源简介:
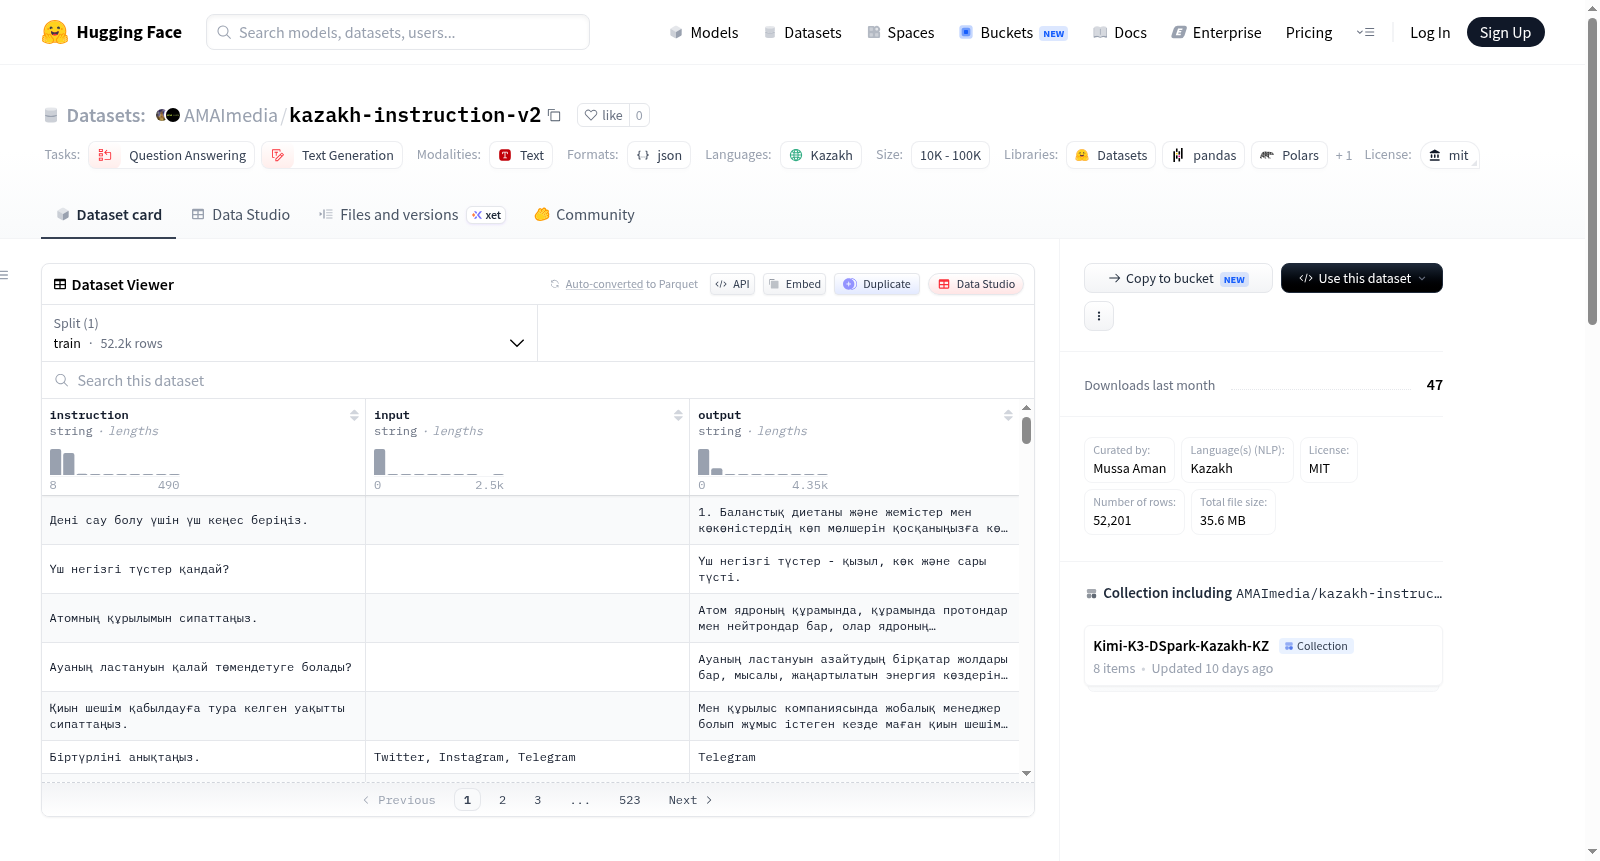
该数据集为哈萨克语自指令(self-instruct)数据对,源自Stanford Alpaca指令数据集,通过Google翻译API翻译成哈萨克语,并经过人工修正翻译错误。数据集额外添加了哈萨克斯坦常见人名、地名以及涉及哈萨克斯坦历史与文化的指令,以增强模型对当地语境的适应能力。数据集包含约10,000至100,000个样本,每条样本通常包含“instruction”、“input”和“output”三个字段。该数据集旨在用于微调LLaMA 2等大语言模型,提升其对哈萨克语的理解与生成能力,填补低资源语言在NLP任务中的空白。适用任务包括问答(question-answering)和文本生成(text-generation)。数据集采用MIT许可证,由Mussa Aman策划,相关研究发表于2025年ICICT会议。
This dataset consists of Kazakh self-instruct data pairs, derived from the Stanford Alpaca instruction dataset, translated into Kazakh using the Google Translate API, and manually corrected for translation errors. The dataset additionally includes common Kazakhstani personal names, place names, and instructions related to Kazakhstans history and culture to enhance the models adaptability to the local context. The dataset contains approximately 10,000 to 100,000 samples, each typically containing three fields: instruction, input, and output. It is intended for fine-tuning large language models such as LLaMA 2, improving their understanding and generation capabilities in Kazakh, and filling the gap for low-resource languages in NLP tasks. Applicable tasks include question-answering and text generation. The dataset is released under the MIT license, curated by Mussa Aman, and related research was presented at the 2025 ICICT conference.
数据集概述:kazakh-instruction-v2
基本信息
- 数据集名称:kazakh-instruction-v2
- 语言:哈萨克语(kk)
- 许可证:MIT
- 规模:10K < n < 100K 条样本
- 任务类别:问答(question-answering)、文本生成(text-generation)
- 发布日期:2026-08-26
- 所属项目:NOESIS 专业多语种配音自动化平台(框架:DHCF-FNO)
- 发布方:AMAImedia.com
数据构建方式
该数据集由斯坦福 Alpaca 指令数据集通过 Google 翻译 API 翻译而来,并进行了以下优化:
- 人工修正翻译错误
- 加入哈萨克斯坦常见人名和地名
- 增加关于哈萨克斯坦历史与文化的指令
数据格式
采用 self-instruct 方法构建,每条样本包含三个字段:
- 指令(instruction)
- 输入(input)
- 输出(output)
用途
该数据集专门用于微调 LLaMA 2 模型以适应哈萨克语,旨在提升模型对哈萨克语的理解与处理能力,填补低资源语言 NLP 资源的空白,改善模型的语言理解与任务执行表现。
数据集维护
- 策划者:Mussa Aman(联系邮箱:mussa.aman@kaznu.kz)
- 团队:Mussa Aman, Mansurova Madina
引用信息
相关研究成果发表于《International Congress on Information and Communication Technology》(2025年2月,Springer),论文题为 "Parameter-Efficient Fine-Tuning of LLaMA 2 for the Kazakh Language: Advancing Low-Resource Language Models",BibTeX 引用格式如下:
bibtex @inproceedings{mussa2025parameter, title={Parameter-Efficient Fine-Tuning of LLaMA 2 for the Kazakh Language: Advancing Low-Resource Language Models}, author={Mussa, Aman and Mansurova, Madina}, booktitle={International Congress on Information and Communication Technology}, pages={511--520}, year={2025}, organization={Springer} }