
politico_eu
收藏官方服务:
资源简介:
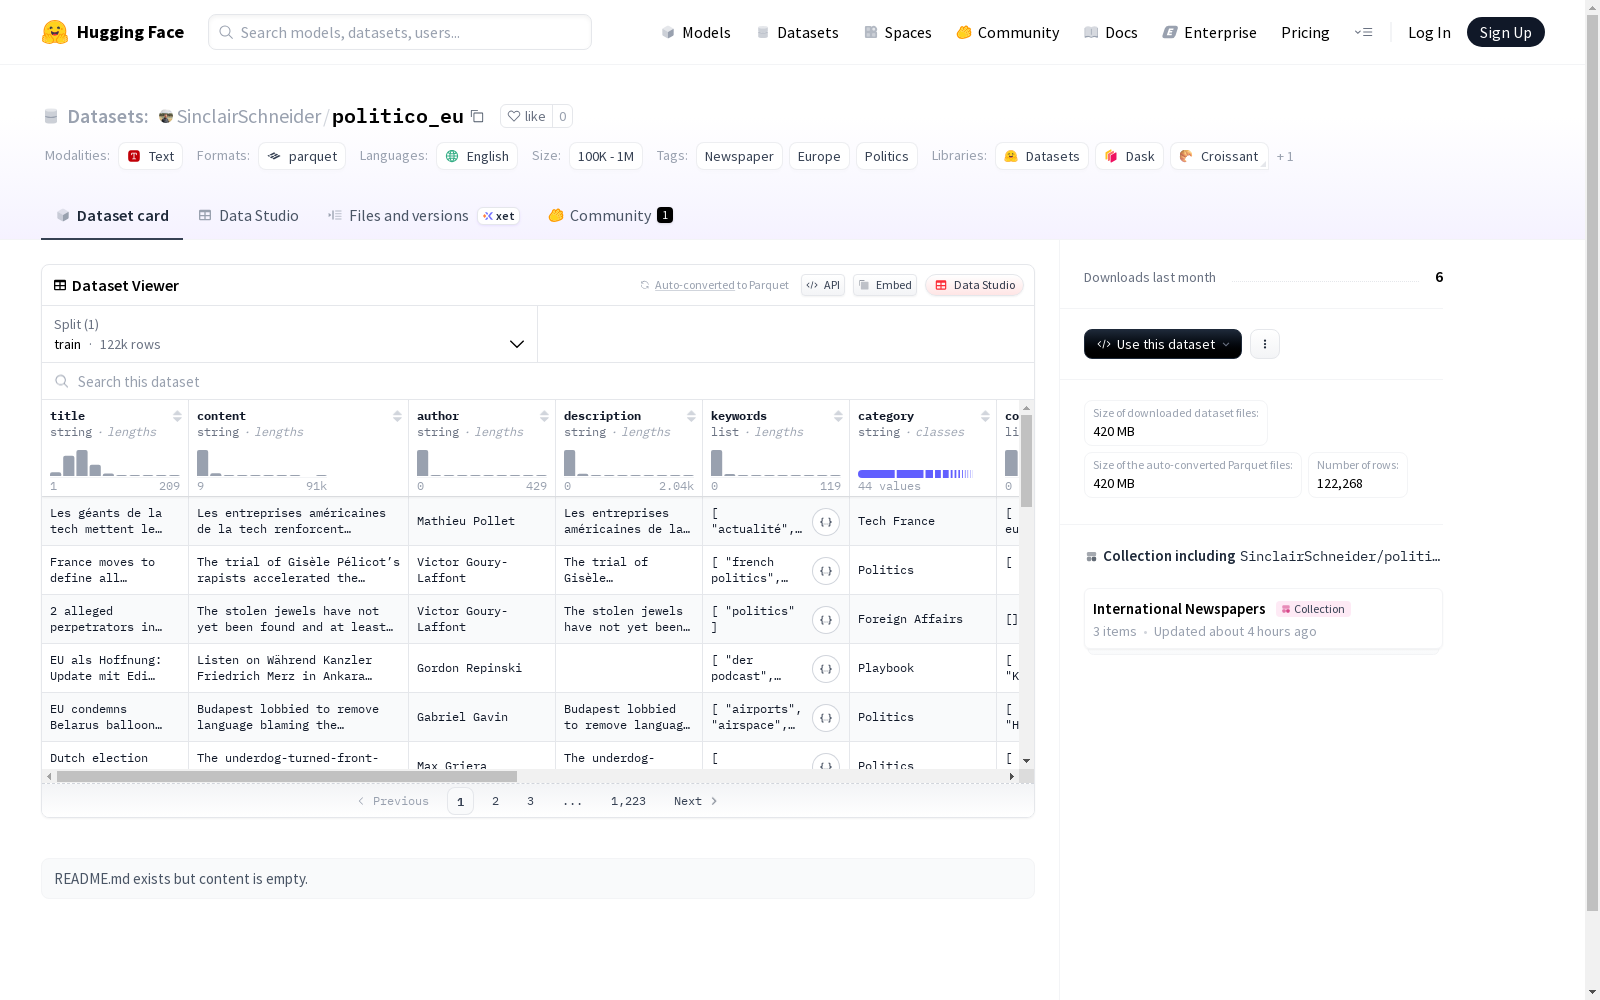
这是一个包含新闻文章的数据集,其中包括标题、内容、作者、描述、关键词、分类、国家、创建日期、发布日期、修改日期、帖子ID和链接等信息。数据集主要关注报纸、欧洲和政治主题,适用于训练相关模型的任务。
This is a dataset consisting of news articles, which includes information such as title, content, author, description, keywords, category, country, creation date, publication date, modification date, post ID and link. This dataset primarily focuses on newspaper, European and political topics, and can be utilized for training tasks of relevant models.
创建时间:
2025-10-29
原始信息汇总
数据集概述
基本信息
- 数据集名称: politico_eu
- 语言: 英语
- 数据规模: 100K<n<1M
- 标签: Newspaper, Europe, Politics
数据结构
特征字段
- title: 字符串类型
- content: 字符串类型
- author: 字符串类型
- description: 字符串类型
- keywords: 字符串序列
- category: 字符串类型
- countries: 字符串序列
- dateCreated: 字符串类型
- datePublished: 字符串类型
- dateModified: 字符串类型
- post_id: 整型
- url: 字符串类型
数据划分
- 训练集: 120,817个样本
- 训练集大小: 707,521,304字节
- 下载大小: 415,259,917字节
- 数据集大小: 707,521,304字节
数据来源
- 主题领域: 欧洲政治新闻报道
- 内容类型: 报纸文章
搜集汇总
数据集介绍
构建方式
在政治新闻分析领域,Politico EU数据集通过系统采集欧洲政治新闻门户Politico Europe平台上的多维度内容构建而成。该数据集涵盖标题、正文、作者信息、摘要描述等结构化字段,并采用自动化流程提取关键词、分类标签及关联国家等元数据,确保数据来源的权威性与时效性。所有条目均保留完整的发布时间戳与唯一标识符,形成规模达12万余条记录的标准化语料库。
特点
该数据集以多语言欧洲政治文本为核心特色,兼具丰富的语义标注与地理关联属性。每条记录不仅包含完整的新闻内容与元数据,还通过关键词序列和分类体系呈现主题分布,其国家字段更精准映射地域政治脉络。数据规模达到十万级以上,覆盖欧盟政策、国际关系等垂直领域,为跨区域政治语言研究提供高粒度分析基础。
使用方法
研究者可借助该数据集开展政治文本挖掘、媒体立场分析与地域政策研究。通过解析标题与正文的语义关联,结合分类标签与国家元数据,能够构建政治话题演化模型或地域舆论图谱。建议优先利用训练集进行自然语言处理任务,如结合时间序列分析政策趋势,或基于关键词网络挖掘跨国家议题关联性。
背景与挑战
背景概述
POLITICO EU数据集作为欧洲政治新闻领域的重要语料库,由POLITICO欧洲版于2015年创立,标志着数字新闻档案系统化建设的里程碑。该数据集汇聚了布鲁塞尔总部及其泛欧记者网络采集的深度政治报道,核心研究聚焦于欧盟政策制定、跨国选举分析与地缘政治动态的文本挖掘。其结构化存储的新闻要素包括标题、作者、国别标签与时间戳,为计算社会科学提供了跨时段政策演变研究的基准数据,显著推动了欧洲政治话语量化分析范式的演进。
当前挑战
在政治新闻文本挖掘领域,该数据集需应对多语言语境下术语对齐的复杂性,以及欧盟政策文本中隐含立场识别的语义鸿沟。数据构建过程中面临三重挑战:其一是跨国报道的属地标注需协调不同国家的行政边界定义标准;其二是动态更新的新闻内容要求持续维护时间序列的一致性;其三是敏感政治表述的伦理边界界定需要平衡信息完整性与隐私保护规范。
常用场景
经典使用场景
在政治传播学与计算社会科学领域,politico_eu数据集作为欧洲政治新闻的权威语料库,常被用于训练和评估自然语言处理模型。其多语言新闻文本与结构化元数据支持跨语言政治倾向分析、事件时序建模等任务,为研究欧洲一体化进程中的媒体叙事演变提供了标准化基准。
解决学术问题
该数据集有效解决了欧洲政治实体识别、跨国政策传播路径追踪等学术难题。通过标注国家、分类标签与时间维度,使研究者能量化分析欧盟决策的媒体覆盖偏差,验证议程设置理论在欧洲多语种环境下的适用性,填补了跨司法管辖区比较政治研究的语料空白。
衍生相关工作
基于该数据集衍生的经典研究包括欧盟立法文本对齐项目EuroParl的扩展工作,以及多模态政治话语分析框架POLITICS-NLP。这些成果不仅构建了欧洲政治实体链接知识图谱,还推动了跨语言预训练模型如BERTurk在欧洲语境下的适应性优化。
以上内容由遇见数据集搜集并总结生成


