
Ba2han/Forgotten_Realms-0.1
收藏官方服务:
资源简介:
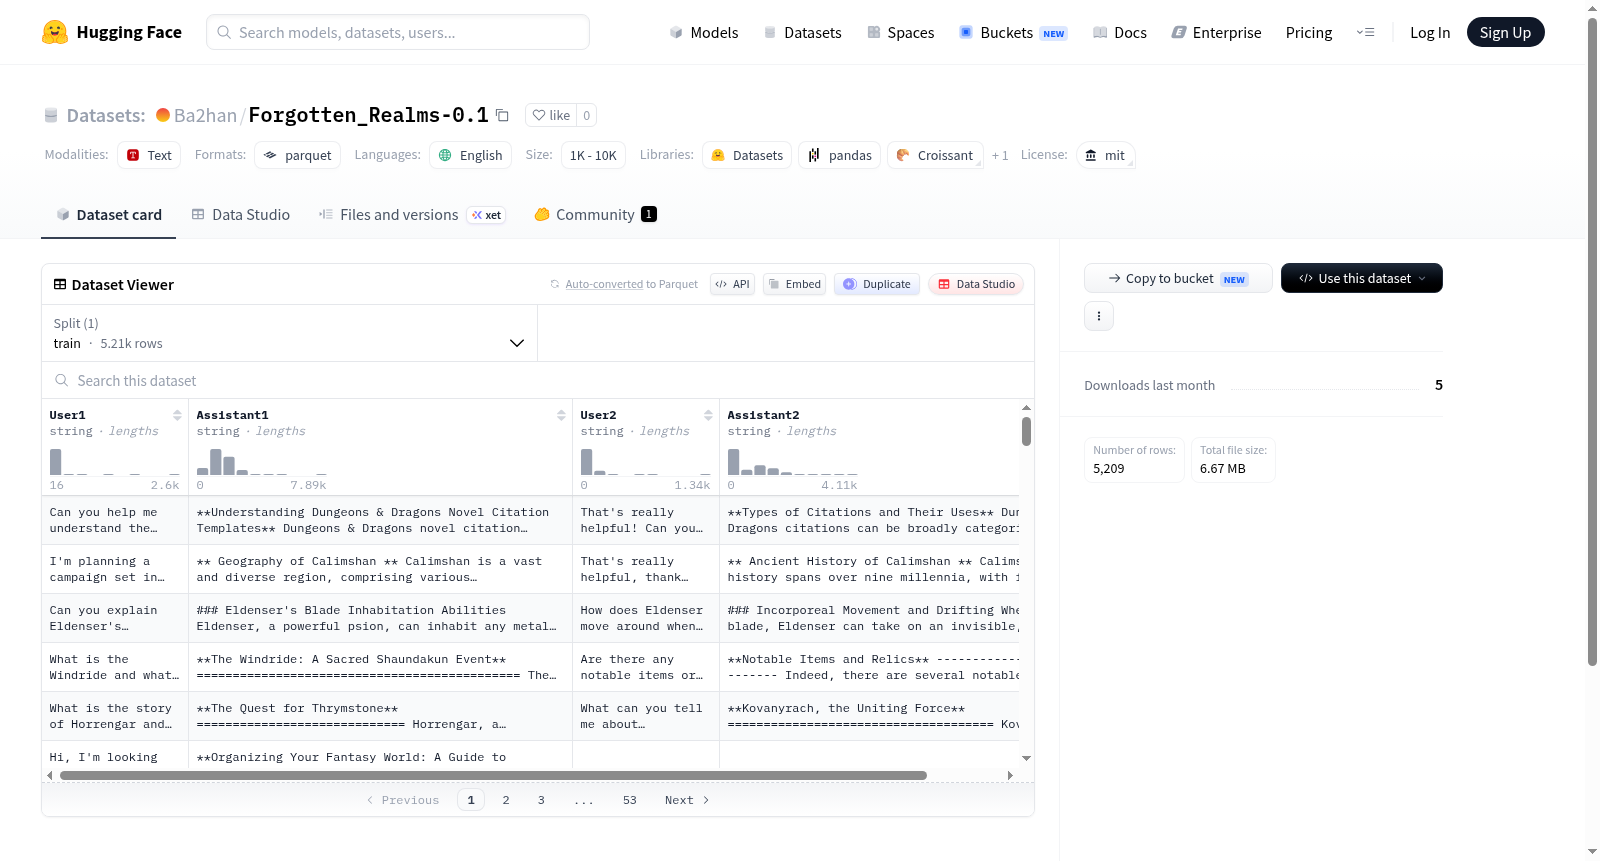
该数据集包含5.2k行的单轮和多轮合成Forgotten Realms数据,部分数据是通过Groq的Llama-3-70B和作者的WIP数据集创建者微调生成的。
The dataset contains 5.2k rows of single and multi turn synthetic Forgotten Realms data, partially produced with Groqs Llama-3-70B and my WIP dataset creator fine-tune.
提供机构:
Ba2han原始信息汇总
数据集概述
基本信息
- 名称: Forgotten_Realms-0.1
- 别名: Ba2han/Forgotten_Realms-0.1
- 描述: 包含5.2k行单轮和多轮的合成Forgotten Realms数据。部分数据由Groq的Llama-3-70B和正在开发的定制数据集创建器生成。
- 创建者: Batuhan S
- 网址: Forgotten_Realms-0.1
- 许可证: MIT许可证 (详情)
数据格式
- 分布:
数据字段
- 记录集:
- 名称: default
- 描述: Ba2han/Forgotten_Realms-0.1的default子集
- 字段:
- User1:
- 描述: HF Mirror Parquet文件中的User1列。
- 数据类型: 文本
- Assistant1:
- 描述: HF Mirror Parquet文件中的Assistant1列。
- 数据类型: 文本
- User2:
- 描述: HF Mirror Parquet文件中的User2列。
- 数据类型: 文本
- Assistant2:
- 描述: HF Mirror Parquet文件中的Assistant2列。
- 数据类型: 文本
- User1:
关键词
- English
- mit
- 1K - 10K
- parquet
- Text
- Datasets
- pandas
- Croissant
- 🇺🇸 Region: US
符合标准
搜集汇总
数据集介绍
构建方式
在奇幻文学与角色扮演游戏交织的领域,Forgotten Realms作为经典设定,其对话数据的稀缺性制约了相关语言模型的领域适应能力。Ba2han/Forgotten_Realms-0.1数据集应运而生,它通过合成数据生成技术构建,融合了Groq平台上的Llama-3-70B模型与作者正在研发的数据集创建微调模型。这种半自动化流程模拟了被遗忘国度中的单轮与多轮对话场景,最终产出约5200条高质量样本,覆盖了该世界观下的多元交互模式。
特点
该数据集的核心特质在于其领域专精性与结构多样性。作为首个专注于被遗忘国度背景的合成对话数据集,它精准捕捉了奇幻世界中的语言风格、角色互动与叙事逻辑。数据规模虽仅数千条,却巧妙平衡了单轮问答的简洁性与多轮对话的上下文连贯性,为领域微调提供了兼具深度与广度的训练素材。其MIT开源许可更降低了学术与商业应用的门槛。
使用方法
在应用层面,该数据集可直接用于指令微调或领域适配任务。使用者可将其加载至Hugging Face的datasets库中,通过简单的API调用获取格式化对话对。建议结合原版Llama-3或同类基础模型进行监督式微调,以强化模型在奇幻文本生成、角色扮演或任务导向对话中的表现。对于多轮对话部分,可设计滑动窗口策略以充分利用长程依赖关系。
背景与挑战
背景概述
在角色扮演游戏与自然语言处理交叉领域,高质量、主题化的对话数据集对于训练能够理解虚构世界语境的语言模型至关重要。Ba2han/Forgotten_Realms-0.1数据集由研究人员于近期创建,基于经典的“被遗忘的国度”战役设定,旨在提供5.2k条单轮与多轮合成对话数据。该数据集的核心研究问题聚焦于如何利用大语言模型生成符合特定奇幻世界观的多轮交互文本,以弥补真实角色扮演对话数据的稀缺性。部分数据通过Groq的Llama-3-70B模型及一个自研的数据集创建微调模型生成,体现了从通用语言模型向领域定制化数据生产的探索。这一成果为后续在虚构叙事、游戏AI及交互式故事生成等方向的研究奠定了数据基础。
当前挑战
数据集面临的核心挑战首先在于领域适配问题:通用语言模型生成的合成对话可能缺乏“被遗忘的国度”特有的种族、魔法与地理细节的深度一致性,导致语义偏差。构建过程中,如何确保单轮与多轮对话的逻辑连贯性及角色个性稳定性是一大难题,尤其当涉及复杂剧情分支时。此外,合成数据存在引入模型偏见或重复模式的风险,可能影响下游任务的泛化能力。数据规模较小(1K-10K)也限制了训练效果,需进一步扩展以覆盖更丰富的场景。最终,缺乏人工校验的纯合成流程对数据质量形成严峻考验,需平衡自动化效率与真实感。
常用场景
经典使用场景
在奇幻文学与角色扮演游戏领域,Forgotten Realms(被遗忘的国度)作为经典背景设定,承载着丰富的叙事与对话逻辑。Ba2han/Forgotten_Realms-0.1数据集以5.2k条单轮与多轮对话组成,其合成数据源自Groq的Llama-3-70B模型及专有微调工具,旨在为基于该世界观的智能对话系统提供训练素材。经典使用场景集中于构建沉浸式虚拟角色,例如模拟NPC(非玩家角色)的互动、任务引导或剧情推进,使语言模型能够理解并生成符合Forgotten Realms文化、地理与魔法体系的响应。该数据集通过结构化对话片段,强化了模型在虚构语境下的上下文连贯性与角色一致性,为奇幻题材的交互式叙事研究奠定数据基础。
解决学术问题
在自然语言处理与计算叙事学交叉研究中,如何让模型掌握特定虚构世界的知识体系并维持对话一致性,是长期存在的学术挑战。Ba2han/Forgotten_Realms-0.1通过合成数据填补了高领域性、低资源场景下的训练空白,解决了传统数据集因版权或复杂性难以覆盖奇幻设定深度的问题。其意义在于提供可复现的方法论,证明大语言模型在辅助生成结构化虚构语料方面的可行性,从而推动知识蒸馏与领域自适应研究。该数据集的影响体现在促进多轮对话中的长期依赖建模,以及评估模型对隐含世界规则(如魔法限制、种族特性)的推理能力,为跨域语言理解提供理论参考。
衍生相关工作
该数据集衍生的经典工作包括基于Llama-3-70B的领域微调管线研究,以及合成数据质量评估框架的开发。研究者可能借鉴其方法论,构建类似设定(如中土世界或艾泽拉斯)的对话数据集,推动多世界知识迁移的基准测试。此外,针对合成数据中的幻觉问题,相关工作可能聚焦于事实性约束与一致性验证算法,例如通过对比真实Forgotten Realms文献(如《被遗忘的国度战役设定集》)来净化模型输出。在模型架构层面,该数据集或催生记忆增强网络与动态知识图谱的融合,以支持更长篇幅的叙事对话,最终形成一套从数据生成到应用验证的标准化流程。
以上内容由遇见数据集搜集并总结生成


