FlowBench
收藏资源简介:
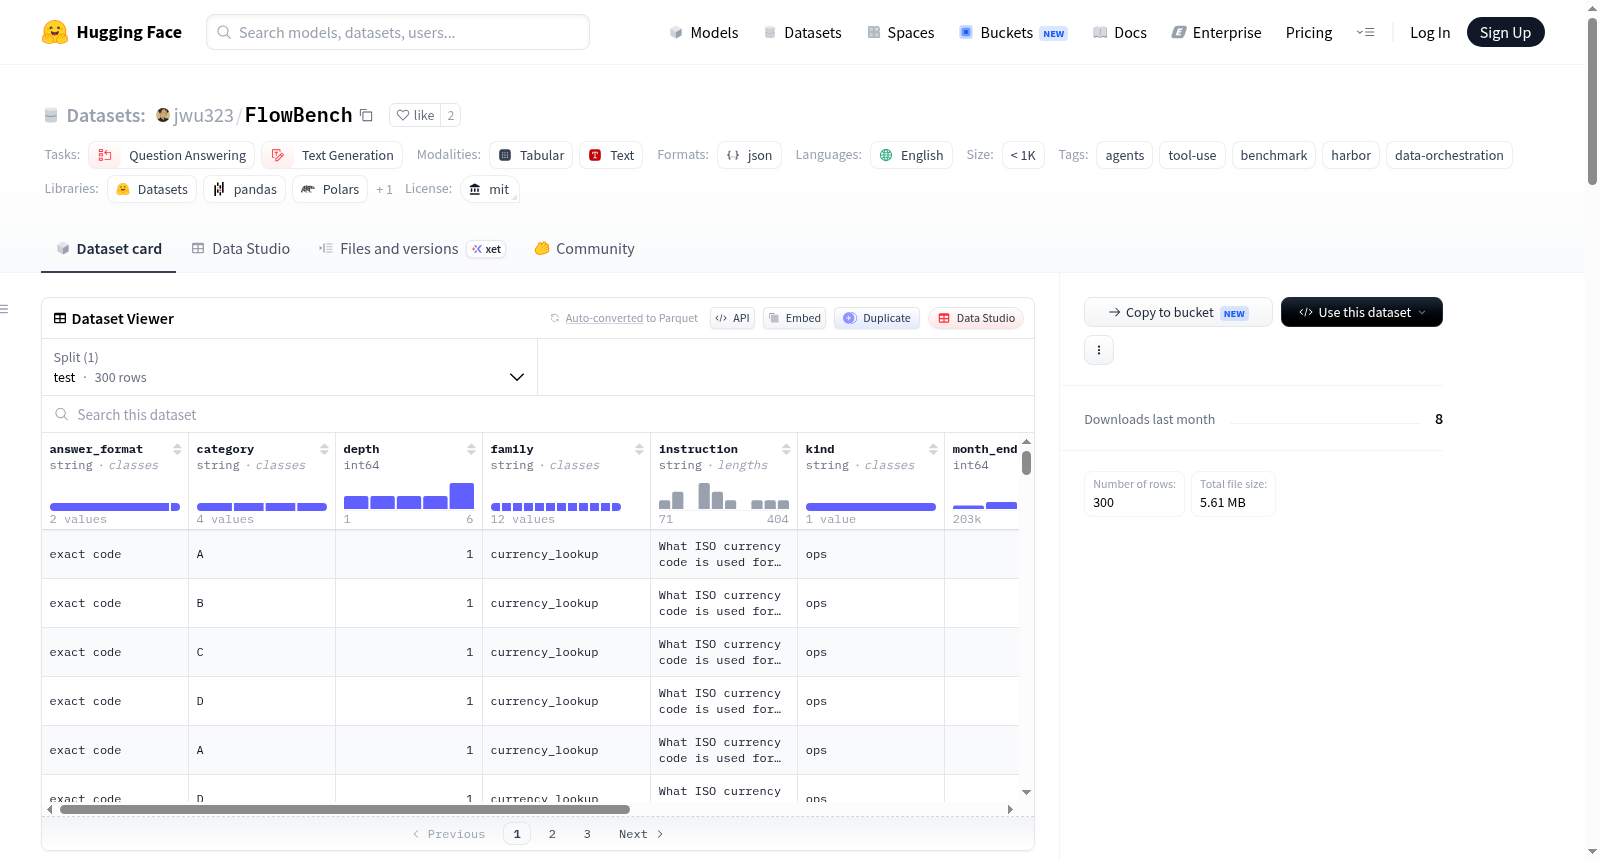
FlowBench是一个用于评估智能代理在组合使用Python工具解决商业运营问题方面能力的基准测试数据集。数据内容围绕模拟的商业实体生成,包括客户、产品、订单、退货、库存、支持工单、外汇汇率和服务等级协议(SLA)政策。数据集包含300个无标准答案的任务规范,分为6个深度级别(从1到6级,每个级别50个任务),涵盖从单步查询到多步复杂工作流的多种场景。任务进一步归属于12个不同的任务族,每个族有25个任务。数据以JSONL格式提供,每条记录包含任务ID、深度、所属族、指令、答案格式及相关参数,但不包含黄金标准答案。底层数据通过确定性代码在内存中生成,确保跨机器运行的一致性。该数据集适用于研究和评估不同代理接口在表达相同工具能力时的表现,主要用于任务检查、代理集成和可复现的冒烟测试。
FlowBench is a benchmark dataset designed to evaluate the ability of intelligent agents to combine Python tools for solving business operation problems. The data content is generated around simulated business entities, including customers, products, orders, returns, inventory, support tickets, foreign exchange rates, and service level agreement (SLA) policies. The dataset contains 300 task specifications without standard answers, divided into 6 depth levels (from level 1 to 6, with 50 tasks per level), covering various scenarios from single-step queries to multi-step complex workflows. Tasks are further categorized into 12 different task families, each with 25 tasks. The data is provided in JSONL format, with each record containing task ID, depth, family, instruction, answer format, and related parameters, but explicitly excluding gold standard answers. The underlying data is generated in memory via deterministic code to ensure consistency across machines. This dataset is suitable for researching and evaluating the performance of different agent interfaces when expressing the same tool capabilities, primarily used for task inspection, agent integration, and reproducible smoke testing.
FlowBench 数据集概述
FlowBench 是一个面向确定性业务流程的工具使用基准测试(tool-use benchmark),其数据集 ID 为 jwu323/FlowBench。每个任务要求智能体(agent)基于合成数据(客户、产品、订单、退货、库存、支持工单、外汇汇率和 SLA 政策)组合调用 Python 工具来完成。
数据集属性
- 许可证:MIT
- 任务类型:问答、文本生成
- 语言:英语
- 数据集大小:小于 1K 样本
- 标签:agents, tool-use, benchmark
数据划分
公开版本仅包含 test 划分,共 300 个任务,按任务深度分为 6 个层级:
| 深度 | 任务数 | 描述 |
|---|---|---|
| 1 | 50 | 单步查询(如区域货币、畅销产品 ID) |
| 2 | 50 | 过滤后的订单和客户计数 |
| 3 | 50 | 收入和退款率聚合 |
| 4 | 50 | 本地货币转换及退款后利润计算 |
| 5 | 50 | 补货短缺和延迟订单收入工作流 |
| 6 | 50 | 延迟履行及 SLA 违规风险收入 |
所有任务按 12 个任务家族分布,每个家族 25 个任务。
数据文件
data/test.jsonl:无答案的任务记录,每条记录包含task_id、depth、family、region、category、month_start、month_end、instruction和answer_format。tools/flowbench_tools.py:确定性工具实现,智能体可直接调用。harbor/:Harbor 兼容的公共任务包,包含形状验证器(非正式评分)。RUN.md:将数据连接到 LLM 智能体并生成预测文件的说明。
数据生成方式
无外部数据源。数据由 tools/flowbench_tools.py 在导入时通过 SHA-256 确定性生成内存表(72 个客户、48 个产品、720 个订单、180 个退货、260 个支持工单等)。相同文件在不同机器上生成相同数据。
任务家族(共 12 个)
currency_lookuptop_product_lookuporder_countunique_customer_countnet_revenue_usdrefund_share_bplocal_net_revenuemargin_after_refundsreorder_shortfalldelayed_net_revenuedelay_sla_burdenbreached_ticket_revenue
使用说明
- 智能体运行:为智能体提供一条任务记录(来自
data/test.jsonl),仅暴露tools/flowbench_tools.py中的函数,要求智能体按照answer_format返回最终答案。 - 推荐预测格式:
{"task_id": "...", "answer": "...", "model": "..."} - Harbor 烟雾测试:运行
harbor run -p harbor -a <agent> -l 1,仅检查输出形状而非正确性。
评分说明
公开版本不包含标准答案或严格验证器。正式评分需使用私有评估器或生成新的留出测试集。